
容器与云原生 / 系统课时
应用应该自己具备重试能力吗
应用应该自己具备重试能力吗
Docker Compose 可以控制容器的启动依赖,但它不能保证依赖服务在整个运行期始终可用。本篇要解决的是:为什么应用仍应具备受控重试,以及怎样区分“值得重试的短暂故障”和“应该立即失败的配置错误”。
学习目标
- 说明
depends_on、健康检查与应用重试各自解决的问题 - 设计有上限、可观测且不会无限放大故障的连接重试
- 判断哪些错误适合重试,哪些错误应直接暴露并修复
启动顺序不能替代运行期容错
即使 Compose 等到数据库健康后再启动应用,数据库仍可能因为重启、主从切换、网络抖动或维护而短暂不可用。depends_on 主要解决启动阶段的编排关系,无法替应用处理启动后的连接中断。
反过来,只在应用里写“无限重试”也不合理。配置错误、密码错误、数据库名错误通常不会因为等待而自行恢复;持续重试只会延迟故障暴露,并不断制造连接和日志压力。
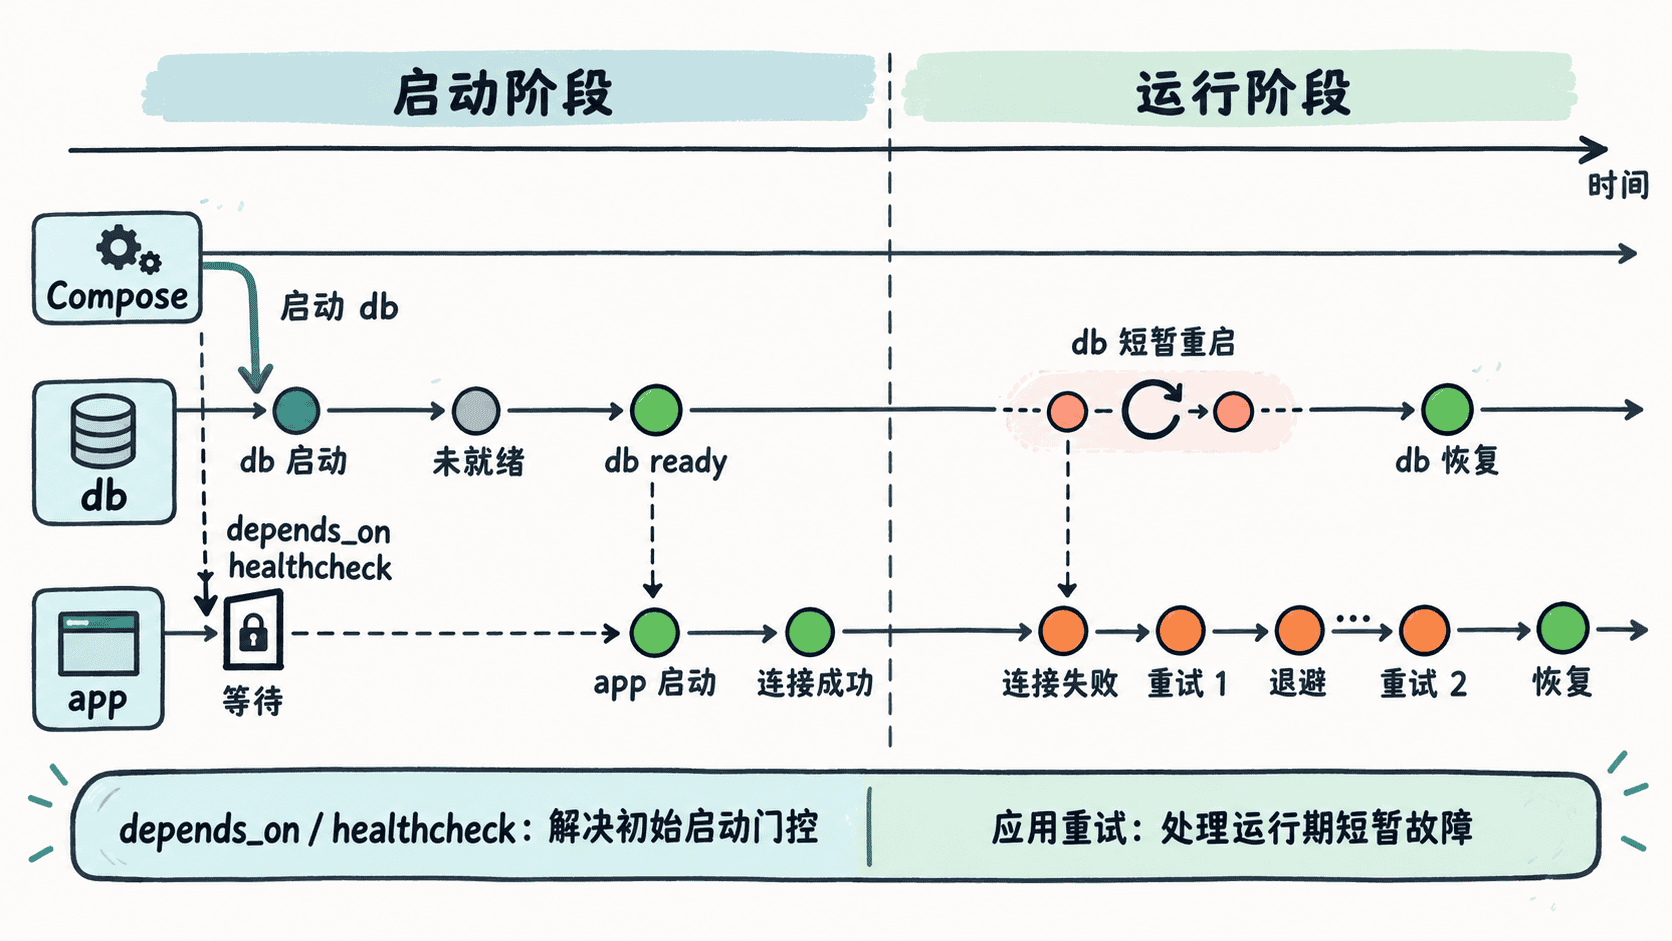
重试应该有明确边界
一个可接受的重试策略至少包含四个约束:只重试可恢复错误;设置最大次数或总时长;在尝试之间增加退避,避免高频打满依赖;每次失败都留下可观测信息。生产环境还常在指数退避上增加随机抖动,降低大量实例同时重连造成的“惊群”。
适合重试的通常是连接被拒绝、连接超时、依赖正在重启等短暂故障。认证失败、缺少必要环境变量、SQL 语法错误或不受支持的协议版本,更适合快速失败并让部署系统明确暴露问题。
用最小程序验证受控重试
下面的 Python 程序只使用标准库,尝试建立 TCP 连接。它不是数据库连接池的替代品,而是用来观察“失败几次后依赖恢复”这一行为。运行时通过 DB_HOST 和 DB_PORT 指定目标。
import os
import socket
import sys
import time

host = os.getenv("DB_HOST", "db")
port = int(os.getenv("DB_PORT", "5432"))
max_attempts = 5
delay_seconds = 2

for attempt in range(1, max_attempts + 1):
    try:
        with socket.create_connection((host, port), timeout=2):
            print(f"dependency ready: {host}:{port}")
            break
    except OSError as exc:
        print(f"attempt {attempt}/{max_attempts} failed: {type(exc).__name__}")
        if attempt == max_attempts:
            sys.exit(1)
        time.sleep(delay_seconds)
预期输出(依赖在前几次失败后恢复时):
attempt 1/5 failed: <ERROR_TYPE>
attempt 2/5 failed: <ERROR_TYPE>
dependency ready: db:5432
<ERROR_TYPE> 会随实际故障不同而变化,例如连接被拒绝或名称暂时无法解析。真正的数据库应用应优先使用驱动或连接池提供的重连机制,并让业务请求层知道最终失败,而不是把所有异常都吞掉。
Compose 与应用各自负责什么
Compose 更适合负责“容器何时启动、健康状态怎样暴露、失败后是否重启”;应用更适合负责“连接失败后怎样退避、哪些异常可恢复、何时停止重试并返回错误”。两者组合后,启动阶段更稳定,运行期短暂故障也不会因为一次连接失败就立即把整个服务判死。
判断原则可以很简单:如果故障可能在几秒到几十秒内自行恢复,就考虑有限重试;如果故障只有修改配置、凭据或代码后才能恢复,就应尽快失败。