
容器与云原生 / 系统课时
为什么每个服务都需要资源边界
为什么每个服务都需要资源边界
多服务长期运行时,最危险的不是某个容器单独变慢,而是一个服务突发占满 CPU 或内存,拖累数据库、缓存和宿主机。本节用三服务 Compose 场景建立资源边界,并学会从监控结果判断预算是否合理。
学习目标
- 解释未设置 CPU 与内存边界时,资源竞争为什么会扩散成整组故障。
- 区分 CPU 上限、内存硬限制与内存软保留的作用。
- 为数据库、应用和缓存设置起始资源预算,并观察实际使用量。
没有边界时,故障会相互放大
容器隔离了进程、网络和文件系统,但不会自动给每个服务划定合理的资源预算。未设置内存硬限制时,某个容器可以持续消耗宿主机可用内存;未设置 CPU 上限时,繁忙服务会与同机其他容器竞争处理器时间。
典型的连锁反应并不复杂:应用出现内存泄漏会压缩数据库和缓存的可用空间;数据库执行重查询会长期占用 CPU,应用请求因此排队;缓存批量加载数据又会进一步推高内存压力。单个服务的异常最终表现为整套 Compose 应用一起变慢,甚至触发宿主机级 OOM。
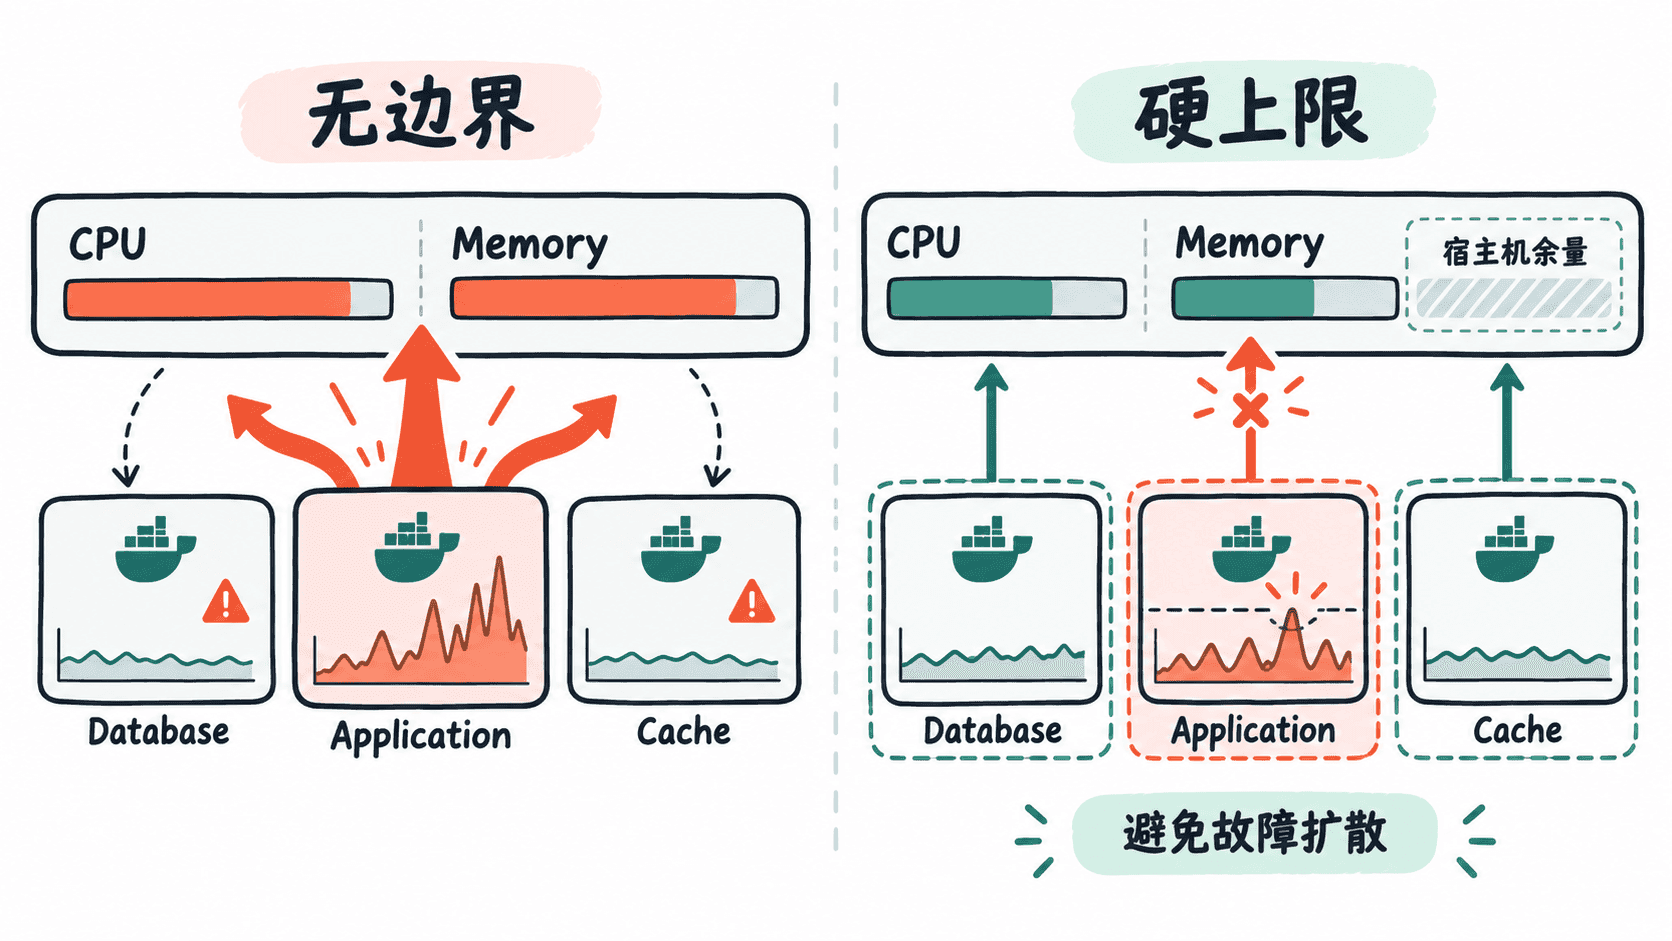
CPU 与内存边界约束的不是同一件事
| 边界 | Compose 常用字段 | 主要作用 | 超出后的典型表现 |
|---|---|---|---|
| CPU 上限 | cpus |
限制容器最多使用多少 CPU 核心时间 | 被调度器节流,通常表现为延迟增加 |
| 内存硬限制 | mem_limit |
限制容器可分配的内存 | 内存压力继续增长时可能触发 OOM kill |
| 内存软保留 | mem_reservation |
在内存竞争时提供软约束 | 不是硬上限,不能替代 mem_limit |
CPU 限制更像“限速”,服务通常仍能继续运行,只是吞吐和延迟受影响;内存硬限制则是容量边界,进程一旦无法继续获得内存,可能被内核终止。因此,长期运行服务通常需要同时考虑 CPU 和内存,而不是只限制其中一种资源。
给三个服务设置起始预算
下面的 compose.yaml 给应用、缓存和数据库分别设置 CPU 与内存上限。数值只是便于实验的起点,生产环境应根据压测和历史监控重新确定。
services:
  app:
    image: nginx:alpine
    cpus: 0.50
    mem_limit: 128m

  cache:
    image: redis:7-alpine
    cpus: 0.25
    mem_limit: 96m

  db:
    image: postgres:18-alpine
    environment:
      POSTGRES_PASSWORD: demo
    cpus: 1.0
    mem_limit: 256m
启动服务并读取一次资源统计:
docker compose up -d
docker compose stats --no-stream
预期输出类似下面这样,其中 <PROJECT>、<CPU> 和 <USED> 会随项目名与实时负载变化:
NAME                  CPU %     MEM USAGE / LIMIT
<PROJECT>-app-1       <CPU>     <USED> / 128MiB
<PROJECT>-cache-1     <CPU>     <USED> / 96MiB
<PROJECT>-db-1        <CPU>     <USED> / 256MiB
这里真正要观察的是“当前使用量与上限的距离”,而不是某一次采样的绝对值。如果服务在正常负载下长期贴近上限,应先确认是否存在泄漏、缓存失控或查询异常,再决定是否提高预算。
边界不是越小越安全
资源限制过松,无法阻止单个服务吞噬宿主机;限制过紧,又会把正常峰值误判成异常。合理做法是先用代表性负载找出稳定工作集和峰值,再为短时抖动保留余量,同时给操作系统、Docker Engine 和文件缓存留出空间。
资源边界的价值不是让每个服务“尽量少用资源”,而是把异常控制在服务自己的容器内,让数据库、应用和缓存即使出现局部尖峰,也不会轻易把整台宿主机拖入资源争抢。