
容器与云原生 / 系统课时
怎样限制服务内存使用
怎样限制服务内存使用
内存限制需要同时解决两件事:先让 Compose 把硬上限写入容器的资源控制层,再验证进程超过上限后确实被限制。本节用一个可重复的内存增长实验配置 mem_limit 与 memswap_limit,并检查 OOM 结果。
学习目标
- 使用
mem_limit为 Compose 服务设置内存硬上限。 - 通过可重复实验观察超出内存边界后的 OOM 行为。
- 区分硬限制、软保留和 Deploy Specification 中的内存限制写法。
用 mem_limit 设置硬上限
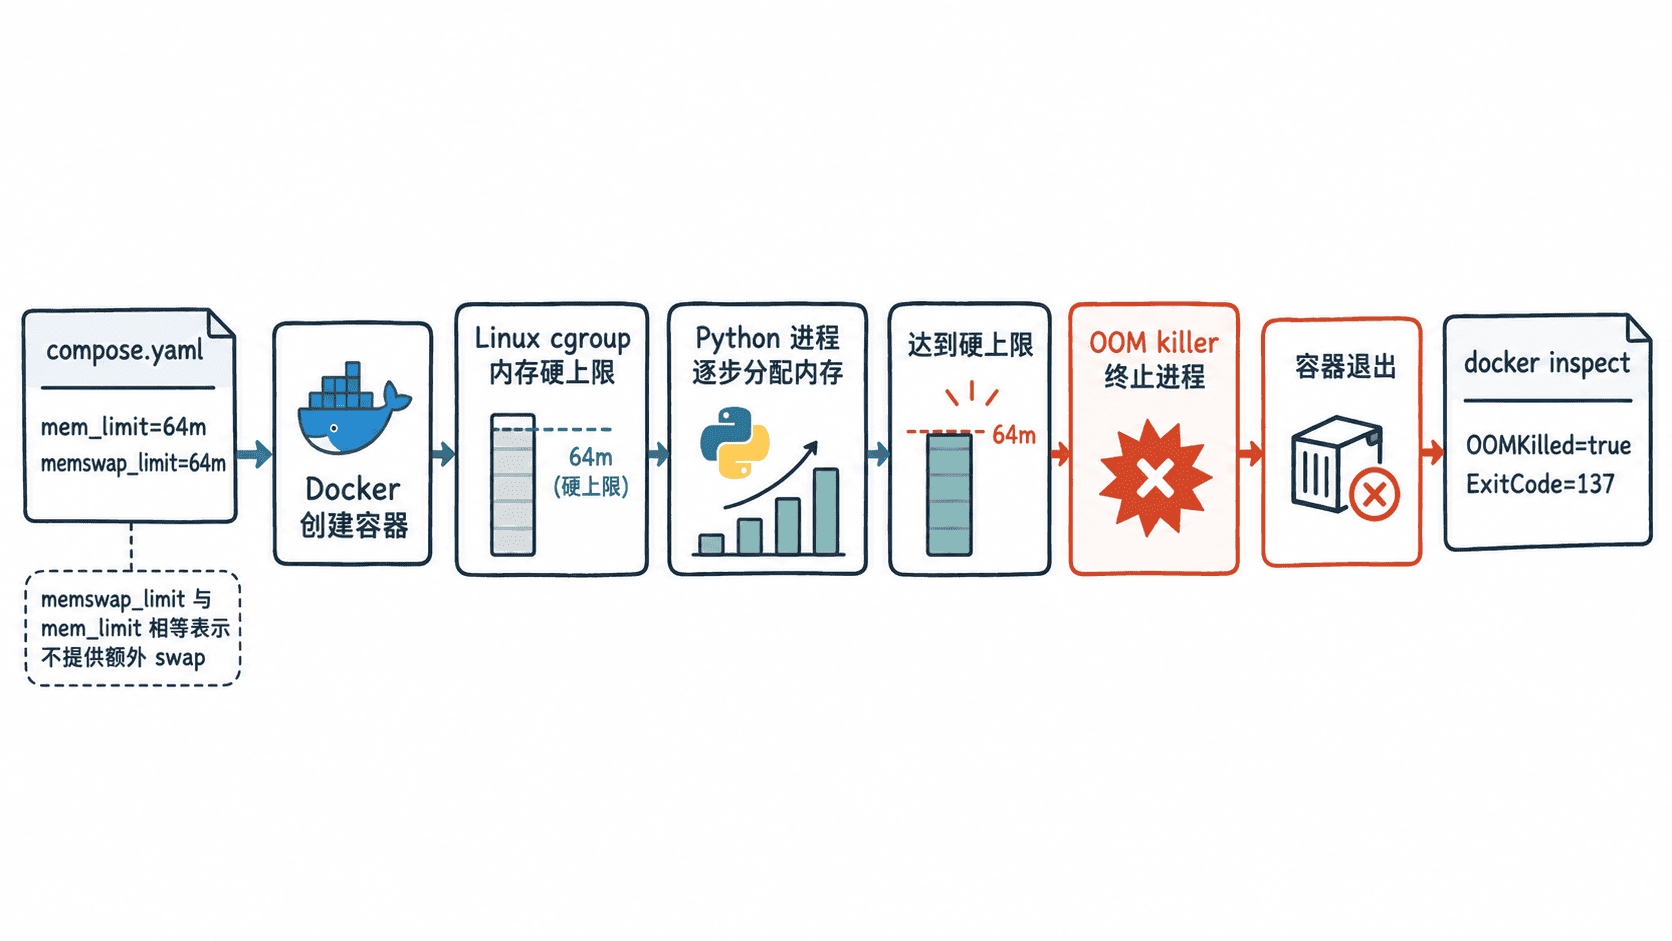
mem_limit 表示容器可分配内存的硬上限。为了让实验不受宿主机 swap 大小影响,可以把 memswap_limit 设置为与 mem_limit 相同的值;两者相等时,容器不能再额外使用 swap。
下面的服务会每次分配约 1 MiB 内存,直到触及 64 MiB 边界。restart: "no" 防止 OOM 后自动重启,便于保留退出状态进行检查。
services:
  oom-demo:
    image: python:3.13-alpine
    mem_limit: 64m
    memswap_limit: 64m
    restart: "no"
    command:
      - python
      - -c
      - |
        import time

        blocks = []
        while True:
            blocks.append(bytearray(1024 * 1024))
            print(f"allocated={len(blocks)}MiB", flush=True)
            time.sleep(0.05)
启动实验并在容器退出后读取 Docker 保存的 OOM 状态:
docker compose up --abort-on-container-exit
docker inspect "$(docker compose ps -aq oom-demo)" --format 'OOMKilled={{.State.OOMKilled}} ExitCode={{.State.ExitCode}}'
在 Linux 容器使用正常 cgroup 内存限制时,预期检查结果为:
OOMKilled=true ExitCode=137前面的分配日志会因运行环境略有差异;判断是否真正撞到内存硬限制,应以 OOMKilled=true 为主要证据,而不是依赖最后打印到多少 MiB。
怎样解读超限行为
OOM 是最后一道保护线,不是正常的流量控制手段。进程可能在没有执行应用级清理逻辑的情况下被终止,因此内存上限应该用来阻止失控占用,而不应该被当作应用主动释放缓存或自动扩缩容的机制。
如果给服务配置了 restart: on-failure 或其他重启策略,OOM 后容器可能重新启动。此时只看“容器现在是 running”容易漏掉历史故障,应同时检查重启次数、应用日志和 OOM 状态。
如果没有配置 memswap_limit,并且宿主机允许 swap,容器在物理内存压力增大后可能继续使用 swap,因此超限出现的时间和性能表现会不同。频繁换页通常会让延迟明显上升,所以长期运行服务需要同时考虑内存上限与 swap 策略。
三种内存字段怎样选择
| 字段 | 语义 | 适合场景 |
|---|---|---|
mem_limit |
容器内存硬上限 | 直接使用 Docker Compose 管理本机或单机多服务 |
mem_reservation |
内存软保留 | 希望在资源竞争时给容器一个软约束,但仍保留突发空间 |
deploy.resources.limits.memory |
Deploy Specification 的内存硬限制 | 需要用部署规范描述资源约束的平台 |
如果同时写 mem_limit 和 deploy.resources.limits.memory,两个值必须保持一致。mem_reservation 也不是硬上限:它适合表达软约束,不能替代防止失控占用所需的 mem_limit。
生产内存值要从工作集推导
生产限制不应从“宿主机有多少内存”倒推,而应从服务的稳定工作集、峰值和内部运行时特性推导。以 JVM 为例,堆上限之外仍有线程栈、直接内存和本地库开销;数据库和缓存也会使用页缓存或自身缓存,因此应用内部上限必须给容器级上限留出余量。
验证时应覆盖启动、正常峰值、批处理或大查询等真实场景,并观察限制附近是否出现频繁 GC、缓存抖动或明显延迟。一个合适的内存边界应在异常增长时保护宿主机,同时不让正常业务负载反复触发 OOM。