
架构与系统设计 / 系统课时
从关键用例抽取运行路径
从关键用例抽取运行路径
关键用例只有转成真实运行路径,才能暴露同步调用、数据访问、外部依赖和失败分支。本节用一条“提交订单”用例演示如何画出主路径与异常路径,并据此找到需要优先设计和验证的架构节点。
学习目标
- 从关键用例中识别入口、同步调用、数据读写和外部依赖
- 区分主路径、异步后续与必须处理的异常路径
- 用运行路径定位性能、可用性和一致性的重点节点
先把用例拆成运行节点
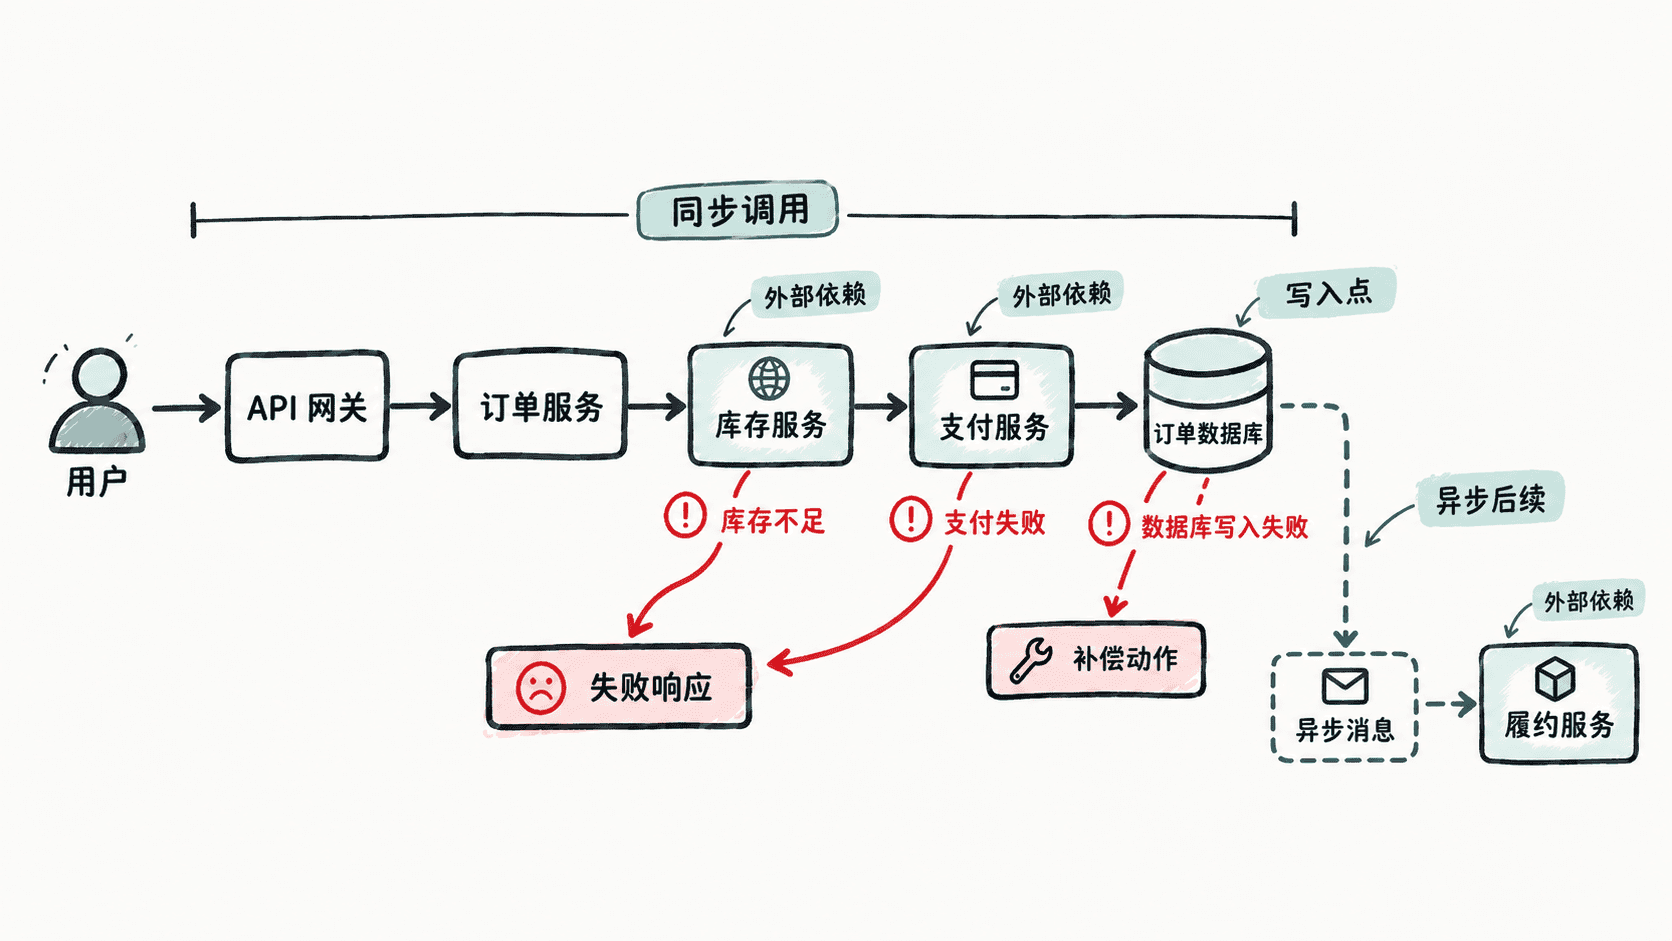
从用户动作开始,逐步记录“谁调用谁、读写什么、依赖什么外部系统”。对提交订单这类用例,至少要看到入口网关、订单服务、库存、支付、订单库以及后续事件。只写“用户下单成功”无法支持容量评估或故障分析。
每个节点都要标记它是同步还是异步,并记录会阻塞用户响应的依赖。同步链越长,尾延迟和级联失败风险越高;异步步骤虽然不阻塞主响应,但需要额外关注消息丢失、重复消费和最终一致性。
用最小模型验证主路径和异常路径
可以先把运行节点结构化,再检查主路径是否覆盖所有同步依赖、异常路径是否在关键节点分叉。下面的 Python 示例不依赖第三方库,直接输出一条正常路径和一条库存失败路径,适合在评审前验证梳理结果。
steps = {
    "API 网关": {"ok": "订单服务", "fail": "请求拒绝"},
    "订单服务": {"ok": "库存服务", "fail": "订单失败"},
    "库存服务": {"ok": "支付服务", "fail": "库存不足"},
    "支付服务": {"ok": "订单落库", "fail": "支付失败"},
    "订单落库": {"ok": "返回成功", "fail": "写入失败"},
}

def walk(start, fail_at=None):
    path = [start]
    current = start
    while current in steps:
        branch = "fail" if current == fail_at else "ok"
        current = steps[current][branch]
        path.append(current)
        if branch == "fail":
            break
    return " -> ".join(path)

print("主路径:", walk("API 网关"))
print("异常路径:", walk("API 网关", fail_at="库存服务"))
预期输出
主路径: API 网关 -> 订单服务 -> 库存服务 -> 支付服务 -> 订单落库 -> 返回成功
异常路径: API 网关 -> 订单服务 -> 库存服务 -> 库存不足
这个示例不是为了替代正式架构图,而是强迫团队把“步骤”写成有方向的依赖关系。实际项目还应给每个节点补充数据读写、超时、重试、幂等和补偿信息。
找出必须优先满足的路径
主路径优先看用户是否直接等待。如果库存、支付和订单落库都串在同步链上,那么任何一个节点的高延迟都会抬高端到端响应时间;任何一个节点不可用,都可能把整条链路拖垮。这样的节点应优先定义超时、降级和容量目标。
异常路径优先看业务后果,而不是出现频率。库存不足很常见但容易处理,支付成功后订单写库失败可能很少见,却涉及资金与订单状态不一致,通常更值得优先设计补偿、对账和幂等机制。
用路径反推架构问题
一条可用的运行路径最终应能回答四个问题:最慢的同步依赖在哪里,单点故障会在哪一处截断主路径,哪些写操作跨越了事务边界,哪些异常需要补偿而不能简单重试。若图无法回答这些问题,就继续补充依赖和失败分支,而不是增加无关组件。
完成抽取后,架构评审的重点会从“系统有哪些模块”转成“关键业务到底经过哪些节点、哪里会慢、哪里会断、哪里会产生不一致”。这才是关键用例对后续架构设计真正有价值的输入。