
架构与系统设计 / 系统课时
设计多可用区故障隔离
设计多可用区故障隔离
多可用区设计的目标不是把实例平均分散,而是保证任意一个可用区失效后,剩余计算、数据和关键依赖仍能承载业务。本篇给出副本布局、流量切换、容量预算和数据恢复的完整设计方法,并用容量计算验证方案是否真正抗单区故障。
学习目标
- 按故障域规划跨可用区副本和入口流量,避免单区故障拖垮整个服务。
- 计算单区失效后的剩余容量,并识别数据库、缓存和消息系统中的单区依赖。
- 区分流量恢复与数据恢复,明确故障切换时允许的恢复时间和数据损失边界。
把可用区当作独立故障域
多可用区架构首先要回答一个问题:某个可用区完全不可用时,系统还剩下什么? 计算实例、负载均衡后端、数据库副本、缓存节点和消息代理都必须按这个问题检查,而不是只统计总副本数。
例如服务部署 6 个实例,若三个可用区各 2 个实例,失去一个区后仍有 4 个实例。如果布局是 4、1、1,则最大可用区故障会瞬间损失三分之二计算能力,即使名义上仍然属于“三可用区部署”。
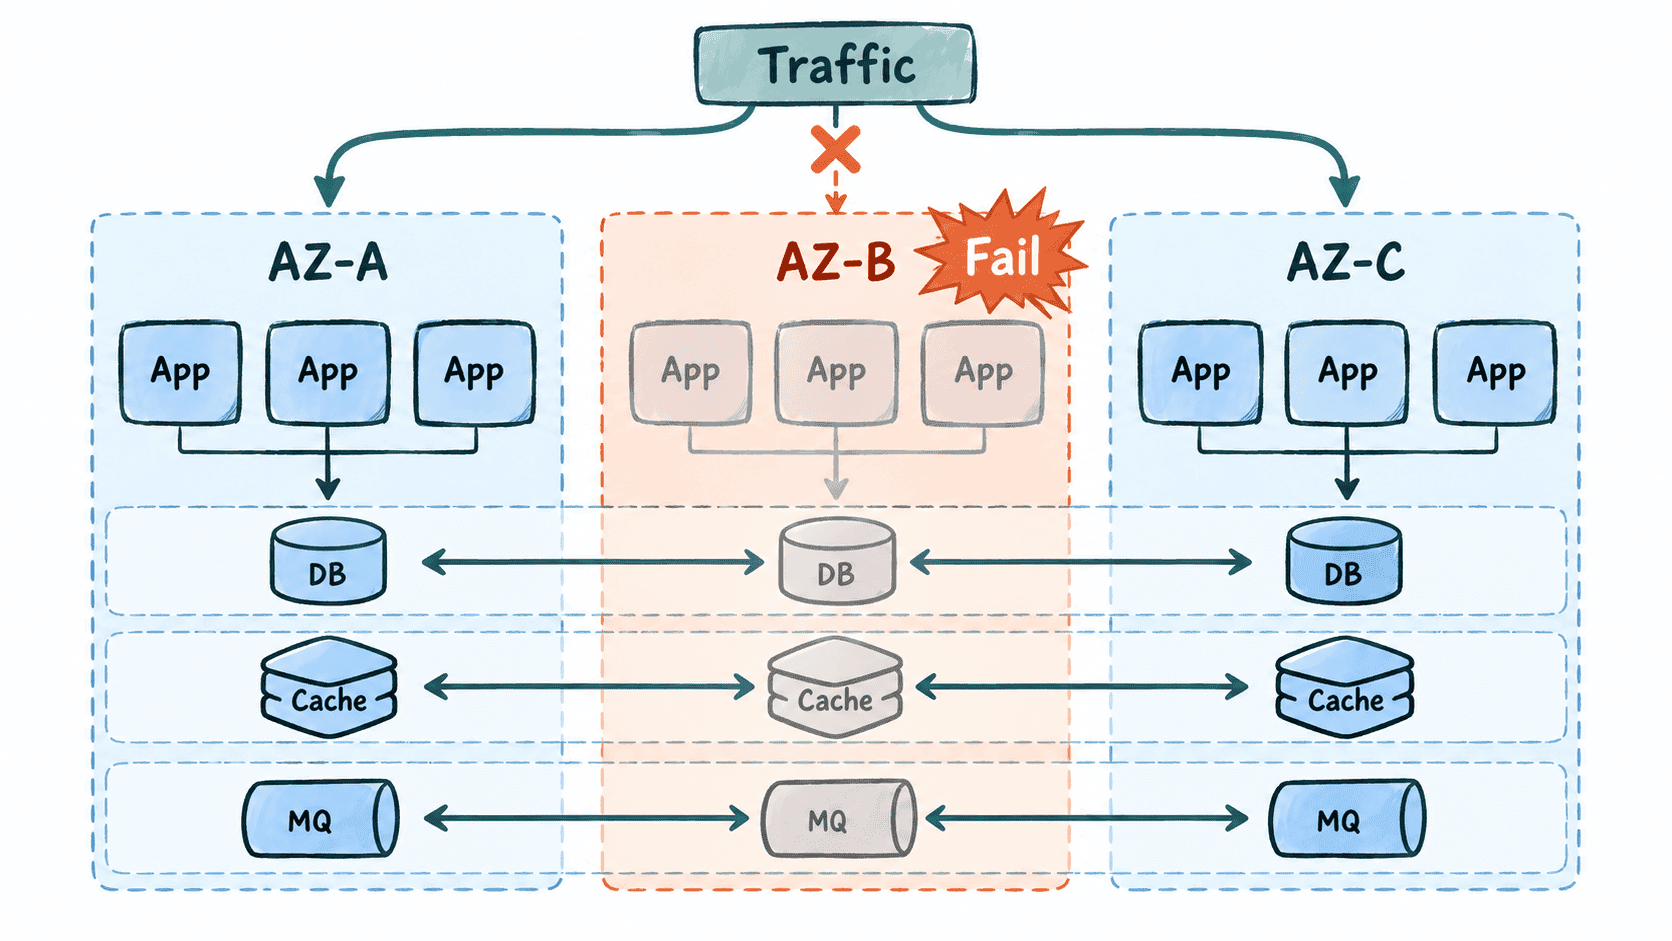
副本布局还要避免同一逻辑角色集中在单区。例如三个数据库副本虽然分布于三个区,但仲裁机制、代理或服务发现组件如果只存在于一个区,故障时仍可能无法选主或建立新连接。设计时应沿请求链逐层检查故障域,而不是只检查应用服务器。
为单区故障预留容量
正常运行时把所有实例长期压到 80%~90% 利用率,会让多可用区形同虚设。假设三个区容量相同,失去一个区后只剩约三分之二资源,因此正常负载必须为故障后的重新分配留下余量。
下面的可运行示例计算 6 个实例在三个可用区均匀部署时,失去一个区后的安全承载能力。这里把目标利用率限制为 65%,避免故障期间所有剩余实例持续满载。
# capacity_check.py
total_instances = 6
zones = 3
instance_capacity_qps = 600
target_utilization = 0.65
normal_qps = 1200

# 假设实例在各可用区均匀分布,模拟失去一个完整可用区。
remaining_instances = total_instances - total_instances // zones
safe_capacity_qps = remaining_instances * instance_capacity_qps * target_utilization
headroom_qps = safe_capacity_qps - normal_qps

print(f"remaining_instances={remaining_instances}")
print(f"safe_capacity_qps={safe_capacity_qps:.0f}")
print(f"headroom_qps={headroom_qps:.0f}")
print("result=PASS" if normal_qps <= safe_capacity_qps else "result=FAIL")
预期输出
remaining_instances=4
safe_capacity_qps=1560
headroom_qps=360
result=PASS
这个结果表示单区失效后仍能安全承载 1200 QPS,并保留 360 QPS 余量。实际评估还要把自动扩容启动时间、连接池容量、数据库最大连接数以及缓存回源增长纳入压测,而不能只看应用实例 CPU。
让流量切换不会制造第二次故障
入口层应能识别整个可用区失效,并停止向故障区发送新请求。常见做法是区域级负载均衡结合健康检查,把后端按可用区组织;健康判断要覆盖服务是否真正具备处理请求的能力,而不是只验证进程还活着。
切换速度也不是越快越好。健康检查过于敏感可能因瞬时网络抖动频繁摘除整个区域,过于迟钝则会让用户持续命中故障节点。通常需要连续失败次数、恢复成功次数和连接排空机制共同控制状态变化。
消除数据层和外部依赖的单区风险
应用副本跨区后,最容易遗漏的是状态系统。数据库需要明确副本分布、选主条件和复制方式;缓存需要决定单区丢失后是从其他区继续读取还是允许回源重建;消息系统则要确认分区副本和仲裁节点不会集中在同一个故障域。
外部依赖也必须逐项检查。如果支付代理、身份认证出口、DNS 解析器或私网网关只存在于一个区,上层应用部署再多副本也无法继续工作。可以用“请求从入口到最终持久化经过哪些节点”作为检查主线,把每个关键节点标记到所属故障域。
数据恢复还需要明确两个指标:RTO 表示允许业务中断多长时间,RPO 表示最多允许丢失多长时间的数据。同步跨区复制通常能降低 RPO,但会增加写入延迟;异步复制延迟更低,却必须接受故障瞬间尚未复制的数据可能丢失。
用故障演练验收设计
最终验收不应停留在架构图。应主动隔离一个可用区,观察入口是否停止发流、剩余区域是否保持延迟与错误率目标、数据库是否完成预期选主,以及恢复故障区后流量是否平稳回迁。
一次合格的多可用区设计,需要同时满足三个条件:故障域真正独立、剩余容量足以承载业务、状态与关键依赖没有隐藏的单区节点。只要其中一个条件不成立,“跨可用区部署”就仍然可能在单区故障时整体不可用。