
架构与系统设计 / 系统课时
识别延迟吞吐与资源瓶颈
识别延迟吞吐与资源瓶颈
性能问题不能只看“接口慢不慢”,而要把一次请求拆成可测量的阶段,再用利用率、排队和吞吐变化判断真正限制系统的资源。本篇给出一套可落地的分析顺序,并用一个可运行的小实验演示如何区分 CPU 饱和与外部依赖变慢。
学习目标
- 能把端到端请求拆成 CPU、内存、磁盘、网络和外部依赖阶段。
- 能结合延迟、吞吐、利用率与队列长度定位主要瓶颈。
- 能用阶梯加压和最小监控数据验证瓶颈判断。
先把请求拆成阶段
不要从“机器规格不够”开始猜。先画出请求在系统中的实际路径,例如:入口排队、业务计算、缓存访问、数据库查询、远程 RPC、响应编码。每一段都可能贡献延迟,但只有其中一部分会限制吞吐。
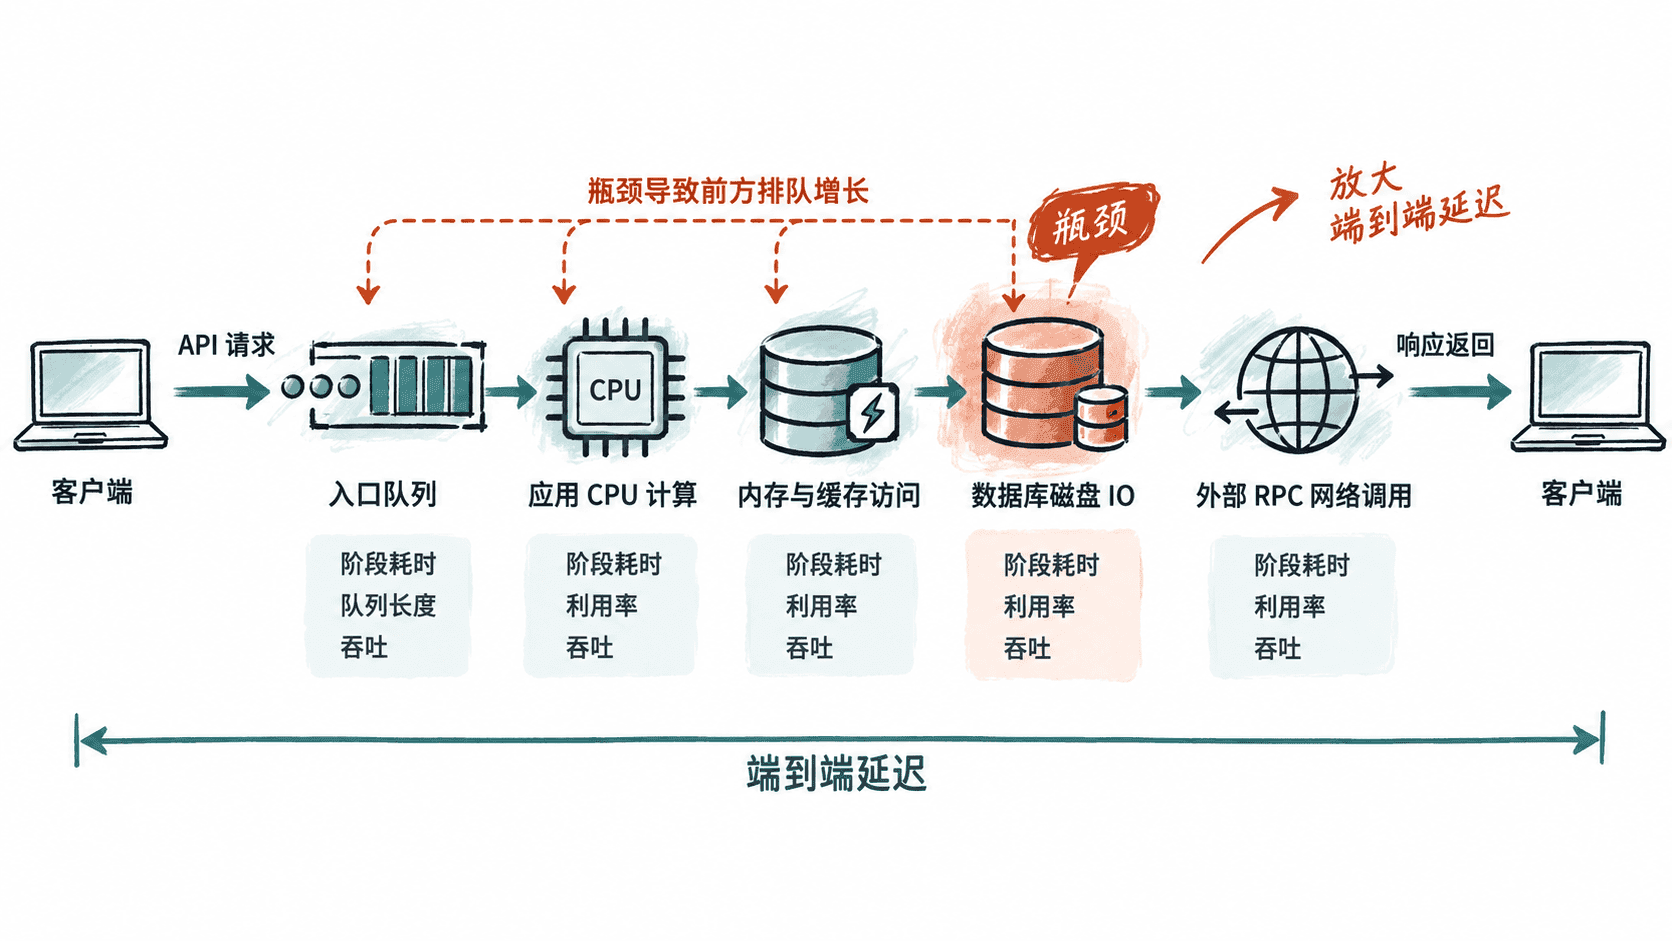
拆分后,至少要得到四类数据:端到端延迟、单位时间完成请求数、关键资源利用率、等待队列长度。仅看平均延迟容易掩盖尾部问题,因此线上通常还要关注 P95、P99 等分位数。
用利用率和排队判断限制因素
一个资源接近饱和时,新增请求不会立刻转化为吞吐,而会先进入等待。典型信号是:吞吐增长开始变缓,队列持续增长,P95/P99 延迟突然抬升,而某项资源利用率长期接近上限。
可用 Little 定律帮助校验观测是否自洽:。其中 是系统内平均请求数, 是平均吞吐, 是平均停留时间。它不是瓶颈定位器,但能帮助判断“吞吐、在途请求和延迟”三者是否匹配。
不同资源的饱和信号不同。CPU 瓶颈常伴随 CPU 利用率高、运行队列增长;磁盘瓶颈常表现为 IO 等待和磁盘队列升高;网络瓶颈会看到带宽、丢包或重传异常;外部依赖变慢时,本机资源可能并不高,但调用耗时和连接池等待会明显增加。
用阶梯加压找拐点
最可靠的验证方式不是一次把流量打满,而是逐步提高并发,观察吞吐和延迟何时出现拐点。下面的 Python 程序模拟两种系统:一种受 CPU 服务能力限制,另一种受外部依赖固定延迟限制。
import math

def sample(concurrency: int, service_ms: int, capacity_rps: int) -> tuple[int, int]:
    demand_rps = math.floor(concurrency * 1000 / service_ms)
    throughput = min(demand_rps, capacity_rps)
    queue = max(0, demand_rps - capacity_rps)
    return throughput, queue

for concurrency in (10, 20, 40, 80):
    throughput, queue = sample(concurrency, service_ms=100, capacity_rps=300)
    print(f"concurrency={concurrency:>2} throughput={throughput:>3} rps queue={queue}")
预期输出
concurrency=10 throughput=100 rps queue=0
concurrency=20 throughput=200 rps queue=0
concurrency=40 throughput=300 rps queue=100
concurrency=80 throughput=300 rps queue=500
当并发从 20 增加到 40 时,吞吐只增长到 300 RPS 后不再上升,但队列开始累积,这就是明显的容量拐点。真实系统中应把这里的 throughput 和 queue 替换为压测平台、应用指标和系统指标中的实际数据。
按顺序定位根因
定位时保持固定顺序,避免在多个图表之间来回猜测。
- 先确认现象:是所有请求都慢,还是只有某个接口、某个租户、某类请求慢。
- 再看吞吐是否达到平台期:若吞吐继续线性增长,通常还未触及硬瓶颈。
- 接着看队列:线程池、连接池、消息队列、磁盘队列中哪一处首先持续增长。
- 最后把队列前后的阶段耗时和资源利用率对齐,锁定导致等待的限制资源。
验证修复是否真的有效
修复后必须在相同输入、相同数据规模和相同并发阶梯下复测。若优化有效,应看到容量拐点右移,或相同吞吐下的 P95/P99 延迟下降,同时原先的队列增长得到抑制。
如果只是把等待从数据库连接池转移到应用线程池,端到端吞吐并不会提高。性能优化的目标不是让某一项指标“变好看”,而是提高整个请求路径的有效吞吐,并把延迟控制在可接受范围内。