
架构与系统设计 / 系统课时
处理缓存与源数据一致性
处理缓存与源数据一致性
缓存一致性的目标不是让缓存永远与源数据瞬时相同,而是让不一致窗口可预测、可限制、可观测。本节从读写模式出发选择失效、更新或版本校验策略,并把业务能容忍的陈旧时间转成明确规则。
学习目标
- 根据读多写少、写频繁和强校验场景选择缓存策略
- 理解 Cache-Aside 写后失效的竞态窗口与失败恢复
- 用 TTL、版本号和业务容忍时间限制陈旧数据风险
先定义业务允许多旧
讨论缓存策略前,先定义“允许读到多旧的数据”。商品详情可能允许几十秒陈旧,库存扣减、余额、权限状态则通常不能依赖长期陈旧缓存。这个边界决定你需要的是性能优化,还是接近强一致的校验路径。
可以把容忍度写成可执行约束,例如“商品文案最多陈旧 60 秒”“价格最多陈旧 5 秒”“库存判断必须回源或使用具备原子语义的库存组件”。没有这个边界,团队很容易用同一种缓存方案覆盖所有数据。
选择失效、更新还是版本校验
读多写少且允许短暂陈旧时,优先使用 Cache-Aside:读缓存,未命中再查源数据并回填;写入时先更新源数据,再删除缓存。它简单且容易恢复,适合大多数详情类数据。
写入频繁、要求缓存尽快反映变化时,可以由 CDC 或事件订阅异步更新缓存,但必须接受“消息延迟、重复、乱序”成为新的正确性问题。若读请求必须确认自己拿到的是最新版本,可以给源数据附带单调递增版本号,在关键读路径做版本校验。
| 场景 | 首选策略 | 主要代价 |
|---|---|---|
| 读多写少、允许短暂陈旧 | 写源数据后失效缓存 | 删除失败会延长陈旧窗口 |
| 高频写、可异步收敛 | CDC/事件更新缓存 | 处理重复、乱序和积压 |
| 关键读必须识别旧值 | 版本校验 | 需要额外版本元数据或校验成本 |
理解 Cache-Aside 的正确写入顺序
推荐顺序是“先写源数据,再删缓存”。如果反过来先删缓存再写数据库,恰好有并发读在两步之间发生,它可能把旧源数据重新回填进缓存,并持续存在到 TTL 到期。
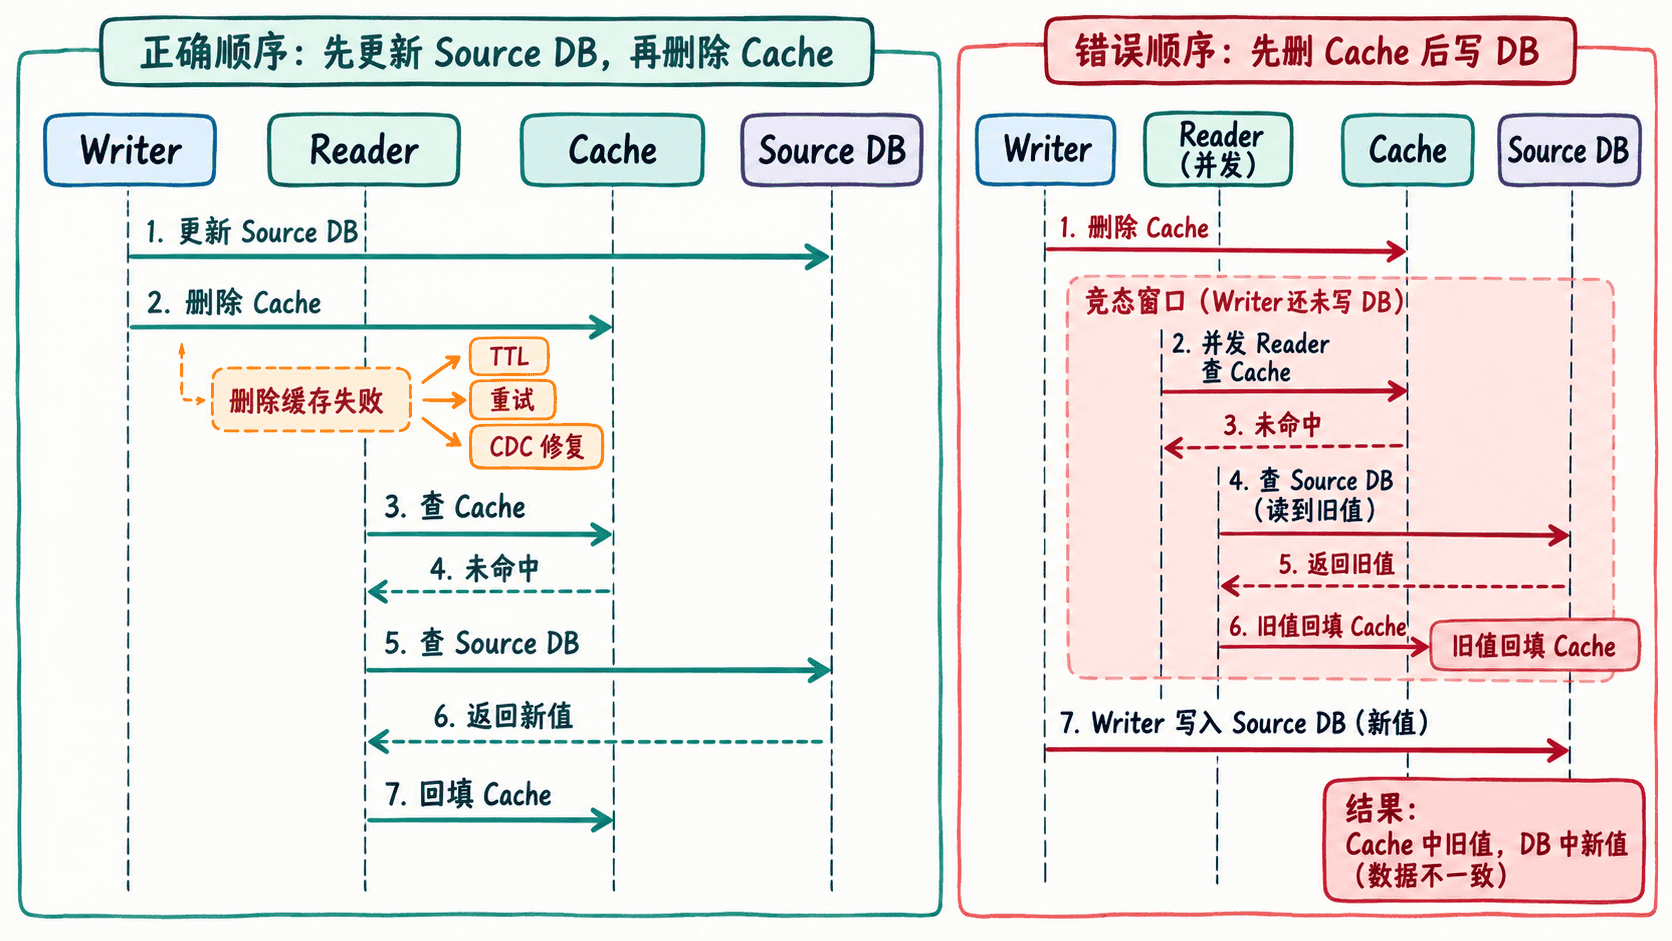
下面的可运行 Python 示例演示最小的 Cache-Aside 流程。这里用字典模拟源数据与缓存,重点是操作顺序而不是具体缓存产品。
db = {"product:42": {"version": 1, "price": 100}}
cache = {}

def read_product(key):
    if key in cache:
        return "cache-hit", cache[key].copy()
    value = db[key].copy()
    cache[key] = value.copy()
    return "cache-miss", value

def update_price(key, new_price):
    current = db[key]
    db[key] = {
        "version": current["version"] + 1,
        "price": new_price
    }
    # 源数据提交成功后再失效缓存,避免旧值长期覆盖新值。
    cache.pop(key, None)

print(read_product("product:42"))
print(read_product("product:42"))
update_price("product:42", 120)
print(read_product("product:42"))
预期输出
('cache-miss', {'version': 1, 'price': 100})
('cache-hit', {'version': 1, 'price': 100})
('cache-miss', {'version': 2, 'price': 120})
真实系统里删除缓存仍可能失败,因此“写库成功 + 删缓存失败”必须有恢复机制。常见做法是设置有限 TTL、对删除操作重试,或让 CDC/消息事件最终把缓存推进到新版本。
给竞态和失败设置护栏
缓存一致性不是只靠一条写入顺序解决。并发读回填时可以携带版本号,只允许较新版本覆盖较旧版本;热点 key 在缓存失效瞬间要避免大量请求同时回源,可使用请求合并或短时互斥;缓存更新消息必须按业务 key 保序,或者在写入时比较版本。
最后把技术策略落到可验收指标:缓存命中率、回源率、删除失败率、缓存值与源数据版本差、最大陈旧时长。业务真正需要的不是“理论强一致”这个口号,而是在可接受成本下,把陈旧数据限制在事先同意的范围内。