
架构与系统设计 / 系统课时
规划单体到服务化的迁移顺序
规划单体到服务化的迁移顺序
服务化迁移最危险的不是“拆得慢”,而是一次改动同时跨越太多边界,导致验证困难、失败后也无法迅速退回。本篇给出一套可执行的排序与切换方法:先挑高价值、低耦合边界,再用稳定接口和小流量切换逐步替代单体能力,并为每一步保留明确回退路径。
学习目标
- 用业务价值与耦合成本为候选模块排序,识别适合先迁移的边界。
- 设计不暴露内部实现的过渡接口,让单体与新服务可以并存。
- 把迁移拆成可验证、可回滚的小步,避免一次性重写。
先用价值和耦合筛出第一批边界
不要按代码目录大小决定先拆什么。更有效的做法是同时看“迁移后能得到多少收益”和“为了迁移需要改动多少邻接关系”。高价值、低耦合的能力通常最适合作为第一批,因为它能尽快证明服务化收益,又不会把数据库事务、共享模型和同步调用链一起拖进改造。
可以从四类信号评估候选模块:是否需要独立扩缩容、是否经常独立发布、当前故障是否容易拖累整体,以及它是否依赖共享事务、共享表和大量内部调用。评分不需要追求数学精确,重点是让团队用同一套标准比较候选项。
下面的脚本用一个最小评分模型演示排序方法,实际项目可把权重替换为评审后的真实值。
candidates = [
    {"name": "notification", "value": 5, "coupling": 1},
    {"name": "reporting", "value": 4, "coupling": 2},
    {"name": "checkout", "value": 5, "coupling": 5},
]

for item in sorted(
    candidates,
    key=lambda x: (x["value"] - x["coupling"], x["value"]),
    reverse=True,
):
    priority = item["value"] - item["coupling"]
    print(f'{item["name"]}: priority={priority}')
预期输出
notification: priority=4
reporting: priority=2
checkout: priority=0
这里不是说结算类能力永远不能先拆,而是提醒:高业务价值不能抵消高耦合带来的迁移风险。若一个候选项必须同时拆共享事务、重写多个调用方并迁走大量表,它更适合先做解耦准备,而不是直接服务化。
用稳定接口把新旧实现隔开
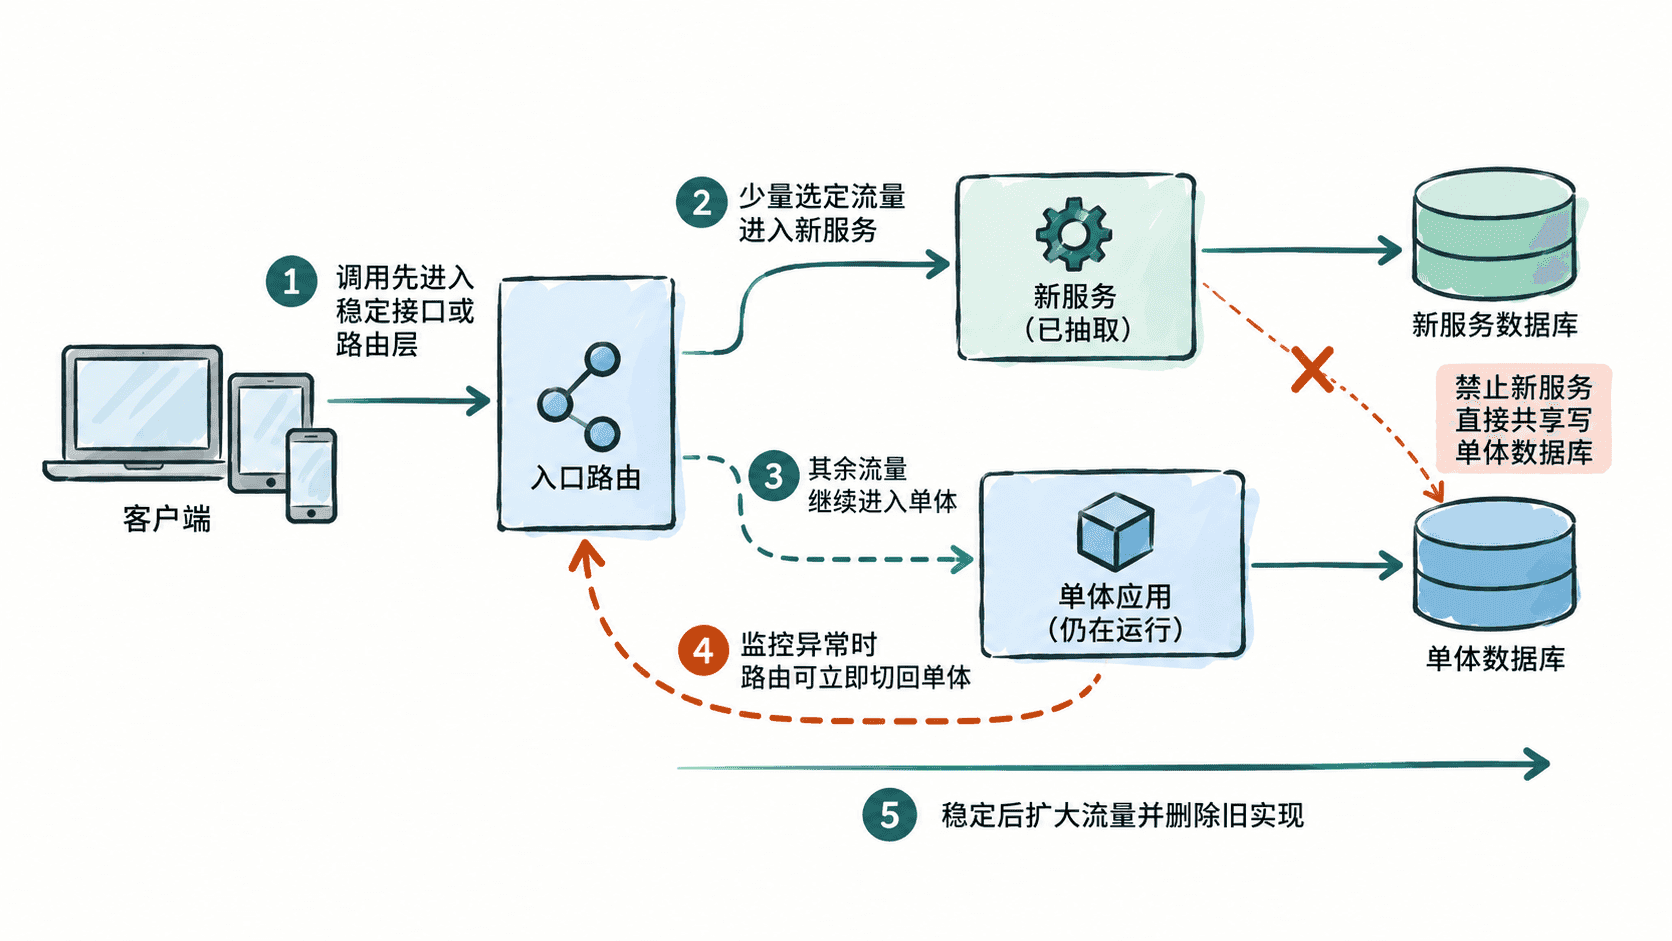
迁移期间最重要的不是“新服务 API 长什么样”,而是调用方不需要知道请求最终落到单体还是新服务。可以先在单体内部建立清晰的领域接口或适配层,再让网关、路由层或调用适配器把选定流量导向新实现。
过渡接口应满足三个条件:输入输出语义稳定、错误语义可兼容、调用方不依赖新服务的内部表结构。尤其不要用“新服务继续直接读写单体数据库”来换取表面上的快速拆分,否则只是把进程内耦合变成网络耦合。
按可回滚切片安排迁移顺序
一个候选边界确定后,也不要一次把“代码、数据、流量、旧逻辑”全部切走。更稳妥的顺序是先建立接口,再迁实现,再迁流量,最后才删除旧路径。
- 在单体内先收敛调用入口,减少其他模块直接访问内部类和数据表。
- 抽出新服务并完成独立测试,让它在没有正式流量时也能验证核心行为。
- 只切一小部分可识别流量,例如内部用户、单个租户或低风险业务分区。
- 对比成功率、延迟、业务结果和数据一致性,确认异常时能通过路由或开关退回单体。
- 逐步扩大流量;只有稳定窗口结束后,才移除旧实现和无用适配层。
每一步都应有“完成条件”和“回退动作”。如果某一步失败后只能靠紧急发版恢复,就说明这个切片仍然太大,或切换点放得太靠后。
把数据所有权放在迁移决策里
服务化常见的真正难点不是代码,而是数据边界。优先迁移的数据应尽量具备单一所有者,或者至少能通过事件、复制读模型等方式逐步摆脱共享写。跨服务强事务越多,越应该先重构边界,再迁进程。
如果暂时无法一次迁走数据,可以先让新服务只拥有新增数据或只负责读模型,但要明确最终所有权方向和退出条件。临时共享方案如果没有截止点,很容易变成长期架构。
迁移顺序的目标不是尽快得到更多服务,而是持续缩小单体的职责,同时让每一步都能验证、能回退、能继续演进。只要某个候选边界仍然需要同时改动大量调用方、共享事务和数据表,就先解耦,再迁移。