
架构与系统设计 / 系统课时
从 SLO 反推监控告警
从 SLO 反推监控告警
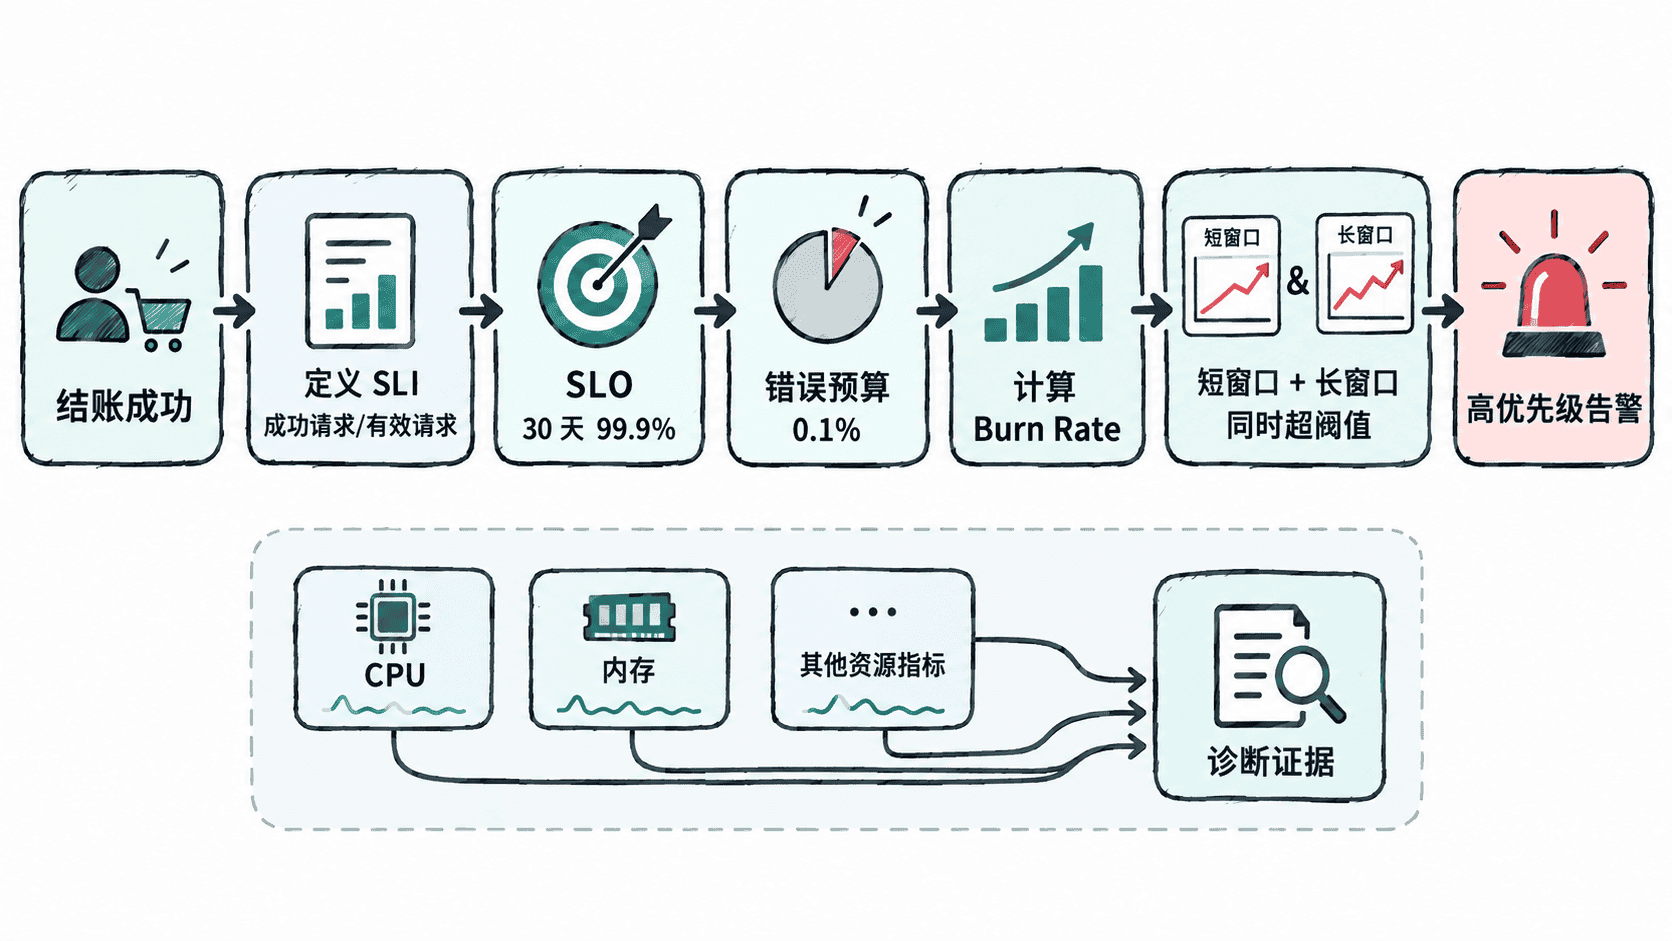
本节从用户目标而不是主机曲线出发设计告警:先明确 SLI 与 SLO,再计算错误预算和燃烧速度,把告警阈值绑定到“预算会被多快耗尽”。最终得到的告警更接近真实用户风险,也更少被短时资源抖动干扰。
学习目标
- 从用户体验定义可计算的 SLI 与 SLO
- 用错误预算和 Burn Rate 判断异常是否值得告警
- 配置并验证一个基于多时间窗口的高燃烧率告警
从用户结果定义 SLI
假设结账服务的目标是“请求成功且在可接受时间内完成”。最简单的可用性 SLI 可以定义为成功请求数占总请求数的比例:
如果 30 天 SLO 是 99.9%,允许的错误预算比例就是 ,也就是 0.1%。对于请求型 SLO,这个预算表示允许失败的请求份额;只有在 SLI 定义本身就是“可用时间比例”时,才可以把它直接换算成允许不可用时长。
选择 SLI 时应尽量靠近用户结果。CPU 使用率、线程数和磁盘队列可以用于诊断,但它们不是用户是否成功完成结账的直接证据,因此不应单独决定是否通知值班人员。
用错误预算决定告警强度
Burn Rate 表示当前错误消耗速度是预算允许速度的多少倍:
对 99.9% SLO 而言,预算错误比例是 0.001。如果某段时间错误率为 1.44%,Burn Rate 就是 14.4。持续以这个速度运行,大约一小时就会消耗 30 天预算的 2%,已经值得快速处理。
但单一短窗口容易被瞬时尖峰触发,单一长窗口又可能发现太慢。更稳妥的做法是同时观察一个短窗口和一个长窗口:只有两者都超过同一燃烧率阈值时才触发高优先级告警。
配置双窗口高燃烧率告警
下面以 Prometheus 规则为例。假设 http_requests_total 包含 service 和 status 标签,99.9% SLO 的错误预算比例为 0.001。14.4 倍燃烧率对应 1.44% 错误率,因此短、长窗口都超过 0.0144 时才告警。
groups:
  - name: checkout-slo
    rules:
      - alert: CheckoutSLOBurnFast
        expr: |
          (
            sum(rate(http_requests_total{service="checkout",status=~"5.."}[5m]))
            /
            sum(rate(http_requests_total{service="checkout"}[5m]))
          ) > 0.0144
          and
          (
            sum(rate(http_requests_total{service="checkout",status=~"5.."}[1h]))
            /
            sum(rate(http_requests_total{service="checkout"}[1h]))
          ) > 0.0144
        for: 2m
        labels:
          severity: page
        annotations:
          summary: "checkout 正在快速消耗 SLO 错误预算"
这份配置的生效行为是:5 分钟和 1 小时错误率同时高于 1.44%,且条件持续 2 分钟时触发 page 级告警;只有 5 分钟尖峰而 1 小时窗口仍健康时不会触发。实际指标名和标签需要与采集模型一致。
保存为 checkout-slo.yml 后,可以先做语法验证:
promtool check rules checkout-slo.yml预期输出:
Checking checkout-slo.yml
  SUCCESS: 1 rules found
如果本地 promtool 版本输出细节不同,只要规则文件检查成功且无解析错误即可。
把资源告警降级为诊断线索
SLO 告警解决的是“用户目标是否面临风险”,资源监控则用于解释“为什么”。例如高 CPU 可能是原因,也可能只是正常扩容前的短时负载;如果成功率和延迟仍满足 SLO,就不一定值得立即呼叫值班人员。
更合适的分层是:SLO 快速燃烧触发通知,资源指标进入告警上下文;容量即将耗尽、磁盘空间不足等确定会演变成用户故障的资源风险,可以保留独立告警,但应基于剩余时间或明确阈值,而不是任意的“超过 80%”。
验收告警是否有效
上线前至少回放三类场景:短时错误尖峰、持续高错误率、资源升高但用户请求仍成功。理想结果是第一类不立刻分页,第二类稳定触发,第三类只提供诊断信号而不制造噪声。
当告警阈值从 SLO 和错误预算反推,而不是从“看起来危险”的资源曲线拍脑袋设定时,监控体系才能把注意力集中在真正威胁用户目标的事件上。