
架构与系统设计 / 系统课时
用风险清单安排演进优先级
用风险清单安排演进优先级
架构演进不能只按“哪个问题最吵”排期。更可靠的方法是把风险写成可比较的条目,再结合发生概率、影响范围、可逆性和验证成本确定先后顺序,最后把高优先级风险转成验证、缓解或监控任务进入迭代计划。
学习目标
- 把模糊担忧改写成包含触发条件、后果和证据的风险条目
- 用发生概率、影响范围、可逆性和验证成本建立一致的排序规则
- 将风险排序结果转换成可以进入迭代的验证、缓解和监控任务
先把担忧写成风险条目
风险清单不是问题列表。每一条都应表达“在什么条件下,什么不确定性可能造成什么后果”。例如“数据库会扛不住”过于模糊,而“活动流量超过 4000 RPS 时,单库写入延迟可能抬升,导致下单 P99 超过 1.5 秒”已经可以验证和安排动作。
一条可执行的风险还应包含当前证据、负责人和状态。没有触发条件就无法监控,没有后果就无法比较影响,没有证据就无法判断风险是在下降还是只是被重新描述。
用四个维度建立排序规则
可以把四个维度都统一到 1~5 分。发生概率和影响范围越高越优先;可逆性用 1 表示难回滚、5 表示容易回滚;验证成本用 1 表示低成本、5 表示高成本。为了让“高暴露、难逆转、容易验证”的风险更快被处理,可以使用一个简单加权分数作为排序辅助。
下面的 Python 示例给三项风险计算优先级。这个分数不是架构真理,它的价值在于让团队使用同一套口径,并能讨论权重而不是争论感觉。
risks = [
    {"name": "双写失败导致数据不一致", "p": 2, "i": 5, "r": 1, "c": 3},
    {"name": "热点分区导致写入抖动", "p": 4, "i": 4, "r": 3, "c": 2},
    {"name": "共享 Schema 加深服务耦合", "p": 3, "i": 3, "r": 2, "c": 1},
]

def priority_score(risk):
    return (
        4 * risk["p"]
        + 5 * risk["i"]
        + 3 * (6 - risk["r"])
        + 2 * (6 - risk["c"])
    )

ranked = sorted(risks, key=priority_score, reverse=True)

for index, risk in enumerate(ranked, start=1):
    print(f"{index}. {risk['name']}: {priority_score(risk)}")
预期输出
1. 双写失败导致数据不一致: 54
2. 热点分区导致写入抖动: 53
3. 共享 Schema 加深服务耦合: 49
权重应与当前系统目标一致。如果处于数据迁移期,可以提高不可逆风险的权重;如果团队验证资源很紧张,则可以提高低成本验证的收益。分数接近时不要强行区分名次,直接比较证据质量和业务时限。
把排序结果转成迭代动作
高分风险不等于立刻做大规模重构。先看它适合哪类动作:证据缺口大且验证便宜,优先做实验;影响很大但验证昂贵,先降低暴露面并补观测;暂时无法消除但有明确触发条件,则进入监控和应急预案。
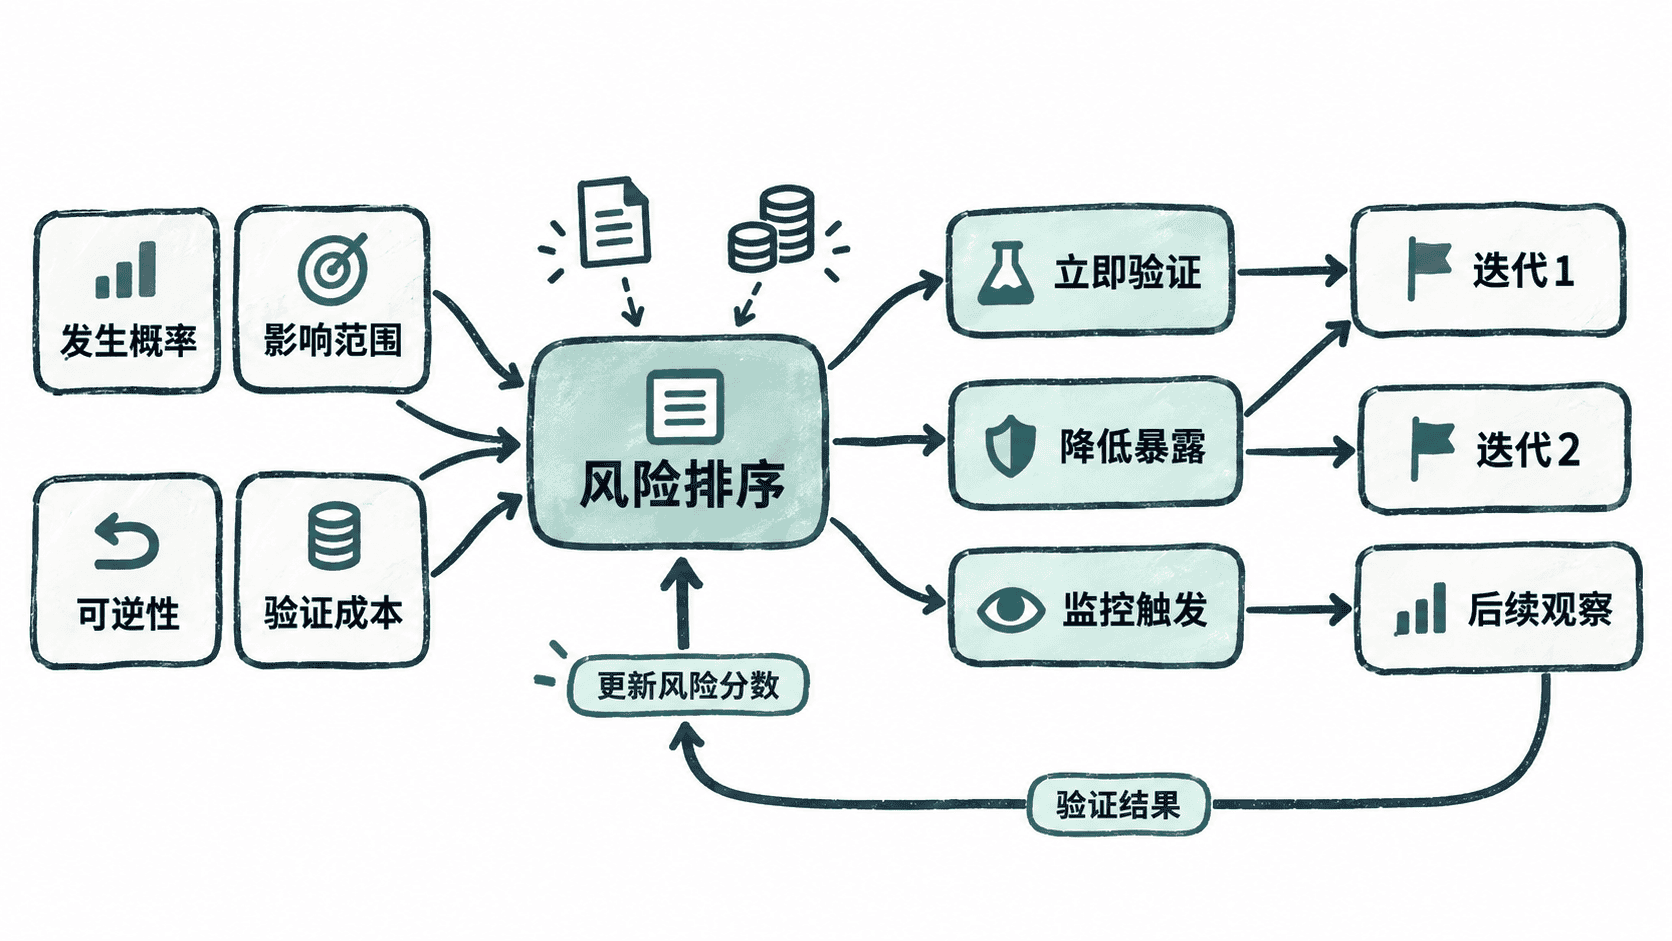
迭代项要写成可验收动作,例如“完成双写故障注入并确认补偿可恢复”“为热点键增加分片方案并压测到 5000 RPS”“为共享 Schema 建立兼容性检查”。风险条目仍保留在清单中,只在证据表明风险下降后更新状态和评分。
定期重排而不是一次性定级
风险优先级会随证据和系统阶段变化。建议在架构里程碑、重大流量变化、数据迁移或关键依赖升级后重新评分。新证据可能降低发生概率,也可能暴露更大的影响范围,原来的顺序因此失效。
风险状态至少区分开放、验证中、已缓解和已接受。已接受不等于删除:仍要记录触发条件、责任人和重新评估时点。这样,风险清单才不是评审附件,而是一份会持续驱动架构演进的工作队列。