
架构与系统设计 / 系统课时
划分系统信任边界
划分系统信任边界
本节要把“系统内部都可信”改成可检查的边界模型:先标出公网、内部网络、服务身份和敏感数据,再逐条检查数据跨越边界时是否需要认证、输入校验、授权与加密。完成后,你应能得到一张可用于安全评审的信任边界图和一份边界检查清单。
学习目标
- 识别网络边界、身份边界与数据边界,而不是只按部署网段划线。
- 为每一次跨边界通信确定认证、校验、授权与加密要求。
- 用数据流反查遗漏的入口、共享凭据和敏感数据暴露点。
信任边界不是网络边界的同义词
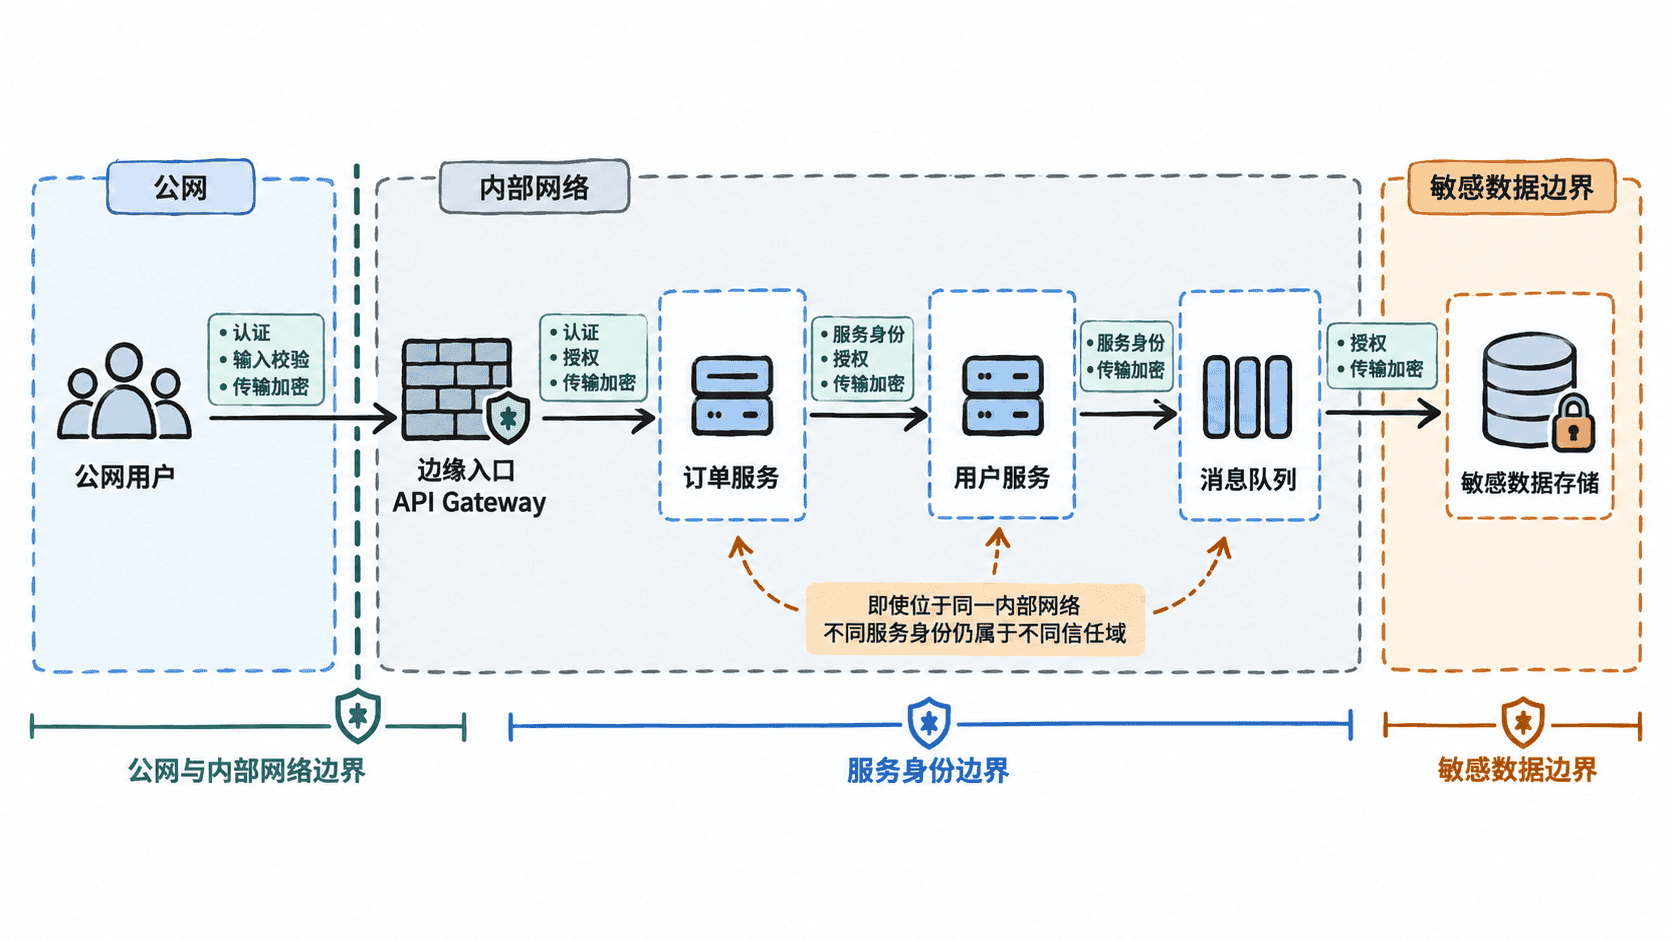
信任边界表示“安全假设发生变化的位置”。公网到 API 网关显然是一条边界,但同一内网中的两个服务也可能处在不同信任域:它们使用不同服务身份、拥有不同资源权限,任何一方被攻破后都不应自动获得另一方的权限。
因此,架构图上至少要同时看三类对象:请求从哪里来、以什么身份运行、携带什么数据。只画 VPC、子网或机房边界,往往会漏掉服务间调用、后台任务、消息消费者和运维入口这些高风险通道。
从数据流开始划边界
最实用的做法不是先讨论“哪些机器可信”,而是拿一条关键业务链路逐跳检查。例如“用户提交订单”可以拆成浏览器到网关、网关到订单服务、订单服务到用户服务、订单服务到数据库或消息队列。每一跳都记录来源、目标、身份、数据类型和安全控制。
当一条数据流跨越信任边界时,应回答四个问题:调用方是谁,输入是否可被伪造,调用方是否有权执行该动作,传输内容是否需要防窃听或篡改。认证解决“你是谁”,校验解决“输入是否符合预期”,授权解决“你能做什么”,加密保护“传输过程是否可被读取或修改”。
用敏感数据反向检查边界
仅沿请求方向检查还不够。把用户身份信息、支付信息、密钥、访问令牌、审计日志等敏感数据单独标出,再追踪它们会经过哪些服务、队列、缓存和日志系统。只要数据进入新的处理域,就相当于扩大了信任范围。
例如订单服务只需要用户等级,却直接读取完整用户档案,这通常意味着边界过宽。更好的做法是让用户服务只返回业务必需字段,并避免把令牌、身份证号等敏感值写入普通日志。边界设计的目标不是让所有组件“更可信”,而是让任何单点失陷后的影响范围更小。
给每条边界绑定控制措施
边界控制应和威胁类型一一对应。公网入口通常需要强认证、速率限制、输入校验和 TLS;内部服务调用需要服务身份、细粒度授权和双向认证或等价机制;访问敏感存储则要进一步限制资源动作、记录审计事件,并控制数据在静态和传输过程中的加密。
用问题清单做架构评审
评审时不要只问“有没有防火墙”,而应逐条核对:每个外部入口是否可枚举,每个服务调用是否带独立身份,每个身份是否只拥有完成任务所需的权限,敏感数据是否经过不必要的中间节点,以及日志、消息和缓存是否意外复制了敏感信息。
最终产物应是一张能标出“谁以什么身份,把什么数据送到哪里”的图。只要某条箭头无法回答认证、校验、授权和加密由谁负责,那条数据流就还没有真正完成信任边界设计。