
架构与系统设计 / 系统课时
为远程调用设置超时预算
为远程调用设置超时预算
本篇解决“每层都配了超时却仍然把请求拖死”的问题:从端到端时延目标反推调用链预算,并把剩余时间沿链路传递,让下游在资源被耗尽前主动失败。
学习目标
- 从端到端时延目标拆出可执行的调用预算
- 用截止时间约束连接、排队和下游处理
- 识别会造成层层等待的常见超时配置
先把端到端目标变成预算
超时不是“某个接口最多等几秒”的孤立参数,而是一次用户请求可以消耗的总时间。假设订单接口的端到端目标是 800 ms,其中必须给网关返回、日志与少量调度抖动预留 80 ms,那么真正可供业务调用链使用的预算只有 720 ms。
可用预算可以写成 。关键点是每经过一层都重新计算剩余时间,而不是让网关、服务 A、服务 B 各自拿一份固定的 800 ms。后者会把一次请求扩展成多层串行等待。
例如父调用还剩 450 ms,下游 RPC 就不该再配置 2 s 的读取超时。更合理的做法是给这次子调用一个不超过 450 ms 的 deadline,并继续为父层收尾保留少量时间。
沿调用链传递截止时间
固定超时只描述“这一步最多等多久”,deadline 则描述“整次请求最晚什么时候结束”。在多级 RPC 中,优先传递 deadline 或剩余预算,让每一层都基于同一个端到端时钟做决定。
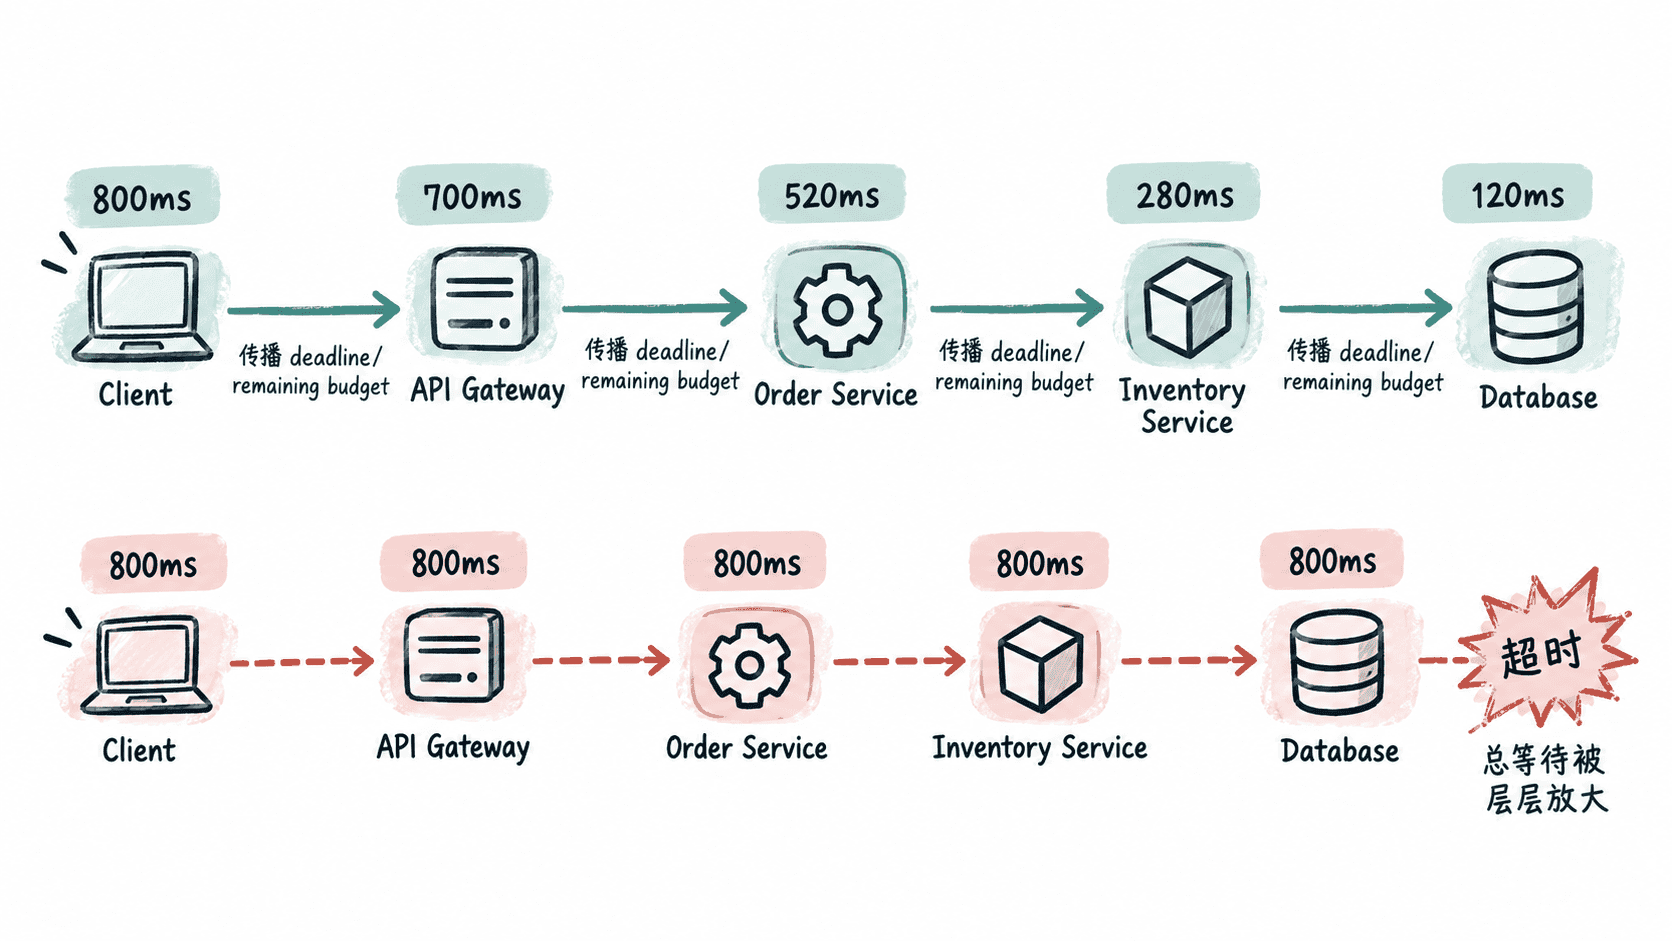
一个实用约束是:子调用的超时必须小于父调用剩余预算。如果父层只剩 300 ms,却允许数据库查询等待 500 ms,那么父层先返回超时后,数据库仍可能继续占用连接和 CPU,形成“用户已失败、后台还在做无效工作”的资源泄漏。
用脚本验证预算递减
下面的示例用一个 800 ms 的端到端预算和 80 ms 的保留时间,模拟请求依次经过四个阶段。每进入一层,都先计算当前还可分配多少时间。
BUDGET_MS = 800
RESERVE_MS = 80

hops = [
    ("gateway", 90),
    ("order-service", 180),
    ("inventory-service", 210),
    ("database", 120),
]

elapsed_ms = 0

for name, cost_ms in hops:
    remaining_ms = max(0, BUDGET_MS - elapsed_ms - RESERVE_MS)
    print(f"{name}: remaining={remaining_ms}ms")
    elapsed_ms += cost_ms
预期输出
gateway: remaining=720ms
order-service: remaining=630ms
inventory-service: remaining=450ms
database: remaining=240ms
真实系统不会预先知道每层耗时,而是用单调时钟记录已经消耗的时间;这里的固定值只是为了让预算递减关系可复现。实际接入 RPC 框架时,应把计算出的剩余时间写入请求上下文或框架支持的 deadline。
区分不同等待阶段
一次远程调用通常不只有一个“请求超时”。连接池取连接、建立 TCP/TLS 连接、写请求、等待响应都可能独立阻塞。只配置读取超时,会让请求在真正发出前就把预算耗光。
常见做法是分别约束这些阶段:连接池获取要短,连接建立要短于业务处理预算,读取超时不得超过当前剩余 deadline。若框架支持统一 deadline,应让这些局部超时都受 deadline 上限约束,而不是彼此独立计时。
验证不会层层等待
压测或故障注入时,可以故意让最深层依赖变慢,然后同时观察端到端延迟、线程池活跃数、连接池等待数和下游取消量。正确配置下,请求会在预算耗尽附近快速失败,资源曲线随后回落,而不是持续堆积到各层默认超时全部到期。
还要确认重试不会重新获得一份完整预算。一次请求如果只剩 150 ms,就不应因为“准备重试”又重置成 800 ms。超时预算必须覆盖原始请求、重试等待和再次调用的总和,这样端到端目标才真正有约束力。