
架构与系统设计 / 系统课时
用熔断与隔离限制故障扩散
用熔断与隔离限制故障扩散
慢依赖最危险的地方不是单次失败,而是它会长期占住线程、连接和队列,拖垮原本健康的请求。本篇把故障控制拆成两层:隔离先限制可消耗的资源,熔断再限制继续发起无意义调用。
学习目标
- 用独立资源池和并发上限划定单个依赖的故障半径
- 理解 Closed、Open、Half-Open 三个熔断状态及转换条件
- 为超时、拒绝、熔断和恢复探测建立可验证的保护顺序
先用隔离守住资源边界
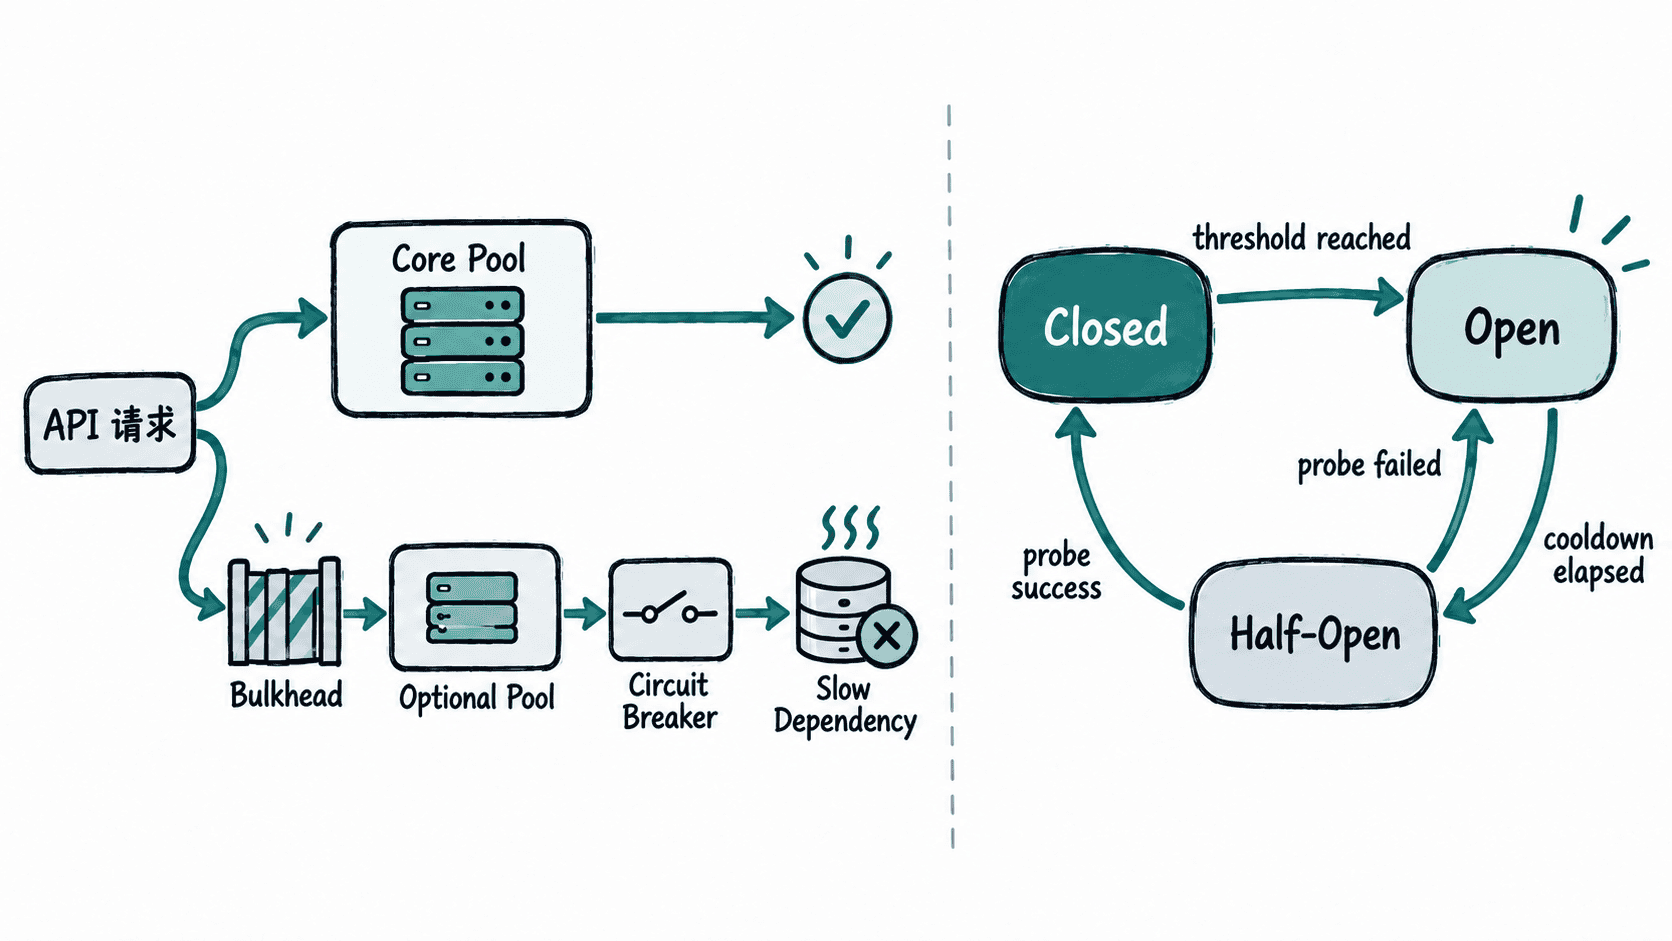
如果核心查询和低优先级推荐共用同一线程池,推荐服务一旦变慢,就可能占满全部工作线程。更稳妥的做法是按依赖或业务等级拆分线程池、连接池或信号量,并给每个隔离单元设置并发上限和有限队列。
隔离的目标不是提升成功率,而是保证“最多坏到这里”。达到上限后应快速拒绝、降级或返回缓存,不能继续无限排队。队列越长,用户看到的往往不是更高成功率,而是更长尾延迟和更晚的失败。
熔断器限制无效调用
熔断器通常在 Closed 状态放行请求并统计失败;失败达到阈值后切到 Open,直接拒绝调用;冷却窗口结束后进入 Half-Open,只放少量探测流量。探测成功才恢复 Closed,失败则重新 Open。
下面的可运行示例同时演示一个容量为 1 的隔离舱和一个连续失败 2 次即熔断的状态机。隔离舱第二个并发请求被立即拒绝;熔断器在两次失败后阻止第三次调用,冷却后用一次成功探测恢复。
import threading
import time
from concurrent.futures import ThreadPoolExecutor

class BulkheadFull(Exception):
    pass

class CircuitOpen(Exception):
    pass

class Bulkhead:
    def __init__(self, capacity: int):
        self._slots = threading.BoundedSemaphore(capacity)

    def call(self, fn):
        if not self._slots.acquire(blocking=False):
            raise BulkheadFull("bulkhead_full")
        try:
            return fn()
        finally:
            self._slots.release()

class CircuitBreaker:
    def __init__(self, failure_threshold=2, reset_timeout=0.05):
        self.failure_threshold = failure_threshold
        self.reset_timeout = reset_timeout
        self.failures = 0
        self.state = "CLOSED"
        self.opened_at = 0.0

    def call(self, fn):
        if self.state == "OPEN":
            if time.monotonic() - self.opened_at < self.reset_timeout:
                raise CircuitOpen("circuit_open")
            self.state = "HALF_OPEN"

        try:
            result = fn()
        except Exception:
            self.failures += 1
            if self.state == "HALF_OPEN" or self.failures >= self.failure_threshold:
                self.state = "OPEN"
                self.opened_at = time.monotonic()
            raise
        else:
            self.failures = 0
            self.state = "CLOSED"
            return result

bulkhead = Bulkhead(capacity=1)
entered = threading.Event()
release = threading.Event()

def slow_call():
    entered.set()
    release.wait()
    return "first-ok"

with ThreadPoolExecutor(max_workers=1) as pool:
    first = pool.submit(bulkhead.call, slow_call)
    entered.wait()
    try:
        bulkhead.call(lambda: "second-ok")
    except BulkheadFull as exc:
        print("bulkhead-second:", exc)
    release.set()
    print("bulkhead-first:", first.result())

breaker = CircuitBreaker()
outcomes = iter([RuntimeError("downstream_timeout"),
                 RuntimeError("downstream_timeout"),
                 "ok"])

def dependency():
    result = next(outcomes)
    if isinstance(result, Exception):
        raise result
    return result

for i in (1, 2, 3):
    try:
        print(f"call-{i}:", breaker.call(dependency), "state=" + breaker.state)
    except Exception as exc:
        print(f"call-{i}:", exc, "state=" + breaker.state)

time.sleep(0.06)
print("call-4:", breaker.call(dependency), "state=" + breaker.state)
预期输出:
bulkhead-second: bulkhead_full
bulkhead-first: first-ok
call-1: downstream_timeout state=CLOSED
call-2: downstream_timeout state=OPEN
call-3: circuit_open state=OPEN
call-4: ok state=CLOSED
真实系统还要保证状态计数线程安全,并限制 Half-Open 的探测并发。示例中的时间值只是为了快速观察状态转换,生产阈值应根据延迟分位数、错误率和依赖容量确定。
保护顺序要形成闭环
一条可靠的调用链通常先设置连接与请求超时,避免单次调用无限占用资源;随后用隔离限制并发和队列;再由熔断器根据超时、连接错误或特定状态码判断依赖是否整体失效。Open 后直接执行降级,避免继续浪费资源。
恢复也要受控。Half-Open 不是“恢复全部流量”,而是小流量探测。若依赖刚恢复就瞬间放回全部请求,很容易再次过载。核心指标至少包括隔离舱拒绝数、当前并发、熔断状态、Open 次数、Half-Open 探测成功率和依赖延迟。
当一个非核心依赖变慢时,验收标准不是“它还能勉强成功”,而是核心链路仍有独立资源可用,超额请求能快速失败或降级,熔断后调用量明显下降,并且恢复流量通过受限探测逐步放回。