
架构与系统设计 / 系统课时
用故障演练验证恢复路径
用故障演练验证恢复路径
恢复能力不能只靠架构图和预案证明。本节把一次故障演练拆成可控注入、检测告警、切换或降级、恢复和验收几个阶段,用明确证据判断恢复路径是否真的可执行,并把失败点沉淀为后续架构改进项。
学习目标
- 选择影响范围可控、可回退且可观察的故障注入点
- 用统一证据验证检测、告警、切换、降级与恢复是否达到预期
- 将演练结果整理成可关闭的架构缺口,而不是只记录“演练成功”
先把恢复路径写成可验收链路
一次故障演练验证的不是“系统能不能重启”,而是一整条恢复链路。至少要明确故障从哪里进入、谁先检测、谁触发告警、系统采取什么动作、何时认为服务恢复,以及恢复后还要检查什么。
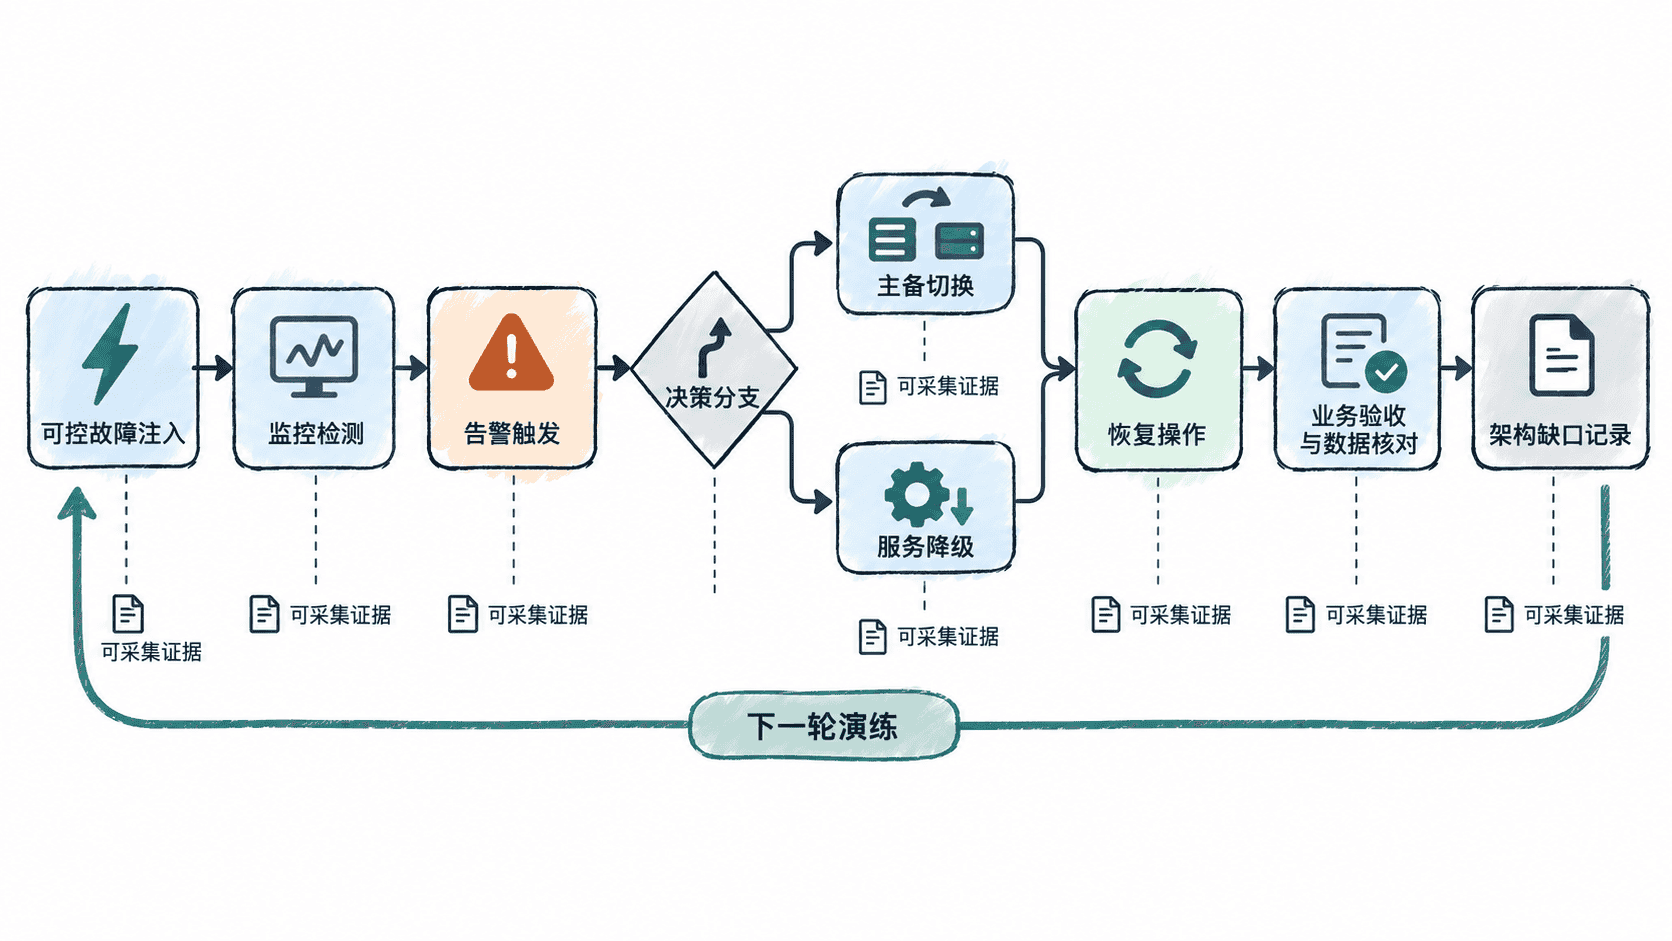
演练前先为每个阶段写出“预期动作”和“验收证据”。例如,检测阶段不能只写“监控会发现”,而要写清依赖的健康检查、指标或日志;切换阶段要说明业务请求应由哪条备用路径继续承接;恢复阶段还要包含流量回切、积压清理和一致性核对。
选择可控故障与停止条件
好的注入点要同时满足四个条件:影响边界清楚、可以主动撤销、能观察到系统响应、与要验证的恢复机制直接相关。优先从单实例不可用、单依赖超时、局部网络失败、非关键能力关闭这类局部故障开始,不要第一次演练就同时破坏多个关键组件。
还要给演练划定爆炸半径,例如限定在测试环境、隔离租户、单可用区或小比例流量。生产环境演练只有在回退动作、权限、联系人和数据保护措施都已准备好时才有意义。
用最小演练脚本验证状态转换
下面的 Python 程序不操作真实基础设施,只把恢复路径抽象成几个可观测信号,用于先验证“什么故障应该触发什么告警和动作”。真实演练时,可以把这些信号替换为监控查询,把动作替换为平台切换、限流或降级接口。
from dataclasses import dataclass

@dataclass(frozen=True)
class Signal:
    primary_up: bool = True
    standby_ready: bool = True
    dependency_up: bool = True

def decide(signal: Signal) -> tuple[str, str]:
    # 主实例不可用时,优先切换;备用未就绪时进入只读降级。
    if not signal.primary_up:
        if signal.standby_ready:
            return "ALERT_CRITICAL", "SWITCH_TO_STANDBY"
        return "ALERT_CRITICAL", "DEGRADE_READ_ONLY"

    # 外部依赖故障不必拖垮主链路,可关闭非关键能力。
    if not signal.dependency_up:
        return "ALERT_WARNING", "DEGRADE_NONCRITICAL"

    return "NO_ALERT", "NORMAL"

cases = [
    ("baseline", Signal()),
    ("primary-failed", Signal(primary_up=False)),
    ("primary-and-standby-failed", Signal(primary_up=False, standby_ready=False)),
    ("dependency-failed", Signal(dependency_up=False)),
    ("recovered", Signal()),
]

for name, signal in cases:
    alert, action = decide(signal)
    print(f"{name}: alert={alert}, action={action}")
预期输出
baseline: alert=NO_ALERT, action=NORMAL
primary-failed: alert=ALERT_CRITICAL, action=SWITCH_TO_STANDBY
primary-and-standby-failed: alert=ALERT_CRITICAL, action=DEGRADE_READ_ONLY
dependency-failed: alert=ALERT_WARNING, action=DEGRADE_NONCRITICAL
recovered: alert=NO_ALERT, action=NORMAL
这个最小模型的价值是先把预期写死,再去真实环境采证。若现场行为与模型不同,不要立刻把差异解释成“环境问题”,而应判断是监控缺失、阈值错误、自动化未生效,还是恢复策略本身没有覆盖该状态。
按证据执行演练并验收
演练现场可以按同一顺序推进:
- 记录基线,确认关键请求、错误率、延迟和备用能力处于正常状态。
- 执行单一故障注入,并记录准确的开始时间。
- 观察检测时间和告警时间,确认告警内容能指向受影响对象。
- 检查预期的切换或降级是否发生,业务是否仍满足最低可用目标。
- 撤销故障,观察恢复、回切和积压清理过程。
- 核对业务结果、关键数据和告警关闭状态,确认没有隐藏残留。
| 阶段 | 至少保留的证据 | 通过标准 |
|---|---|---|
| 检测 | 指标、健康检查或日志时间点 | 能定位故障且检测延迟在目标内 |
| 告警 | 告警触发与通知记录 | 信息足以指导下一步动作 |
| 切换或降级 | 路由、实例状态、请求结果 | 备用路径或降级策略按设计生效 |
| 恢复 | 回切记录、积压状态、数据核对 | 服务恢复且没有遗留错误状态 |
时间、实例 ID、请求 ID 等动态值应在演练记录中保留真实值;若示例化展示,可统一写成 <TIME>、<ID>,避免把一次演练的偶然值误当成固定配置。
把失败点改写成架构缺口
演练结束后不要只写“成功/失败”。每个异常都应转成一个可以关闭的问题,例如“故障能切换,但没有告警”“告警到了,但无法定位受影响实例”“备用路径可用,但恢复后没有自动回切”“降级生效,但关键写请求没有明确的补偿策略”。
缺口记录至少包含现象、影响、根因假设、临时处置、长期修复和再次验证方式。只有当修复项在下一轮演练中被重新验证,恢复路径才算真正闭环。故障演练的产出不是一次漂亮的演练记录,而是一条经过证据验证、能重复执行的恢复路径。