
架构与系统设计 / 系统课时
设计无状态扩容与负载均衡
设计无状态扩容与负载均衡
本节解决一个直接问题:怎样让应用实例可以随流量增加而横向扩容,并在实例故障或缩容时不丢用户状态。最终会把状态边界、健康检查和流量分配组合成一套可落地的无状态扩容方案。
学习目标
- 识别必须留在请求内的临时数据与需要外置的共享状态
- 设计“负载均衡器—无状态实例—外部状态服务”的扩容链路
- 用就绪检查和流量策略避免把请求发送到不可服务的实例
无状态不是没有状态
无状态实例的含义不是系统完全没有状态,而是任意应用实例都不依赖自己的本地可变数据来继续处理下一次请求。请求携带必要身份信息,长期或跨请求状态存放在实例之外,因此同一用户的连续请求可以落到不同实例。
常见需要外置的内容包括登录会话、购物车、任务进度、分布式锁和业务缓存。它们通常进入 Redis、数据库或专门的状态服务。进程内对象、本地文件和本机内存缓存只能保存可丢弃、可重建的数据,否则实例重启或迁移就会改变业务结果。
把状态和流量路径拆开
请求先到负载均衡器,再被分配到任意健康实例;实例处理过程中按需访问共享状态服务。扩容时只增加新的应用实例,缩容时先停止接收新流量,再等待在途请求结束,不需要迁移实例私有会话。
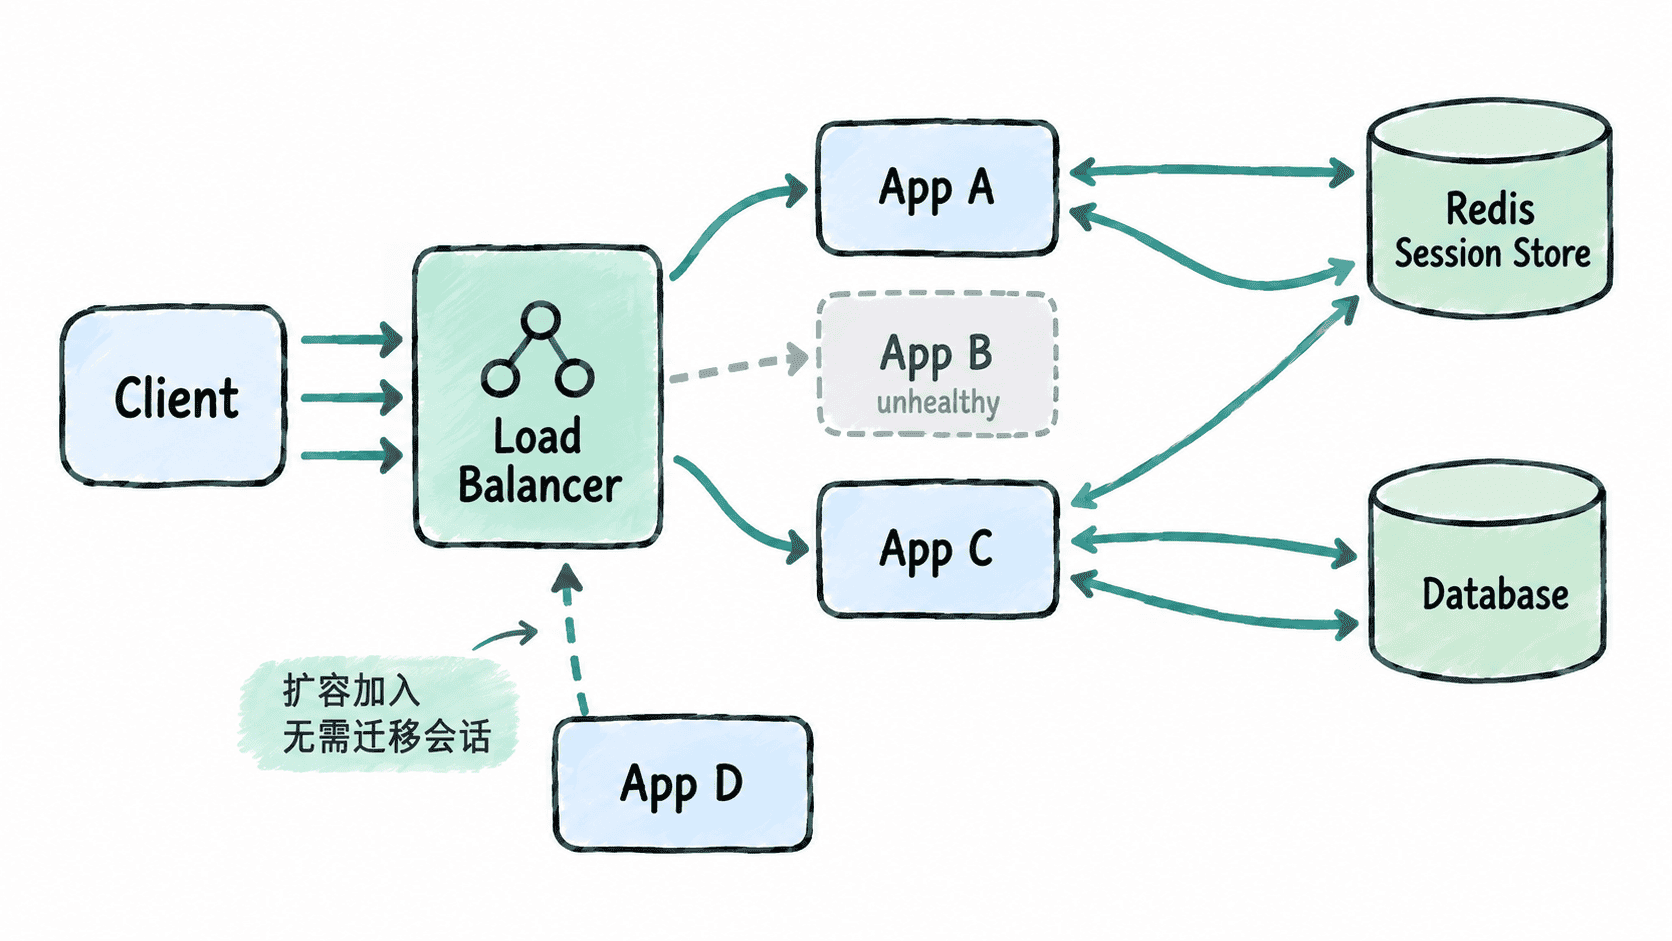
这条链路成立有两个前提:第一,外部状态服务本身必须可用并具有足够容量;第二,实例启动后不能立刻接流量,而要在依赖连接、配置加载和预热完成后再被判定为就绪。
让健康检查控制流量资格
健康检查至少区分“进程还活着”和“现在能不能接请求”。存活检查失败通常意味着进程需要重启;就绪检查失败则应先从负载均衡池摘除,避免数据库断连、缓存未预热或配置未加载完成的实例继续接流量。
负载分配策略要匹配请求成本。请求耗时接近时,轮询简单且稳定;连接持续时间差异大时,可考虑最少连接;若后端能力不一致,则用权重表达容量差异。不要在没有测量依据时追求复杂算法,健康摘除和容量边界通常比“更聪明的轮询”更重要。
下面给出 Kubernetes 中的片段示例。它依赖一个已存在的 checkout 工作负载和 /health/live、/health/ready 两个真实端点,用来表达“是否重启”和“是否接流量”是两种不同判断。
livenessProbe:
  httpGet:
    path: /health/live
    port: 8080
  initialDelaySeconds: 10
  periodSeconds: 10
readinessProbe:
  httpGet:
    path: /health/ready
    port: 8080
  initialDelaySeconds: 5
periodSeconds: 5生效行为是:livenessProbe 连续失败时容器会被重启;readinessProbe 失败时 Pod 会从 Service 的可用端点中移除,但不会仅因未就绪就自动重启。
可以用下面的命令验证当前实例是否进入可服务状态:
kubectl get pods -l app=checkout预期输出中的 Pod 名称和运行时长会随环境变化:
NAME                READY   STATUS    RESTARTS   AGE
checkout-<ID>       1/1     Running   0          <TIME>
checkout-<ID>       1/1     Running   0          <TIME>
扩缩容时守住连接与状态边界
扩容流程应是“启动实例—完成预热—就绪检查通过—加入流量”;缩容流程则相反,“标记未就绪—停止新请求—等待连接排空—终止实例”。如果先杀进程再摘流量,客户端会看到突发连接重置,长请求也可能被截断。
还要检查后台任务、定时器和本地缓存是否偷偷破坏无状态假设。需要全局唯一执行的任务应放入独立调度器或通过分布式协调选主;缓存若影响正确性,就不能只存在单机内存。做到这些后,应用实例才真正具备“可随时增加、替换和移除”的工程属性。