
架构与系统设计 / 系统课时
设计指标日志追踪关联模型
设计指标日志追踪关联模型
本节要解决的不是“把三套工具接起来”,而是建立一套统一的关联语义:先用指标发现异常,再用同一组服务与请求标识定位日志,并沿 Trace 还原调用路径,最终把排障入口从“到处搜索”收敛成可重复的下钻链路。
学习目标
- 设计指标、日志与追踪之间可稳定关联的字段模型
- 区分适合做指标标签、日志字段与 Trace 属性的数据
- 建立从异常指标下钻到日志和调用链的标准路径
先统一关联键
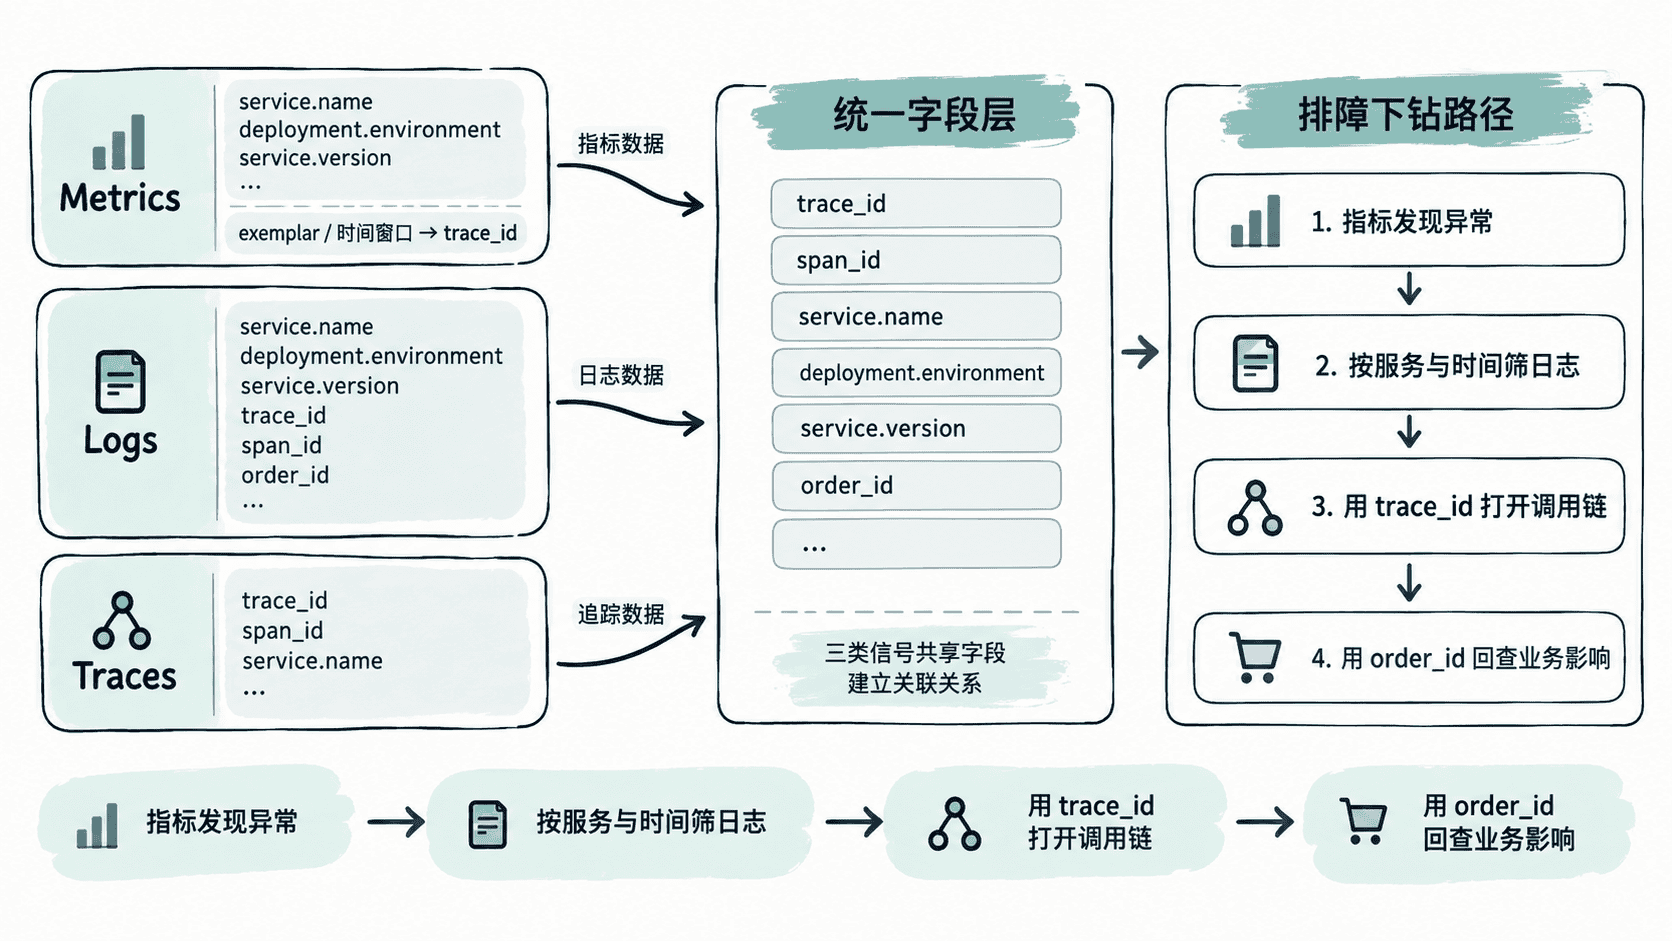
关联模型至少要覆盖三类键:资源身份、请求身份和业务身份。资源身份回答“哪个服务、哪个环境、哪个版本出了问题”;请求身份回答“这一次调用经过了哪些 Span”;业务身份则帮助把技术故障映射到订单、任务或租户等业务对象。
推荐把 service.name、deployment.environment、service.version 作为三类信号都携带的稳定资源字段;把 trace_id、span_id 放进日志与 Trace;把 order_id、tenant_id 等业务键放进日志与必要的 Span 属性。业务键通常不直接做指标标签,因为值域过大会造成时间序列基数爆炸。
下面是一条结构化日志的字段示例,它不是控制台输出,而是建议的日志事件形态:
{
  "timestamp": "<TIME>",
  "severity": "ERROR",
  "service.name": "checkout",
  "deployment.environment": "prod",
  "service.version": "2026.09.12",
  "trace_id": "<ID>",
  "span_id": "<ID>",
  "order_id": "<ID>",
  "event": "payment_authorization_failed"
}
这类日志可以直接用 trace_id 跳转到调用链,也能用 order_id 回查同一业务事件。实际时间和 ID 会因请求而变化。
让三类信号各自承担合适的信息
指标适合回答“异常是否存在、影响多大、趋势如何”,因此标签必须稳定且低基数。常见维度包括服务、接口、区域、结果类型和版本。不要把 trace_id、用户 ID、订单号直接作为普通指标标签,否则时间序列数量会随请求增长。
日志适合保存离散事件和诊断上下文。除了统一资源字段,应优先记录错误码、状态转换、依赖目标和关键业务对象;同一条日志中出现 trace_id 后,日志系统就不再只是全文检索入口,而是 Trace 的证据补充。
Trace 负责解释一次请求如何跨服务传播。Span 属性应保留定位瓶颈和失败所需的信息,例如 RPC 方法、数据库系统、下游服务和结果状态;高敏感或高体量字段不要无选择地写入 Span。
设计固定的下钻路径
一次典型故障定位可以固定为四步:
- 从 SLI 或关键业务指标识别异常服务、接口、环境和时间窗口。
- 使用同一组资源字段过滤日志,确认错误类型与受影响业务对象。
- 从日志里的
trace_id进入 Trace,检查跨服务耗时和失败 Span。 - 回到业务键,统计影响范围并验证修复后的同类请求是否恢复。
如果平台支持 Exemplars,可以让某个延迟或错误率采样点直接关联代表性的 trace_id,减少“先猜时间再搜日志”的中间步骤。但即使没有 Exemplars,只要时间、服务名、环境和版本统一,也能可靠完成关联。
验收这套模型
真正可用的标准不是“指标、日志、Trace 都有数据”,而是值班人员能在一次真实告警中快速完成跨信号跳转。可以随机选择一个失败请求,检查三件事:指标能锁定服务与时间范围,日志能找到对应 trace_id,Trace 又能回到同一服务版本和业务对象。
当三类信号共享稳定资源字段、日志与 Trace 共享请求身份、业务键只进入合适的信号层后,可观测性就从三套孤立数据源变成一条连续的诊断证据链。