
架构与系统设计 / 系统课时
用队列削峰并控制反压
用队列削峰并控制反压
队列可以把瞬时流量从同步链路移开,但它不会凭空增加处理能力。本篇建立生产速率、消费能力、积压量和等待时间之间的关系,并设计限流、反压与过载保护,让异步链路既能削峰又不会无限堆积。
学习目标
- 判断队列能否吸收给定持续时间的流量峰值
- 用积压量、等待时间和消费能力设置可执行阈值
- 设计从降速、拒绝到恢复的反压与过载保护链路
队列解决的是时间错配
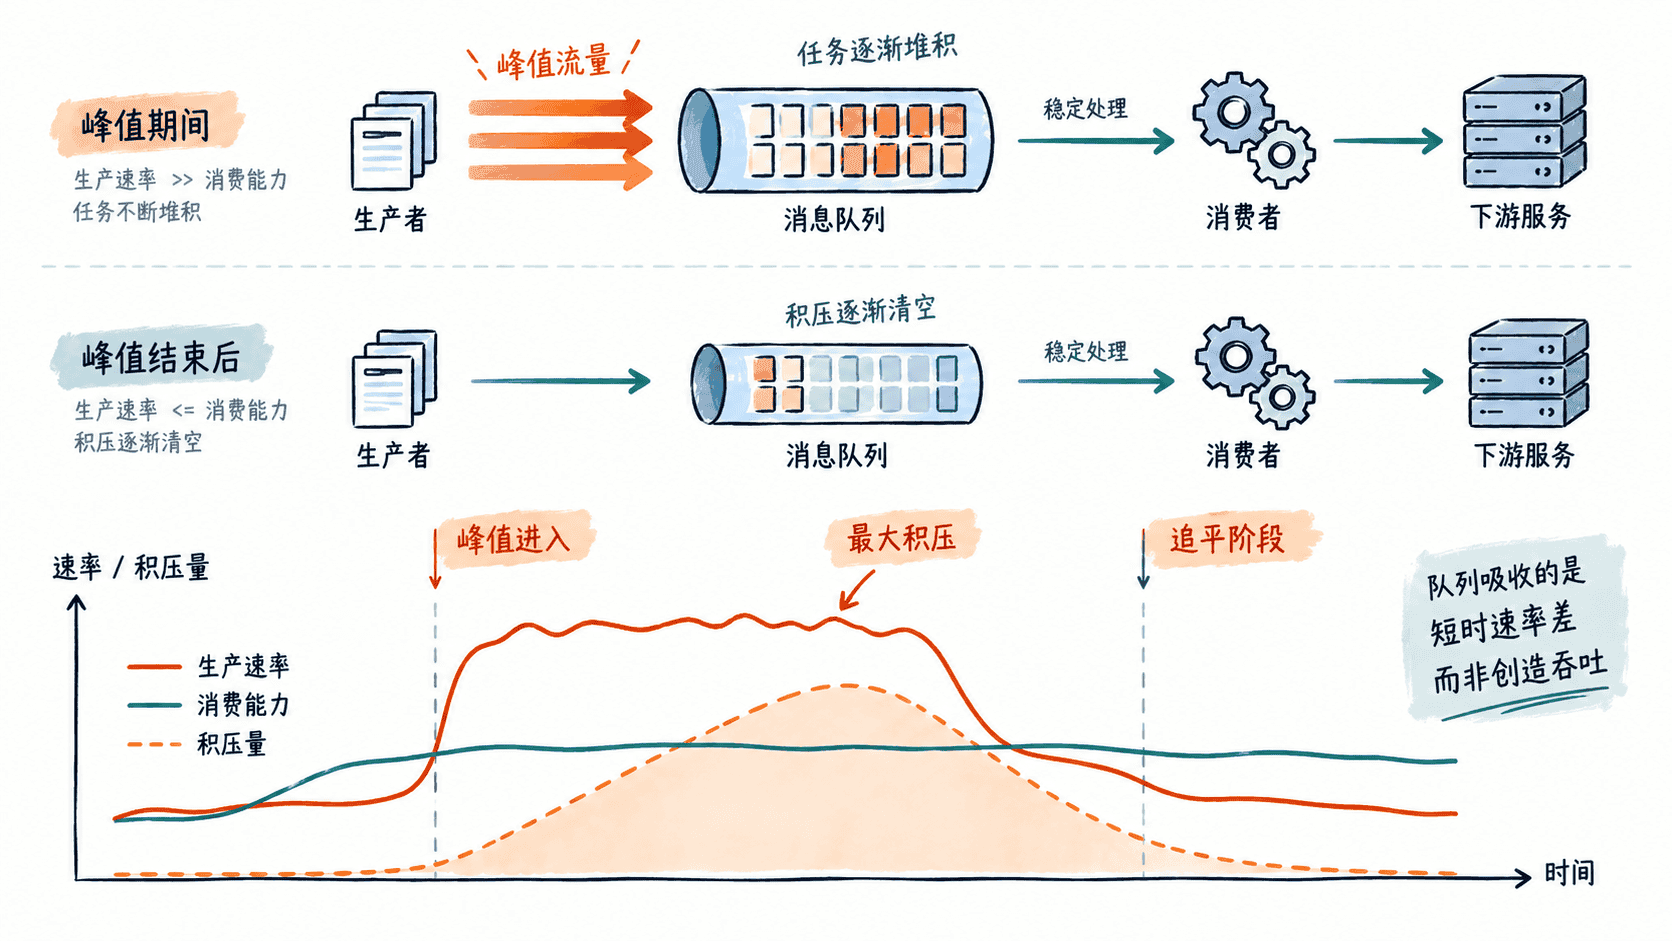
假设入口短时间达到每秒 5000 个任务,而后端稳定消费能力只有每秒 3000 个。如果高峰持续 20 秒,队列可以先保存暂时处理不完的任务,再由消费者在峰值结束后逐步追平。
关键是理解:当生产速率大于消费速率时,积压一定增长。设生产速率为 ,消费速率为 ,在一段时间 内新增积压近似为 。以上场景会新增约 40000 个待处理任务,因此队列至少要在容量和保留时间上容纳这一规模,并留出安全余量。
如果生产速率长期高于消费能力,队列只是把故障从“请求立即失败”改成“延迟不断增加并最终耗尽存储”。因此削峰方案必须同时给出峰值持续时间和恢复阶段的剩余消费能力。
用四个指标观察异步链路
只看队列长度很容易误判。相同的 10 万条积压,在每秒消费 10 万条和每秒消费 100 条的系统里风险完全不同。至少应同时观察生产速率、消费速率、积压量和最老消息等待时间。
| 指标 | 主要回答的问题 |
|---|---|
| 生产速率 | 上游正在以多快速度制造工作 |
| 消费速率 | 下游当前能够完成多少工作 |
| 积压量 | 尚未处理的工作总量有多少 |
| 最老消息等待时间 | 用户实际需要等待多久 |
其中最老消息等待时间尤其重要。只要它持续上升,就说明消费者仍未追上生产者;即使队列容量还很大,业务延迟也可能已经越过可接受边界。
阈值必须对应具体动作
队列监控不能只有一个“满了报警”的阈值。更实用的是按业务延迟预算设计多级水位,让系统在彻底耗尽前逐步减载。
例如正常区间保持完整功能;达到预警水位后限制非关键任务生产速率;达到高水位后对入口实施更严格限流,并暂停批处理、推荐刷新等低优先级工作;达到危险水位时直接拒绝部分新任务,避免队列、磁盘或下游数据库被拖垮。
阈值最好围绕预计等待时间而不只是消息条数。例如消费者稳定能力为每秒 2000 条,当前前方有 60000 条待处理任务,那么新任务仅排队就可能等待约 30 秒。如果业务承诺 10 秒内完成,即使队列还剩大量空间,也已经进入过载状态。
反压要一直传回真正的生产源
当消费者变慢时,只让消息中间件继续接收数据并不算完整的反压。有效的反压需要沿链路向上游传播,让真正制造新工作的入口感知到下游已经接近极限。
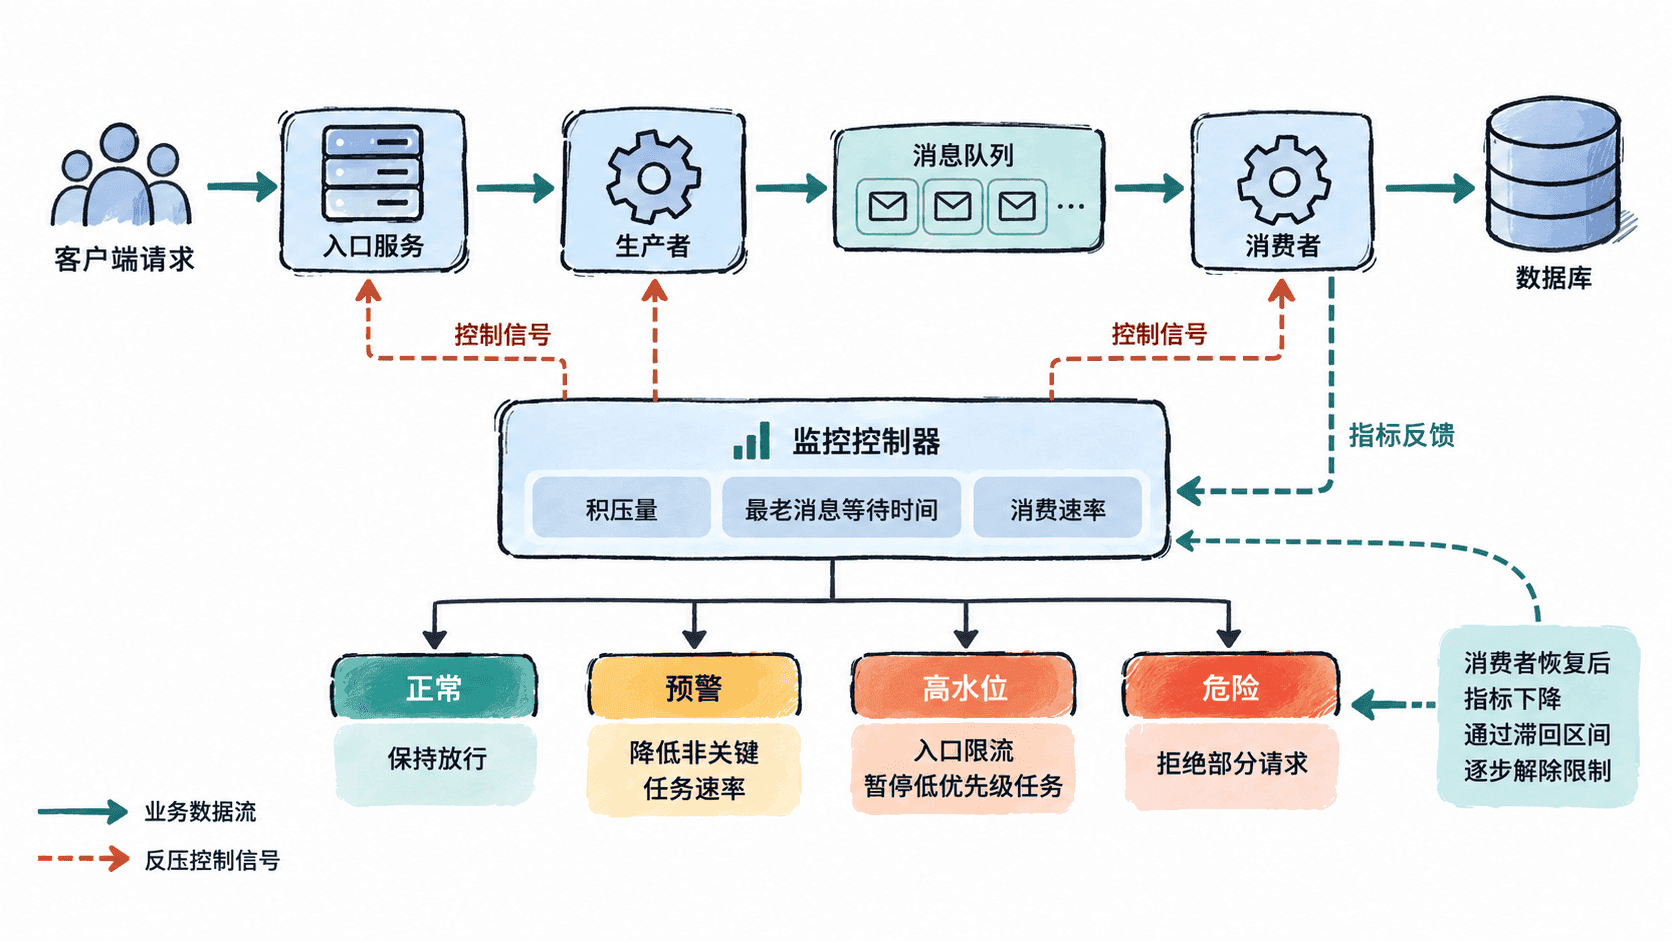
典型控制手段包括限制入口并发、降低生产速率、暂停低优先级任务、缩短批量请求、减少重试,以及在必要时快速失败。消费者侧则可以在确认下游仍有余量时增加并发实例,但不能把无限扩消费者当成唯一办法,因为数据库连接数、外部接口配额和锁竞争可能先成为瓶颈。
还要给恢复设置滞回区间。例如积压超过高水位时开始限流,不应刚低于该水位就立即全量恢复,否则生产和限流可能反复震荡。可以等积压降到更低的恢复水位并稳定一段时间,再逐步解除保护。
防止重试把积压变成雪崩
异步任务失败后通常需要重试,但立即无限重试会重新制造流量。如果下游已经过载,失败任务快速回队只会进一步提高生产速率,使正常任务也被淹没。
更安全的策略是限制最大重试次数,采用退避延迟,并把长期失败的任务转移到隔离队列等待人工或专门流程处理。还应保证消费操作具备幂等性,因为超时、消费者重启和消息重新投递都可能让同一任务被执行多次。
评审队列削峰方案时,最终需要回答三个问题:峰值会产生多少积压、多久能够追平、超过什么业务延迟时开始减载。只有这三个答案都明确,队列才是可控的缓冲层,而不是把过载隐藏起来的无限仓库。