
架构与系统设计 / 系统课时
设计安全重试与退避策略
设计安全重试与退避策略
本篇解决“错误一出现就立即重试”带来的故障放大问题:先判断操作是否安全、错误是否可恢复,再把重试次数、退避和随机抖动限制在同一请求预算内。
学习目标
- 判断错误与操作语义是否允许重试
- 设计有上限的指数退避与随机抖动
- 避免重试风暴、重复写入和预算失控
先判断请求能不能重试
重试必须同时满足两个条件:错误大概率是暂时性的,而且再次执行不会产生不可接受的副作用。网络连接重置、网关 502/503/504、限流 429 通常可能恢复;参数错误、鉴权失败等确定性 4xx 再试也不会变好。
写操作还要检查幂等性。GET、HEAD 一般可以安全重试;POST /orders 这类创建操作只有在服务端支持幂等键或去重机制时才适合自动重试。尤其要注意“客户端超时但服务端已经成功”的场景:如果没有幂等保护,再发一次可能创建两笔订单。
| 场景 | 默认策略 | 关键原因 |
|---|---|---|
| 连接重置、502、503、504 | 可有限重试 | 多为瞬时网络或过载故障 |
| 429 | 按服务端节奏重试 | 优先遵守 Retry-After |
| 400、401、403 | 不重试 | 请求本身或权限不会自行恢复 |
| 非幂等写且结果未知 | 不自动重试 | 可能产生重复副作用 |
把重试限制在同一总预算
重试次数不能单独配置成“最多 5 次”就结束。每次调用耗时、退避等待和下一次尝试都必须落在同一个端到端 deadline 内。否则第一次请求已经接近超时,客户端仍可能继续执行多轮重试,把故障拖得更久。
还要控制放大倍数。若一条链路有三层,每层都在失败后独立重试 3 次,最坏情况下请求数会呈乘法增长。通常应把重试放在最了解业务语义、最接近调用入口的一层,并让下层快速返回明确错误,而不是层层重试。
用退避和抖动拉开流量
指数退避会让连续重试间隔逐步增大,例如 200 ms、400 ms、800 ms;但如果大量客户端在同一时间失败,它们仍可能按相同节奏同时醒来,形成新的流量尖峰。因此生产策略还需要加入 jitter,让每个客户端在一个区间内随机选择等待时间。
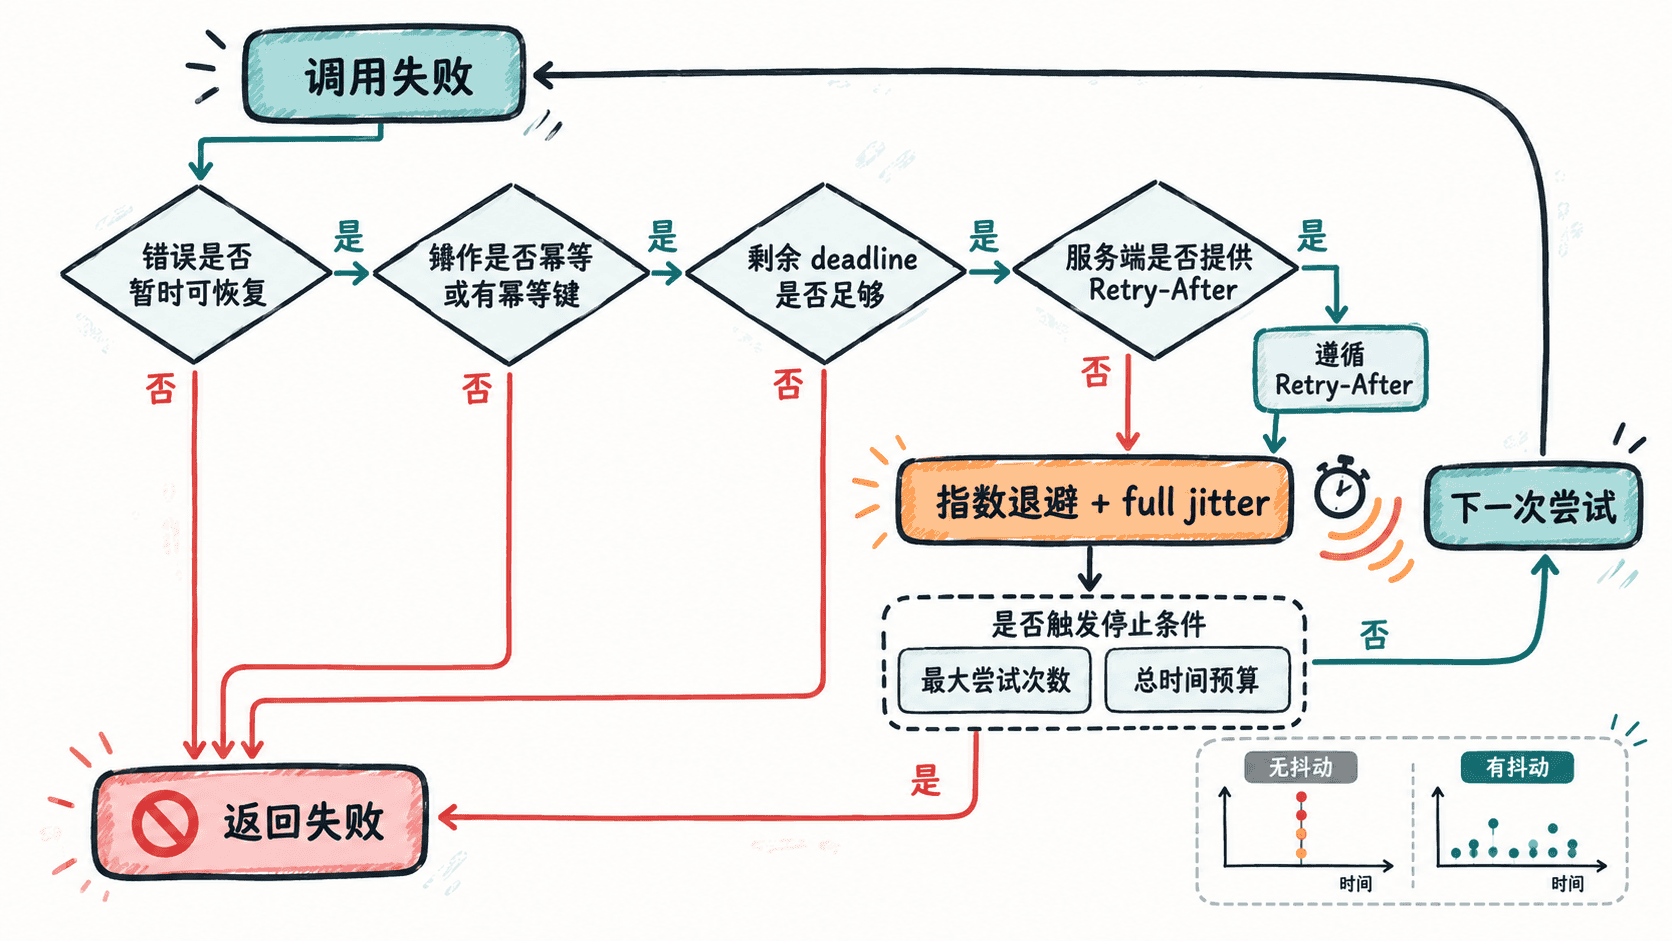
当服务端返回 Retry-After 时,应优先使用它,因为服务端比客户端更清楚恢复窗口。没有明确提示时,再使用带上限的指数退避。上限可以防止长时间故障把等待时间无限拉大。
用脚本生成有上限的全抖动
下面示例假设一次带幂等键的 POST 收到 503。策略允许最多 3 次重试,基础退避为 200 ms,采用 full jitter:每次在 0 到指数上限之间随机等待。固定随机种子只是为了让示例输出可复现。
import random

RETRYABLE_STATUS = {408, 425, 429, 500, 502, 503, 504}
IDEMPOTENT_METHODS = {"GET", "HEAD", "PUT", "DELETE"}

def full_jitter(base_seconds, retry_no, cap_seconds):
    ceiling = min(cap_seconds, base_seconds * (2 ** (retry_no - 1)))
    return ceiling, random.uniform(0, ceiling)

status = 503
method = "POST"
idempotency_key = "order-123"
remaining_ms = 1800

safe_operation = method in IDEMPOTENT_METHODS or bool(idempotency_key)
can_retry = status in RETRYABLE_STATUS and safe_operation and remaining_ms > 250

print(f"retry={can_retry}")

random.seed(7)
if can_retry:
    for retry_no in range(1, 4):
        ceiling, delay = full_jitter(0.2, retry_no, 1.0)
        print(
            f"retry={retry_no} max={ceiling:.3f}s sleep={delay:.3f}s"
        )
预期输出
retry=True
retry=1 max=0.200s sleep=0.065s
retry=2 max=0.400s sleep=0.060s
retry=3 max=0.800s sleep=0.521s
真实实现还要在每次睡眠前再次检查剩余 deadline;如果等待后已经没有足够时间完成下一次调用,就应直接停止,而不是机械执行完最大重试次数。
生产策略的边界
安全重试至少需要四个护栏:明确的可重试错误集合、幂等保证、最大尝试次数、统一时间预算。对高流量系统,还应增加全局或按下游划分的 retry budget,例如只允许一小部分请求进入重试,避免故障期间所有失败请求都翻倍打向下游。
监控时不要只看“最终成功率”。还要观察首次成功率、平均尝试次数、重试请求占比和重试后的成功率。如果重试量持续升高却几乎不带来额外成功,说明它已经从容错机制变成故障放大器,应更早熔断或快速失败。