
架构与系统设计 / 系统课时
用缓存降低热点读压力
用缓存降低热点读压力
缓存的价值不是“把数据放进内存”,而是把高频重复读从昂贵的后端路径上移走。本篇从缓存键、失效策略、穿透与击穿保护出发,构造一条完整的热点读链路,并说明如何用命中率判断收益、用一致性策略控制副作用。
学习目标
- 能设计稳定且可演进的缓存键与缓存粒度。
- 能区分过期、穿透、击穿和雪崩,并选择对应保护手段。
- 能用命中率、回源比例和一致性窗口评估缓存是否值得保留。
先定义缓存边界
缓存最适合高读低写、允许短时间陈旧、单次回源成本较高的数据。设计时先确定“缓存什么”,再决定“放多久”。如果把变化频繁且要求强一致的数据盲目缓存,只会把数据库压力换成复杂的一致性问题。
缓存键要同时表达业务身份和版本边界。例如商品详情可以使用 product:v2:<ID>,其中版本号用于结构升级,<ID> 对应实际商品 ID。不要把展示文案、时间戳等不稳定字段拼进键,否则会造成大量低复用缓存项。
设计读取与回源链路
典型的 Cache-Aside 读取流程是:先读缓存,命中直接返回;未命中时回源数据库,再把结果写回缓存。若多个请求同时发现同一个热点键失效,还需要加单飞锁、互斥重建或逻辑过期,避免所有请求同时打到后端。
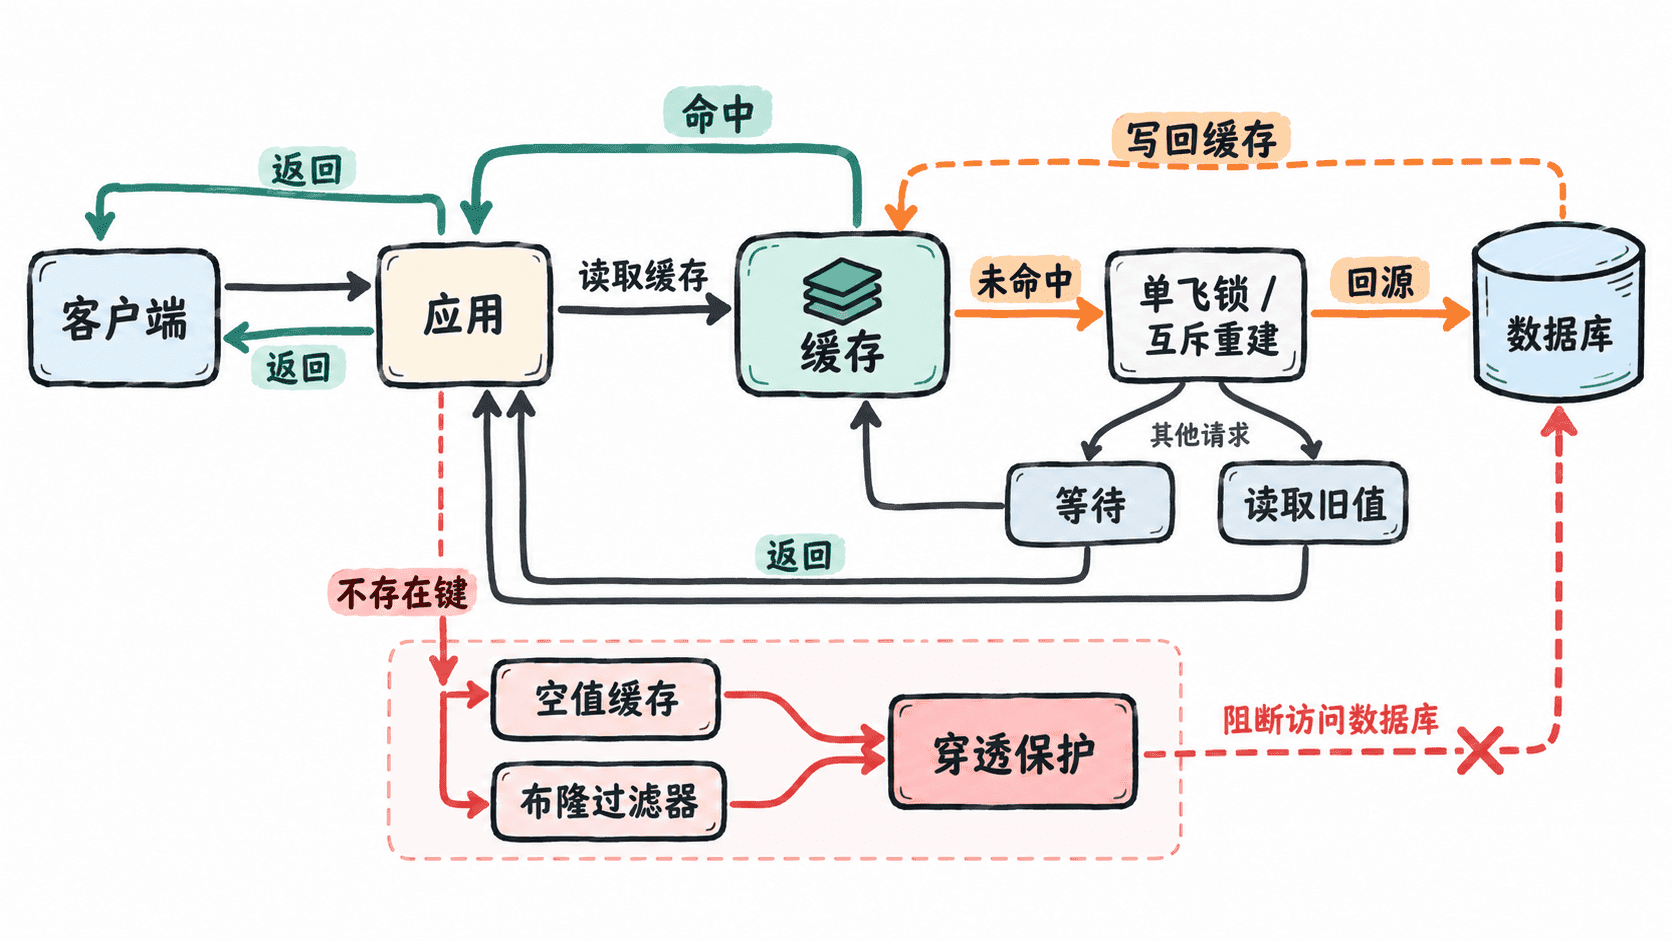
下面用一个可运行的 Python 示例模拟 Cache-Aside,并用短 TTL 展示命中与过期后的回源行为。
import time

database = {"product:42": {"name": "Keyboard", "price": 299}}
cache: dict[str, tuple[float, dict]] = {}

def get_product(product_id: str, ttl_seconds: int = 1) -> dict | None:
    key = f"product:{product_id}"
    now = time.time()

    cached = cache.get(key)
    if cached and cached[0] > now:
        print("cache hit")
        return cached[1]

    print("cache miss -> database")
    value = database.get(key)
    if value is not None:
        cache[key] = (now + ttl_seconds, value)
    return value

print(get_product("42"))
print(get_product("42"))
time.sleep(1.1)
print(get_product("42"))
预期输出
cache miss -> database
{'name': 'Keyboard', 'price': 299}
cache hit
{'name': 'Keyboard', 'price': 299}
cache miss -> database
{'name': 'Keyboard', 'price': 299}
真实系统中的时间值会随运行时刻变化,但命中顺序应保持一致:首次回源、TTL 内命中、过期后再次回源。
为失效和异常流量加保护
缓存常见风险不是同一种问题,处理手段也不相同。
| 问题 | 现象 | 常用保护 |
|---|---|---|
| 穿透 | 大量请求查询根本不存在的键 | 空值缓存、布隆过滤器、参数校验 |
| 击穿 | 单个热点键失效时大量并发同时回源 | 单飞锁、互斥重建、逻辑过期 |
| 雪崩 | 大量键在相近时间同时过期 | TTL 随机抖动、分批预热、多级缓存 |
TTL 不宜全部设置成完全相同的固定值,否则批量写入的热点数据可能在同一时刻失效。可以在基础 TTL 上增加小范围随机抖动,让回源压力在时间上摊开。
处理一致性成本
Cache-Aside 中最常见的更新策略是先写数据库,再删除缓存。这样下一次读取会重新加载新值。相比“同时更新数据库和缓存”,删除缓存更容易避免两个写入步骤之间的竞态,但仍然存在一个短暂不一致窗口。
如果业务要求“写后立即读到新值”,就要明确是否允许绕过缓存、使用版本号校验,或在写路径上做更强的同步。缓存策略必须服从业务一致性目标,而不是反过来让业务适应缓存实现。
用命中率判断是否真的减压
缓存收益可以先用一个简单关系估算:后端回源比例约等于 ,其中 是命中率。若原始读取为 10,000 RPS,命中率为 95%,理想情况下只有约 500 RPS 需要回源;如果命中率只有 20%,则仍有约 8,000 RPS 打到后端,复杂度可能大于收益。
上线后至少同时观察命中率、回源 RPS、缓存延迟、淘汰次数和后端负载。若缓存节点已成为新的延迟热点或单点,就需要分片、副本、多级缓存或降级策略,而不是继续简单扩容数据库。
一个好的缓存方案应同时满足三件事:热点请求大多在缓存层结束,缓存失效不会把瞬时并发全部放大到后端,一致性窗口在业务可接受范围内。