
架构与系统设计 / 系统课时
设计数据库零停机变更
设计数据库零停机变更
数据库变更最危险的时刻,是新旧应用版本同时运行。零停机迁移的核心不是一条“无锁 SQL”,而是把一次破坏性改动拆成扩展、迁移、切换和收缩,使任一阶段都能兼容并可回退。
学习目标
- 用扩展再收缩顺序拆解字段、索引和约束变更
- 识别新旧应用并存时的读写兼容风险
- 为回填、切流、约束收紧和删除旧结构设计验证点
把破坏性 DDL 拆成多个安全阶段
假设 users.full_name 要拆成 first_name 与 last_name。如果先删除 full_name,旧应用会立即失败;如果先把新列设为 NOT NULL,历史数据又无法满足约束。
安全顺序是:先增加新结构但不强迫旧代码使用,再让应用双写并回填历史数据,之后切换读取,最后才删除旧结构。
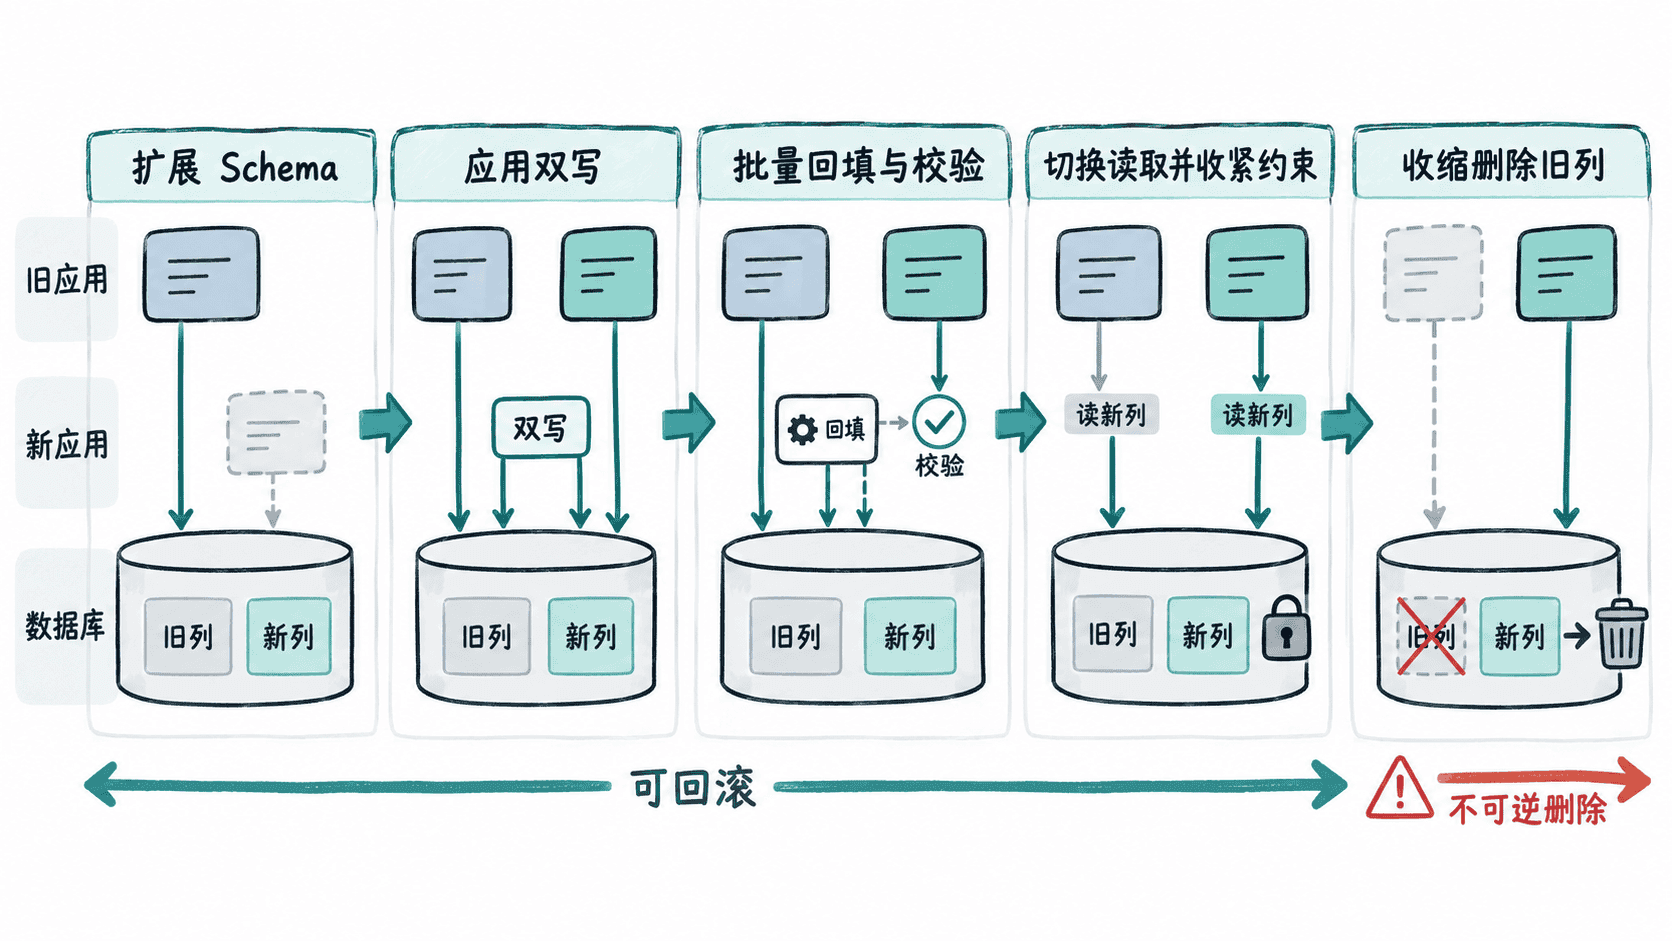
先扩展结构,再发布兼容应用
第一步只添加新列,不删除旧列,也不要立刻增加会拒绝历史数据的强约束。下面以 PostgreSQL 为例:
ALTER TABLE users
  ADD COLUMN first_name text,
  ADD COLUMN last_name text;
预期结果:
ALTER TABLE此时旧应用仍读写 full_name,不会感知新增列。新应用发布后进入双写期:新请求同时维护旧列和新列,读取仍优先走旧字段,保证回滚应用版本时不会丢失新写入。
回填历史数据时控制锁与负载
历史数据不要一次性全表更新。应按主键或时间范围分批回填,限制每批行数,并观察复制延迟、锁等待、CPU 与 I/O。回填逻辑必须可重复执行,已经迁移完成的行应能安全跳过。
切换读取前,至少验证两类条件:新列覆盖率达到目标,且新旧字段转换结果一致。只有数据质量通过验证,才能让新版本开始以新列为主读。
如果需要新增索引,大表应优先使用数据库支持的在线或并发建索引能力。例如 PostgreSQL 可使用 CREATE INDEX CONCURRENTLY,避免长时间阻塞普通读写;具体能力和限制应按所用数据库版本确认。
收紧约束要晚于数据迁移
NOT NULL、唯一约束、外键等约束,应该在新数据和历史数据都满足规则后再添加。否则约束会把迁移本身变成故障源。
推荐的切换检查顺序是:
- 新应用已稳定双写,旧应用仍可运行。
- 历史数据回填完成,并通过一致性校验。
- 读取路径切到新字段,观察错误率和业务指标。
- 所有仍在线的应用版本都不再依赖旧字段。
- 再添加强约束、停止旧字段写入并进入删除窗口。
在每一步之间保留观察期,可以让问题停留在仍可回滚的阶段。
删除旧结构是最后一步
删除列、重命名为新语义、修改不可兼容类型,都属于收缩阶段。执行前要确认旧应用已经完全下线,后台任务、报表、ETL、脚本和只读工具也不再访问旧结构。
对于高风险删除,可以先停止写入旧列但暂时保留读取,再监控一段时间是否仍有访问;确认没有依赖后再真正删除。这样即使遗漏了低频调用方,也有机会在不可逆 DDL 之前发现。
零停机数据库变更的判断标准不是“SQL 执行时没有报错”,而是整个发布窗口里新旧应用、历史数据和约束始终存在一条兼容路径。扩展阶段创造兼容空间,收缩阶段只在依赖清零后发生。