
架构与系统设计 / 系统课时
判断何时需要拆成微服务
判断何时需要拆成微服务
把模块拆成微服务不是架构成熟度升级,而是用网络、运维和一致性成本换取更强的独立性。本节用可验证的四类信号判断拆分收益,并用一个可执行评分脚本做初筛,避免凭感觉拆服务。
学习目标
- 能从扩缩容、发布、故障隔离和团队边界判断拆分收益
- 能把网络、一致性、可观测性等分布式成本纳入同一决策
- 能识别“代码很多”或“团队想用新技术”等不足以拆分的信号
先确认拆分要解决的问题
微服务首先是独立部署和独立运行的边界,不只是代码仓库里的目录变化。若一个模块拆出去后仍必须和原系统同时发布、共享同一批表、同步扩容,并且故障仍会沿同步调用链传播,那么你承担了分布式成本,却没有得到主要收益。
真正值得优先评估的,是已经出现明确运行差异的业务能力。例如某个模块需要单独扩容、发布频率明显更高、故障必须被隔离,或者已经由稳定独立的团队长期负责。
用四类信号判断拆分收益
| 驱动因素 | 强信号 | 需要的证据 |
|---|---|---|
| 独立扩缩容 | 单个模块长期成为容量热点 | CPU、吞吐、队列或存储指标能单独归因 |
| 发布节奏 | 模块需要频繁独立上线 | 发布记录显示它常被其他模块拖慢 |
| 故障隔离 | 某能力失败不应拖垮主链路 | 事故记录能说明当前故障域过大 |
| 团队边界 | 团队能端到端负责该能力 | 代码、数据、SLO 和值班责任边界稳定 |
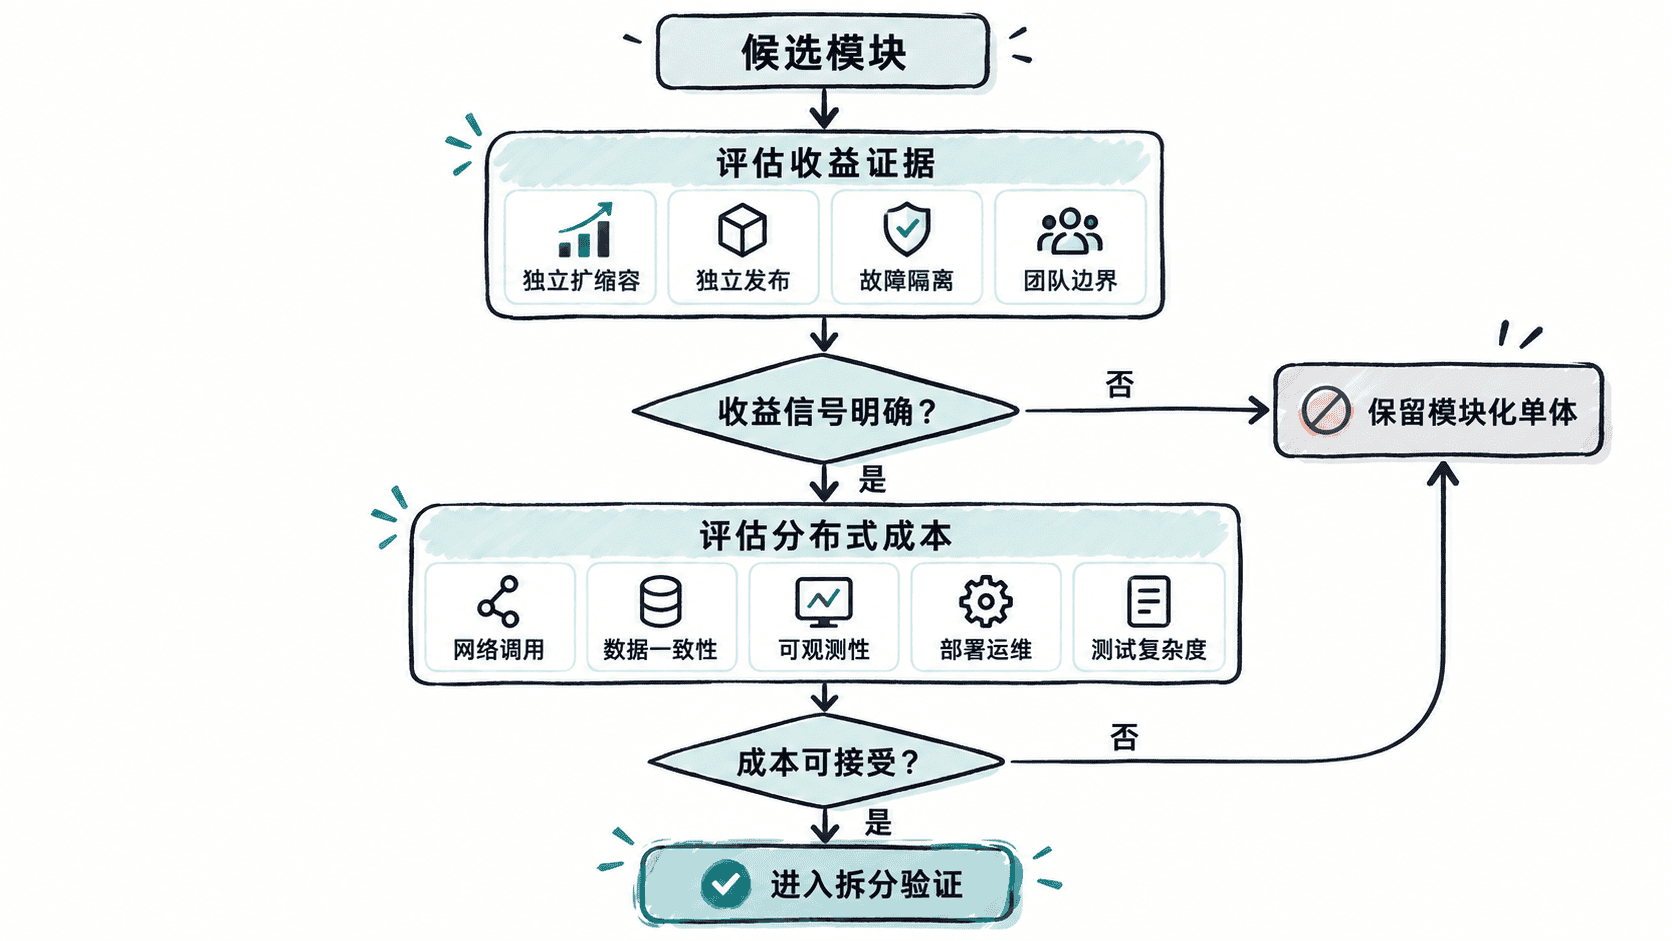
四类信号不要求全部满足,但至少应有一到两个强信号,并且能用运行数据或组织事实验证。没有证据的“以后可能需要”通常不足以支付现在的拆分成本。
把分布式成本一起记账
拆分后,进程内调用会变成网络调用,单事务可能变成最终一致,日志排查会跨进程,部署、监控、限流、重试和容量管理也都需要独立能力。边界越多,这些成本越容易叠加。
特别要警惕“为了拆而拆”的同步调用链。如果一次用户请求必须连续经过多个微服务才能完成,任何一个节点的超时、重试或抖动都会放大端到端延迟和故障面。此时先改善模块边界,往往比立刻增加服务数量更有效。
用可执行评分做初筛
下面的脚本不是通用公式,而是一个决策记录工具:收益项分数越高越有拆分价值,成本项分数越高越需要谨慎。把分值替换成团队基于真实指标得到的评估即可。
drivers = {
    "independent_scaling": 3,
    "release_independence": 2,
    "fault_isolation": 3,
    "team_boundary": 2,
}

costs = {
    "cross_service_transactions": 2,
    "sync_call_dependency": 1,
    "operations_gap": 1,
}

benefit = sum(drivers.values())  # 收益与成本分开记录,避免只看好处
cost = sum(costs.values())
net = benefit - cost  # 净收益用于判断是否值得进入验证阶段

decision = (
    "进入拆分验证"
    if benefit >= 8 and net >= 3
    else "保留模块化单体"
)

print(f"benefit={benefit}, cost={cost}, net={net}")
print(f"decision={decision}")
预期输出
benefit=10, cost=4, net=6
decision=进入拆分验证
如果把 operations_gap 提高到 4,脚本会反映出基础设施和运维成熟度不足正在吞噬拆分收益。分数本身不是答案,关键是把“为什么拆”和“代价是什么”同时写进评审记录。
用证据复核最终决定
评分通过后,再做一次证据复核:容量热点是否真的能独立扩容,发布是否真的能独立,故障是否能通过进程边界缩小爆炸半径,团队是否能独立承担数据和 SLO。任一关键项依赖“未来再说”,都应降低拆分优先级。
如果当前问题只是代码量大、目录混乱、模块依赖失控,先做模块化单体通常更合适:明确依赖方向、隔离数据所有权、建立内部 API,并把高耦合改造成稳定边界。只有当独立运行带来的收益已经能覆盖分布式成本时,微服务拆分才是工程决策,而不是架构口号。