
PostgreSQL / 系统课时
建立高可用故障切换手册
建立高可用故障切换手册
高可用系统真正需要的不是一条提升命令,而是一套值班人员在压力下仍能按证据执行的流程。本课把故障确认、数据风险判断、旧主 fencing、备库提升、流量迁移、验收和旧主处置串成一份带门禁的故障切换手册。
学习目标
- 把监控信号和复制状态转换为明确的切换决策条件。
- 按先 fencing、后提升、再迁移流量的顺序安全执行故障切换。
- 用数据库、复制和业务三层证据完成切换验收与旧主处置。
把故障切换写成有门禁的流程
生产手册不能只写“主库故障后提升备库”。真正可执行的流程必须回答:是否确实需要切换、是否可能产生双主,以及切换后如何证明新主已经安全接管。
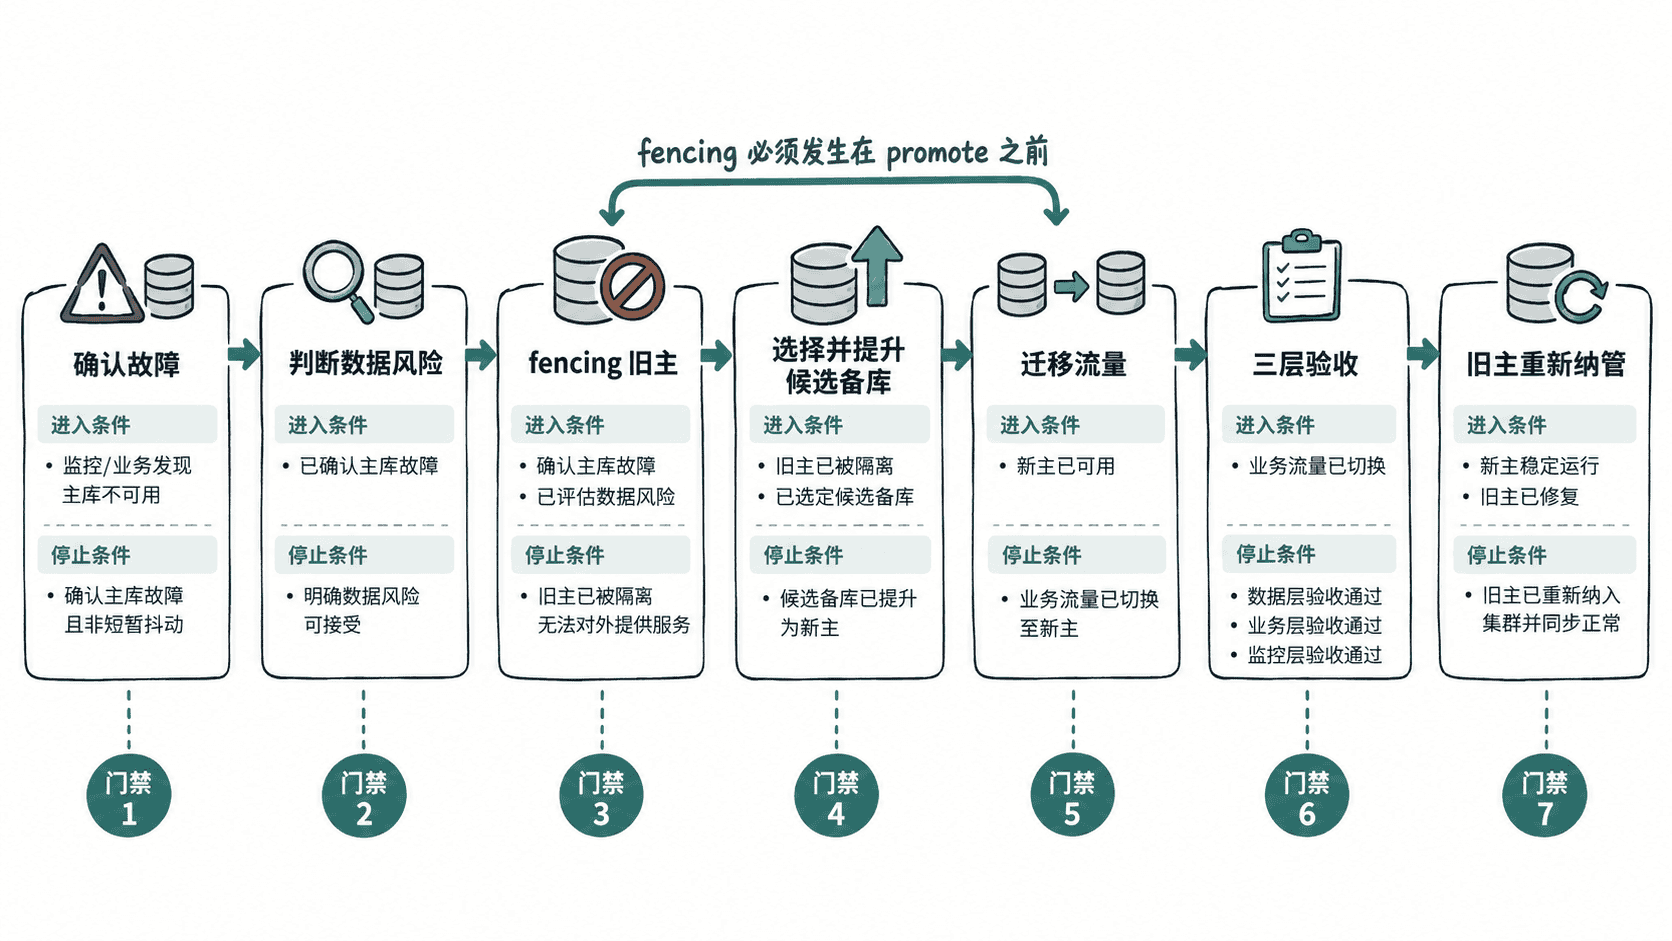
建议固定为:确认故障 → 判断数据风险 → fencing 旧主 → 选择并提升候选备库 → 迁移流量 → 验收新主 → 重新处置旧主。任何阶段证据不足,都应停止推进,而不是跳过门禁。
先收集证据再决定是否切换
收到主库不可用告警后,先确认这是持续故障,而不是网络瞬断、负载抖动或连接池异常。至少同时观察数据库连接、主机或实例状态,以及候选备库的复制状态。
SELECT pg_is_in_recovery() AS is_standby,
       pg_last_wal_receive_lsn() AS receive_lsn,
       pg_last_wal_replay_lsn() AS replay_lsn,
       pg_last_xact_replay_timestamp() AS last_replay_time;
预期结果
 is_standby | receive_lsn | replay_lsn | last_replay_time
------------+-------------+------------+------------------
 t          | <VALUE>     | <VALUE>    | <TIME>
(1 row)
LSN 和时间值会随运行状态变化。候选节点必须仍处于恢复状态,且回放位置应尽可能接近已接收位置。如果复制早已中断或延迟明显,就不能把“实例能启动”误认为“数据足够新”。
如果主库仍可访问,应额外记录主库当前 WAL 位置并与备库回放位置比较。主库已经彻底失联时,无法证明故障前最后一批尚未复制的数据已经到达备库;异步复制下必须按业务 RPO 判断是否接受这一数据丢失窗口。
fencing 必须发生在提升之前
故障切换最危险的情况不是提升失败,而是旧主恢复后重新接受写入,同时新主也开始写入,形成 split-brain。因此,“确认旧主无法重新提供写服务”必须是提升前的硬门禁。
fencing 可以由主机关停、虚拟机隔离、网络阻断、负载均衡摘除或云平台控制实现。若 PostgreSQL 由 systemd 管理,至少要同时停止服务并阻止服务管理器自动拉起,而不能只执行一次 pg_ctl stop。
sudo systemctl stop <SERVICE>
sudo systemctl mask <SERVICE>
systemctl is-active <SERVICE>
systemctl is-enabled <SERVICE>
预期输出
inactive
masked
<SERVICE> 替换为实际 PostgreSQL systemd 单元名。mask 只能阻止该 systemd 单元被正常启动,并不等价于完整的基础设施 fencing;如果还有容器编排、云平台自愈、其他服务管理器或独立网络路径,必须同时禁用自动恢复或隔离节点,并从应用访问路径验证旧主确实不可写。
提升候选备库并确认角色切换
完成 fencing 后才能提升候选备库。候选节点应满足数据位置尽可能新、实例与磁盘健康,并且没有明显恢复错误。对于由 pg_ctl 管理的实例,可以执行提升:
pg_ctl -D <PATH> promote预期输出
waiting for server to promote.... done
server promoted
命令成功只说明提升请求已经完成,不能直接作为迁移流量的依据。还应从数据库内部确认实例已经退出恢复状态并开始产生新的 WAL。
SELECT pg_is_in_recovery() AS is_standby,
       pg_current_wal_lsn() AS current_wal_lsn;
预期结果
 is_standby | current_wal_lsn
------------+-----------------
 f          | <VALUE>
(1 row)
当 pg_is_in_recovery() 返回 f 时,实例已经退出恢复状态。若提升后仍持续报错、磁盘只读或关键依赖不可用,应停止流量迁移并先恢复数据库健康。
迁移流量后分三层验收
应用入口可以通过 VIP、代理、服务发现、DNS 或连接池配置切换到新主。修改入口不代表旧连接立即消失,长连接应用还需要刷新连接池或回收旧连接,避免继续尝试访问已经被隔离的旧主。
流量切换后先执行最小写入验证。生产环境应使用专门的健康检查表或业务允许的探测机制,下面假设已经准备好 ha_failover_probe 表。
INSERT INTO ha_failover_probe(probe_time, source)
VALUES (clock_timestamp(), 'failover-check')
RETURNING probe_time, source;
预期结果
          probe_time          |     source
------------------------------+----------------
 <TIME>                       | failover-check
(1 row)

INSERT 0 1
随后从三层完成验收:数据库层确认新主可稳定读写且无持续错误;复制层确认预期保留的下游备库已经重新连接;业务层确认核心接口成功率、错误率和延迟恢复到允许范围。
SELECT application_name,
       state,
       sync_state,
       sent_lsn,
       replay_lsn
FROM pg_stat_replication;
预期结果
 application_name |   state   | sync_state | sent_lsn | replay_lsn
------------------+-----------+------------+----------+------------
 <VALUE>          | streaming | <VALUE>    | <VALUE>  | <VALUE>
(<VALUE> rows)
节点名称、LSN 和行数取决于实际拓扑。重点是预期继续服务的备库应恢复为 streaming,不能只确认新主可以写入就宣布事件结束。
旧主必须重新对齐后再加入
故障切换后,旧主的时间线可能已经与新主分叉。即使它重新启动,也不能直接重新开放写流量。标准处置是继续保持隔离,再通过重新做基础备份,或在满足条件时使用 pg_rewind,把旧主重新对齐到新主后以备库身份加入。
手册还应记录首次告警、确认故障、完成 fencing、发起提升、新主可写、流量切换完成、业务恢复和旧主重新纳管等关键时间点,用于计算实际 RTO 并定位事件耗时。
一份合格的故障切换手册本质上是一组带证据的门禁:没有确认数据风险就不宣称零丢失,没有完成可持续的 fencing 就不提升,没有数据库、复制和业务验收就不宣布恢复,没有重新对齐旧主就不让它回到拓扑中。