
PostgreSQL / 系统课时
理解查询与 WAL 回放冲突
理解查询与 WAL 回放冲突
Hot Standby 允许备库一边提供只读查询,一边重放主库产生的 WAL。本课关注两者不能同时成立时 PostgreSQL 如何取舍,并用更可控的实验条件观察快照类恢复冲突,而不是把一次 VACUUM 误当成必然触发器。
学习目标
- 识别查询与 WAL 回放发生恢复冲突时的典型现象
- 理解
max_standby_streaming_delay对查询取消与回放延迟的影响 - 使用冲突统计和复制进度确认冲突是否真实发生
冲突的本质
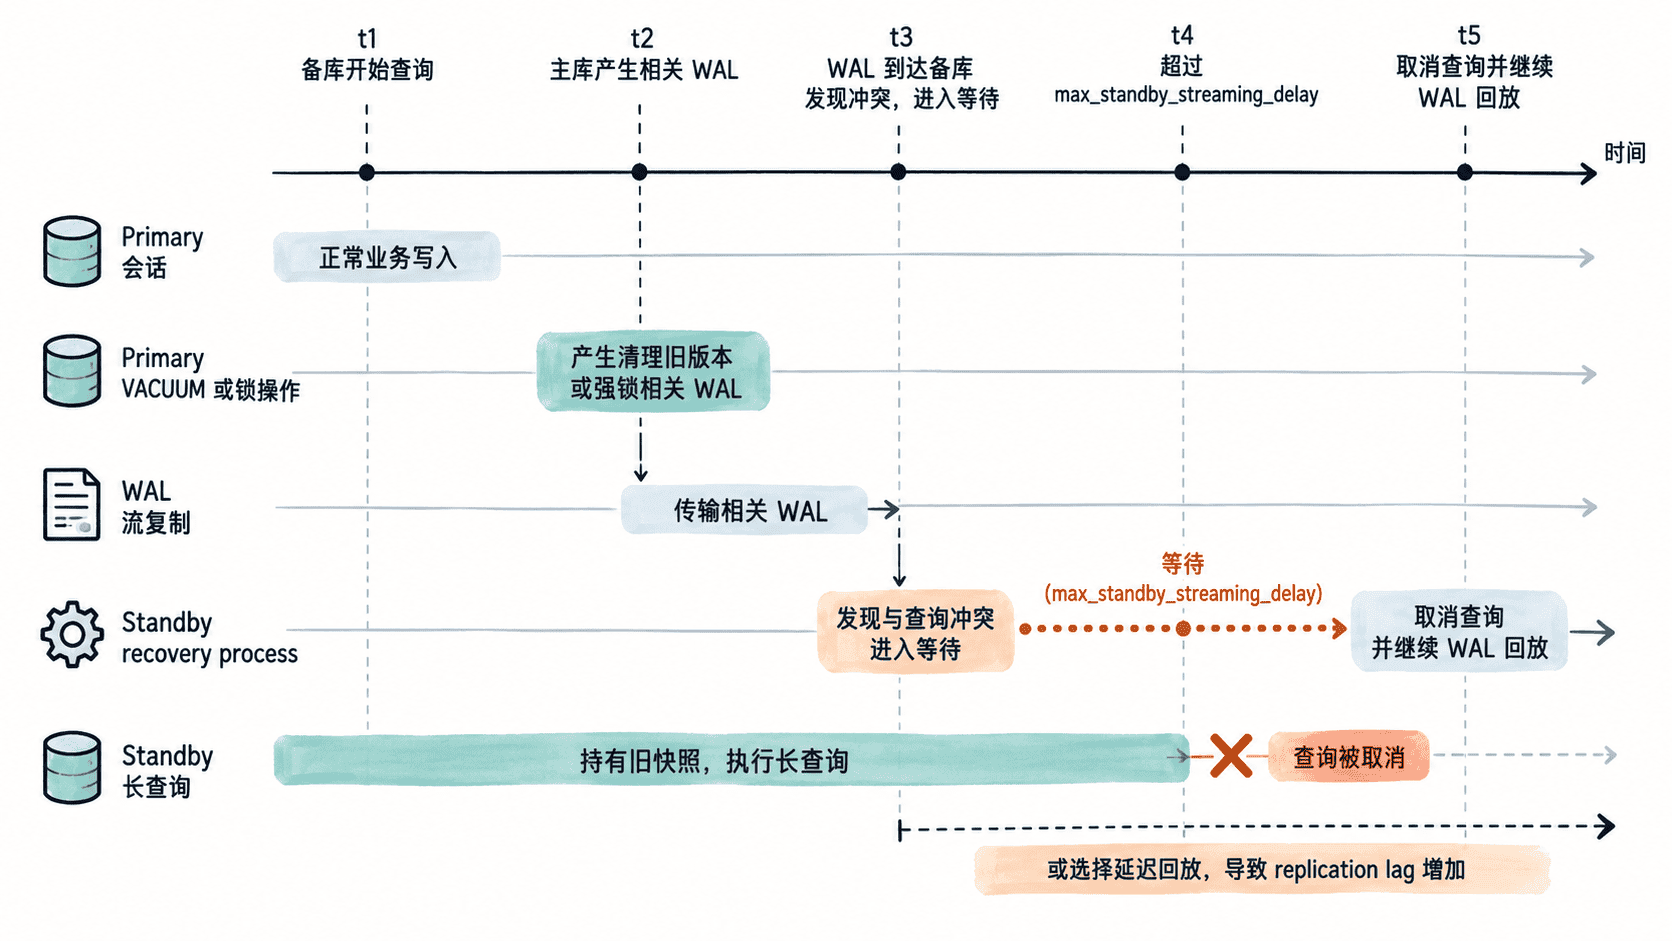
主库执行 DDL、清理旧行版本等操作后,相应 WAL 最终必须在备库生效。若备库查询仍依赖与这些 WAL 不兼容的锁、快照或缓冲页状态,恢复进程只能先等待;等待预算耗尽后,会取消冲突查询,让 WAL 继续重放。
快照类冲突最直观:备库查询仍需要看到旧行版本,而主库已经删除这些行并由 VACUUM 产生了可清理旧版本的 WAL。恢复不能回滚主库已提交的事实,只能在“继续等查询结束”和“取消查询推进恢复”之间选择。
先确认冲突类型
pg_stat_database_conflicts 在备库累计因恢复冲突而取消查询的次数。诊断时应先记录基线,再观察故障窗口内哪一列增长。
SELECT datname,
       confl_snapshot,
       confl_lock,
       confl_bufferpin,
       confl_deadlock
FROM pg_stat_database_conflicts
WHERE datname = current_database();
预期结果
 datname | confl_snapshot | confl_lock | confl_bufferpin | confl_deadlock
---------+----------------+------------+-----------------+---------------
 <VALUE> | <VALUE>        | <VALUE>    | <VALUE>         | <VALUE>
(1 row)
confl_snapshot 增长通常指向旧快照与清理 WAL 的冲突;confl_lock 指向恢复锁冲突;confl_bufferpin 与长时间固定缓冲页有关。计数是累计值,因此要比较前后增量,不能只看某个绝对值。
构造更可靠的快照冲突实验
原先“先查询,再单独 pg_sleep”并不可靠:默认 READ COMMITTED 下,前一条语句的快照不会因为下一条睡眠语句继续保留;一次普通 VACUUM 也未必恰好产生与该查询冲突的清理 WAL。更稳妥的做法是显式满足条件,并让同一条长查询在扫描期间持续持有快照。
实验只应放在可丢弃环境。先在备库确认恢复状态和关键参数。
SELECT pg_is_in_recovery() AS in_recovery,
       current_setting('hot_standby_feedback') AS hot_standby_feedback,
       current_setting('max_standby_streaming_delay') AS max_delay;
预期结果
 in_recovery | hot_standby_feedback | max_delay
-------------+----------------------+-----------
 t           | off                  | <VALUE>
(1 row)
若 hot_standby_feedback 为 on,主库可能保留备库仍需要的旧版本,此时不应期待快照清理冲突稳定出现。实验还应使用有限的等待预算,并让长查询持续时间明显超过该预算;不要为实验直接修改生产备库。
在主库准备数据。
CREATE TABLE IF NOT EXISTS standby_demo (
    id bigint PRIMARY KEY,
    payload text
);

TRUNCATE standby_demo;

INSERT INTO standby_demo (id, payload)
SELECT g, repeat('x', 200)
FROM generate_series(1, 10000) AS g;
预期结果
CREATE TABLE
TRUNCATE TABLE
INSERT 0 10000
等待备库已重放这批 WAL,再确认数据可见。
SELECT count(*) AS rows_visible
FROM standby_demo;
预期结果
 rows_visible
--------------
        10000
(1 row)
在备库会话 A 启动一条故意拉长的扫描。子查询中的 pg_sleep 只是实验手段,用来让同一条 SELECT 的快照持续存在。
SELECT count(*) AS scanned
FROM (
    SELECT id, pg_sleep(0.01)
    FROM standby_demo
) AS slow_scan;
预期结果(未形成恢复冲突时)
 scanned
---------
   10000
(1 row)
实验目标是让主库的清理 WAL 在这条查询仍运行时到达;若形成冲突并超过等待预算,会话 A 会被恢复进程取消,而不会返回上述计数。让会话 A 保持运行,在主库删除全部行、执行清理并记录 WAL 位置。
DELETE FROM standby_demo;
VACUUM standby_demo;
SELECT pg_current_wal_lsn() AS cleanup_lsn;
预期结果
DELETE 10000
VACUUM
 cleanup_lsn
-------------
 <VALUE>
(1 row)
随后在备库观察接收与回放位置。
SELECT pg_last_wal_receive_lsn() AS received_lsn,
       pg_last_wal_replay_lsn() AS replayed_lsn;
预期结果
 received_lsn | replayed_lsn
--------------+--------------
 <VALUE>      | <VALUE>
(1 row)
只有当相关清理 WAL 已经到达备库、查询仍持有需要旧版本的快照,并且等待预算在查询结束前耗尽,取消才会发生。若触发成功,会话 A 会收到 recovery conflict 相关错误,之后 confl_snapshot 应比基线增加;如果接收位置尚未推进到清理 WAL,则还不能把“没有报错”解释成“没有冲突”。
等待预算不是查询超时
max_standby_streaming_delay 控制的是备库为已经接收、但因冲突暂时不能重放的流式 WAL容忍多长时间,不是每条查询从开始执行起都有同样长的独立计时器。已经积累的回放延迟会消耗这份预算,后续冲突查询可能更快被取消。
SHOW max_standby_streaming_delay;预期结果
 max_standby_streaming_delay
-----------------------------
 <VALUE>
(1 row)
较小的值更偏向保护高可用时效;较大的值更偏向保护长查询,但会允许更大的回放滞后。
从现象定位到治理
遇到备库查询被取消时,先比较 pg_stat_database_conflicts 的前后增量,再结合长查询和 WAL 接收、回放位置确认冲突链路。高可用备库通常优先缩短或拆分分析查询;分析型备库则可以在可接受的复制滞后范围内适当增加等待预算。
对于快照类冲突,hot_standby_feedback 可以减少主库清理掉备库仍需要版本的机会,但代价是主库可能更久地保留死元组并增加膨胀风险。目标不是让冲突计数永远为零,而是让查询稳定性、主库空间成本与故障切换时效符合这台备库的职责。