
PostgreSQL / 系统课时
判断主库是否需要切换
判断主库是否需要切换
主库连接失败时,第一目标不是立刻提升备库,而是判断故障到底发生在数据库进程、主机、存储还是网络。只有确认原主库无法在目标 RTO 内安全恢复,并且它已失去继续写入的可能,故障切换才进入正确的执行条件。
学习目标
- 按客户端路径、数据库进程、主机与存储的顺序收集故障证据
- 判断哪些故障应原地恢复,哪些故障需要进入备库提升流程
- 在旧主库状态不确定时先执行隔离,避免形成双主
先把“连不上”拆成故障层级
应用报连接失败只能证明“应用到数据库的路径不可用”,不能证明主机已宕机。DNS、负载均衡、防火墙、端口监听、PostgreSQL 进程、操作系统、磁盘 I/O 都可能制造相同现象。
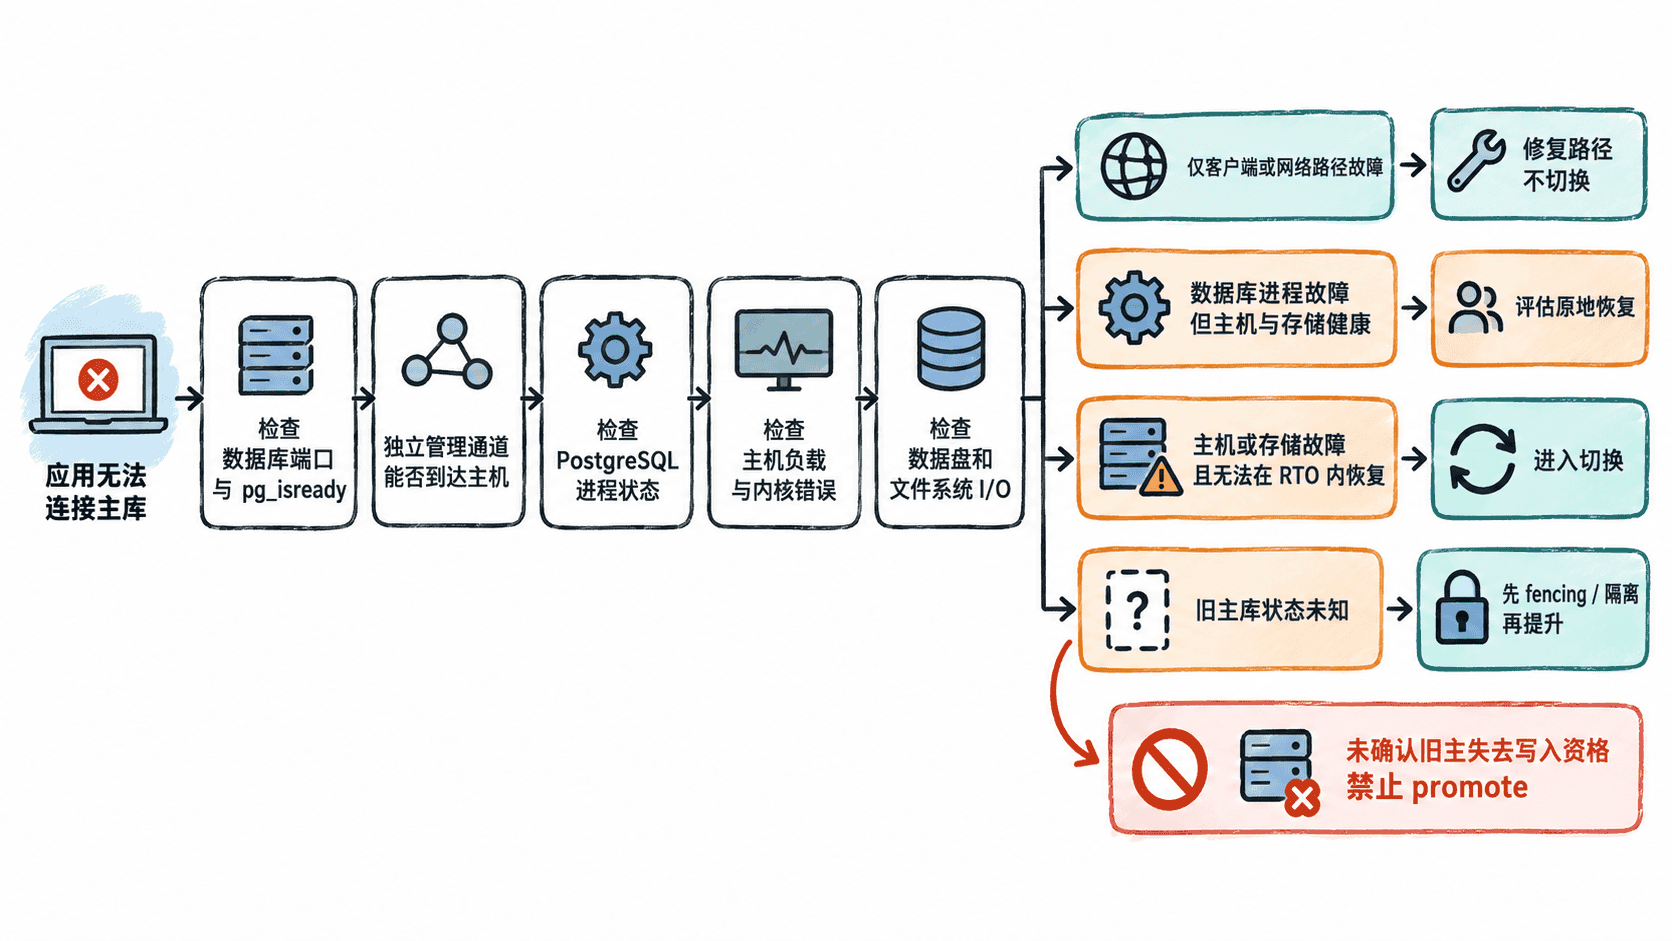
因此故障判断应从多个独立视角取证:业务侧确认影响范围,管理网络检查 TCP 与 PostgreSQL 响应,主机侧确认进程和系统状态,存储侧确认数据盘是否可读写。只有证据链闭合,才决定原地恢复还是切换。
从独立路径确认数据库与端口
先从运维终端而不是应用容器内部检查主库。下面的命令同时验证 PostgreSQL 协议响应和 TCP 端口。如果 pg_isready 失败但 TCP 可以建立连接,可能是 PostgreSQL 忙、启动中、拒绝连接或协议层异常;两者都失败则继续检查网络或主机。
export PRIMARY_HOST="db-primary.example.com"
export PRIMARY_PORT="5432"

pg_isready -h "$PRIMARY_HOST" -p "$PRIMARY_PORT" -t 3
timeout 3 bash -c "cat < /dev/null > /dev/tcp/$PRIMARY_HOST/$PRIMARY_PORT" \
  && echo "tcp reachable" \
  || echo "tcp unreachable"
预期输出
db-primary.example.com:5432 - accepting connections
tcp reachable
故障时输出会不同,例如 no response 或 tcp unreachable。这里不要把某一种失败文本当成自动切换条件,因为防火墙、路由、监听地址和主机宕机都可能产生相似结果。
通过管理通道检查主机、进程和存储
如果还有独立管理通道,继续在主机侧取证。以下示例检查 PostgreSQL 进程、主机负载、数据目录空间与 inode;数据目录路径必须按实际部署修改。
export PRIMARY_HOST="db-primary.example.com"
export PRIMARY_DATA_DIR="/var/lib/postgresql/data"

ssh "postgres@$PRIMARY_HOST" "
  pg_ctl status -D '$PRIMARY_DATA_DIR' || true
  uptime
  df -h '$PRIMARY_DATA_DIR'
  df -i '$PRIMARY_DATA_DIR'
"
预期输出
pg_ctl: server is running (PID: <PID>)
<TIME> up <VALUE>, <VALUE> users, load average: <VALUE>, <VALUE>, <VALUE>
Filesystem      Size  Used Avail Use% Mounted on
<DEVICE>        <SIZE> <SIZE> <SIZE> <VALUE>% <PATH>
Filesystem      Inodes IUsed IFree IUse% Mounted on
<DEVICE>        <VALUE> <VALUE> <VALUE> <VALUE>% <PATH>
实际 PID、负载、容量和 inode 数会变化;部分发行版需要用完整路径调用 pg_ctl。如果 PostgreSQL 未运行但主机与存储指标正常,优先判断能否在 RTO 内安全原地恢复。若系统日志或存储监控同时出现 I/O error、文件系统只读、块设备丢失等证据,应把问题提升为存储故障,而不是反复重启 PostgreSQL。
用故障范围决定恢复还是切换
当 PostgreSQL 进程异常退出,但主机、存储和网络都健康,而且重启能够在目标 RTO 内完成,原地恢复通常比故障切换更简单,也不会引入时间线切换和旧主回归处理。
当主机硬件、操作系统或存储发生不可快速恢复的故障,或者原地恢复时间已经明显超过 RTO,才应进入备库提升流程。网络分区最危险:如果只是应用到主库的路径断开,而主库本身仍可服务其他客户端,提升备库会直接制造两个可写节点。
故障判断可以落成三种结论:继续原地恢复、先隔离再切换、证据不足继续取证。不要设计“检查失败即自动 promote”的单步规则。
切换前最后确认旧主库失去写入资格
真正触发切换前,必须获得 fencing 证据,例如关闭旧主虚拟机、撤销旧主存储访问、通过集群管理器执行 STONITH、隔离旧主业务网络,或使用同等强度且可验证的机制。单纯停止应用流量不足以证明数据库不能继续被写入。
完成隔离后,再结合候选备库的复制位置和业务 RPO 判断可接受的数据风险,并进入正式提升流程。如果旧主状态始终未知,又没有可靠 fencing 能力,正确动作是升级事故等级并继续隔离,而不是用“提高可用性”为理由冒险制造双主。