
PostgreSQL / 系统课时
验证故障切换结果
验证故障切换结果
故障切换并不以“新主已经提升”为结束。真正完成切换,还要确认新主能够稳定写入、关键数据符合预期、时间线已经推进,并检查剩余备库是否仍在复制正确的新主,避免带着隐藏风险继续运行。
学习目标
- 验证新主的角色、写入能力和关键数据
- 检查时间线与 WAL 状态,确认提升确实生效
- 判断剩余备库是否已经跟随新主,并识别需要立即处理的风险
先确认新主确实可写
首先连接切换后的目标实例,不要只依赖代理、VIP 或编排系统显示的角色。数据库自身必须报告它已经脱离恢复状态,并且真实写事务能够提交。
SELECT pg_is_in_recovery() AS in_recovery,
       pg_current_wal_lsn() AS current_wal_lsn;

CREATE TABLE IF NOT EXISTS failover_verify (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    checked_at timestamptz NOT NULL DEFAULT clock_timestamp(),
    note text NOT NULL
);

INSERT INTO failover_verify(note)
VALUES ('post-failover-write-check')
RETURNING id, note;预期结果:in_recovery 必须为 f,并且插入能够成功返回一行。LSN 会随实际环境变化。
 in_recovery | current_wal_lsn
-------------+-----------------
 f           | <VALUE>

 id   | note
------+---------------------------
 <ID> | post-failover-write-check
如果 pg_is_in_recovery() 仍为 t,说明当前连接的并不是已提升的新主;如果角色已是主库但写事务失败,则应先处理权限、只读事务、磁盘空间或底层存储等问题,而不是继续宣布切换成功。
核对关键业务数据
新主可写只能证明数据库角色正确,不能证明故障发生前的所有业务提交都已保留。应选择能够代表切换点的关键记录,例如最后一笔订单、最后一个业务流水号或故障前记录的校验值进行核对。
下面使用示例表演示检查方法,实际执行时应替换为业务自己的关键表和唯一键。
SELECT id, status, updated_at
FROM orders
WHERE id = <ID>;
预期结果:目标业务记录存在,字段值与切换前已确认的最后状态一致。具体值取决于实际业务数据。
 id   | status  | updated_at
------+---------+------------------------
 <ID> | <VALUE> | <TIME>
如果采用异步流复制,主库故障时尚未传到备库的 WAL 可能丢失,因此这里不能把“新主启动正常”等同于“零数据丢失”。应把实际保留的数据边界与业务侧最后确认提交点进行比较。
检查新时间线
备库执行提升后会进入新的时间线。时间线变化用于区分提升前后的 WAL 历史,也是后续判断其他备库能否继续跟随的重要依据。
pg_controldata <PATH> | grep -E 'TimeLineID|timeline'预期输出会显示当前控制文件记录的时间线信息;字段文字可能因 PostgreSQL 版本而略有差异,时间线编号以实际环境为准。
Latest checkpoint's TimeLineID:       <ID>
Latest checkpoint's PrevTimeLineID:   <ID>
也可以结合 PostgreSQL 日志确认提升事件及后续 checkpoint。不要把某个固定时间线编号写进运行手册,因为每经历一次新的历史分支,编号都可能继续增加。
检查剩余备库是否跟上新主
故障发生前如果还有其他备库,它们是否自动改为跟随新主取决于复制拓扑和自动化机制。应在新主查看当前流复制连接,再到各备库确认上游连接和接收状态。
SELECT application_name,
       client_addr,
       state,
       sync_state,
       sent_lsn,
       write_lsn,
       flush_lsn,
       replay_lsn
FROM pg_stat_replication;预期结果:计划继续保留的备库应出现在结果中,state 通常为 streaming。异步环境下几个 LSN 可以短暂不同,但应持续推进。
 application_name | client_addr | state     | sync_state | sent_lsn | write_lsn | flush_lsn | replay_lsn
------------------+-------------+-----------+------------+----------+-----------+-----------+-----------
 <VALUE>           | <IP>        | streaming | async      | <VALUE>  | <VALUE>   | <VALUE>   | <VALUE>
在备库侧还应确认 WAL receiver 正在连接预期的新主。
SELECT status,
       sender_host,
       sender_port,
       written_lsn,
       flushed_lsn,
       latest_end_lsn
FROM pg_stat_wal_receiver;
预期结果:正常复制时 status 为 streaming,sender_host 应指向新主地址。
 status    | sender_host | sender_port | written_lsn | flushed_lsn | latest_end_lsn
-----------+-------------+-------------+-------------+-------------+---------------
 streaming | <IP>        | <PORT>      | <VALUE>     | <VALUE>     | <VALUE>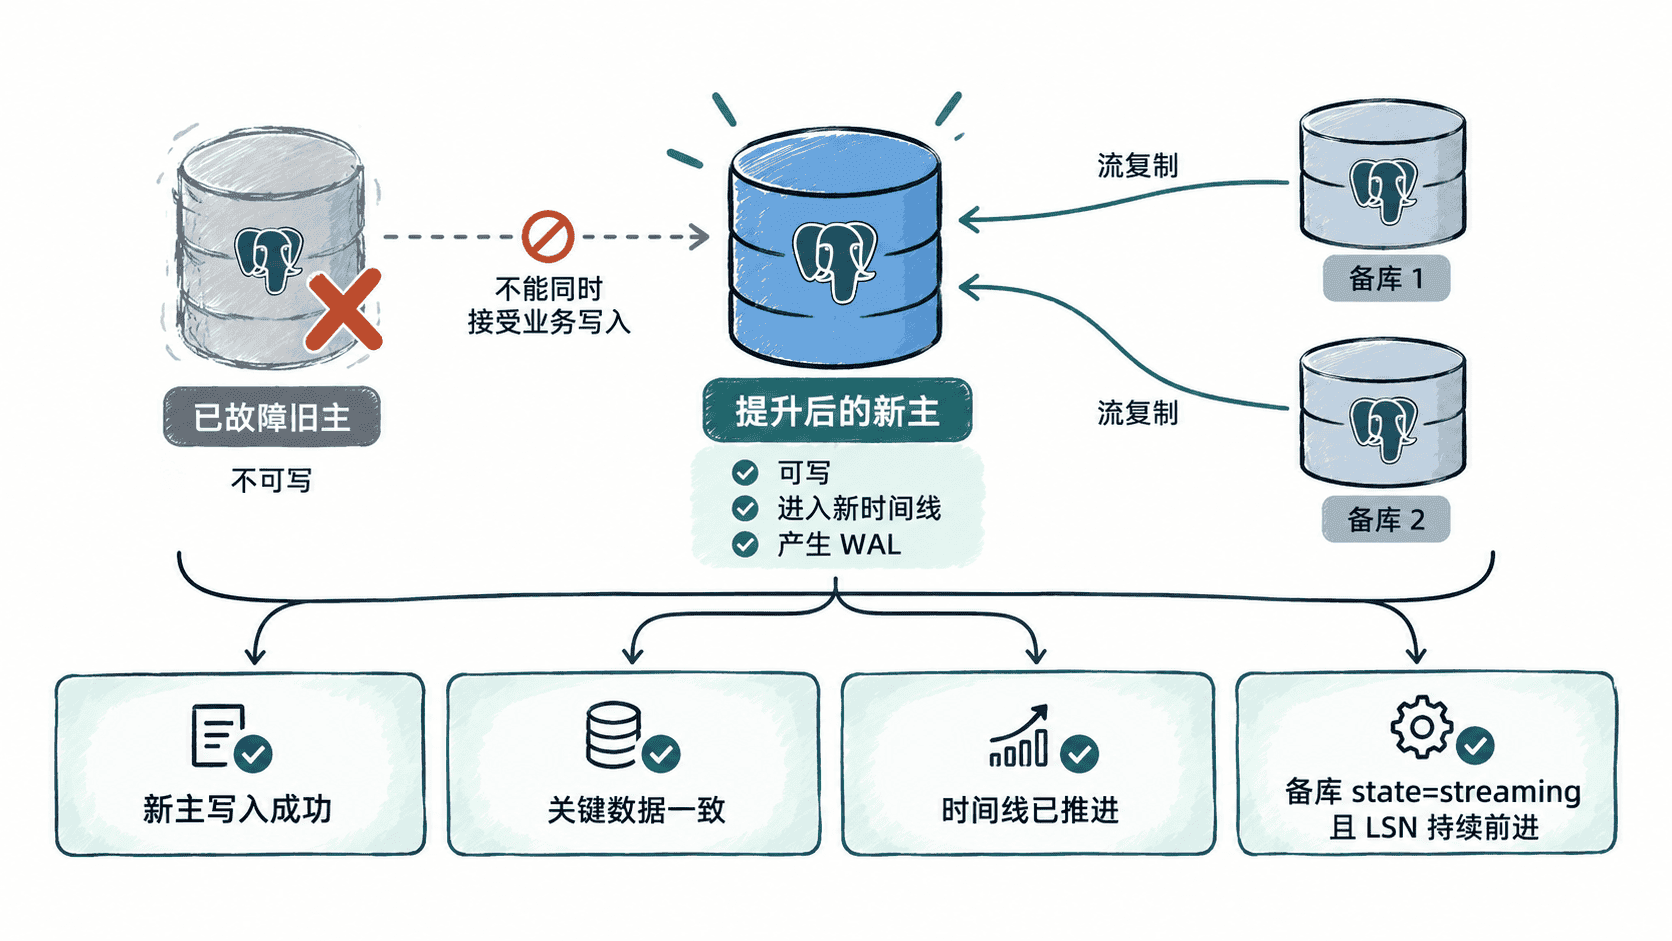
处理切换后的高风险状态
以下情况出现任意一项,都不应把故障切换标记为完全结束:新主仍不能稳定写入;关键业务记录缺失且丢失范围尚未确定;应保留的备库没有连接新主;复制 LSN 长时间不推进;客户端仍可能访问旧主;监控、备份或归档任务仍指向旧拓扑。
尤其要防止旧主在网络恢复后重新以主库身份接受写入。完成业务验收后,应继续保持旧主隔离或写入围栏,直到明确其后续处理方式。故障切换的完成标准不是单个 promote 动作成功,而是新主、数据、时间线、复制拓扑和客户端写入路径同时达到一致状态。