
PostgreSQL / 系统课时
使用 Hot Standby 承担读流量
使用 Hot Standby 承担读流量
Hot Standby 允许 PostgreSQL 备库在持续回放 WAL 的同时接受只读查询。本课通过检查恢复状态和读写行为,明确哪些查询适合交给备库,以及为什么恢复中的实例不能像主库一样承担普通写事务。
学习目标
- 验证备库处于恢复模式并能够执行只读查询
- 区分适合迁移到备库的读业务与必须留在主库的操作
- 理解 Hot Standby 的只读限制与 WAL 回放之间的关系
先确认备库确实处于恢复模式
Hot Standby 不是把备库变成第二个可写主库,而是在恢复进程持续应用 WAL 的前提下开放查询能力。连接到计划承担读流量的备库后,可以同时检查恢复状态和事务只读属性。
SELECT pg_is_in_recovery() AS in_recovery,
       current_setting('transaction_read_only') AS transaction_read_only;
预期结果
 in_recovery | transaction_read_only
-------------+-----------------------
 t           | on
(1 row)
pg_is_in_recovery() 返回 t 表示实例仍在恢复中;transaction_read_only=on 表示当前事务不能执行普通数据写入。不同客户端的表格边框可能略有差异,但两个值应分别为 t 和 on。
随后执行一条真实查询,确认备库能够读取已经从主库复制并回放的数据。以下示例假设业务库中已有 orders 表。
SELECT id, status
FROM orders
ORDER BY id DESC
LIMIT 3;
预期结果
 id   | status
------+---------
 <ID> | paid
 <ID> | pending
 <ID> | shipped
(3 rows)
实际 <ID> 与业务数据有关。只要查询能够正常返回已经在备库完成 WAL 回放的数据,就说明 Hot Standby 的读路径可用。
只读能力与复制链路如何配合
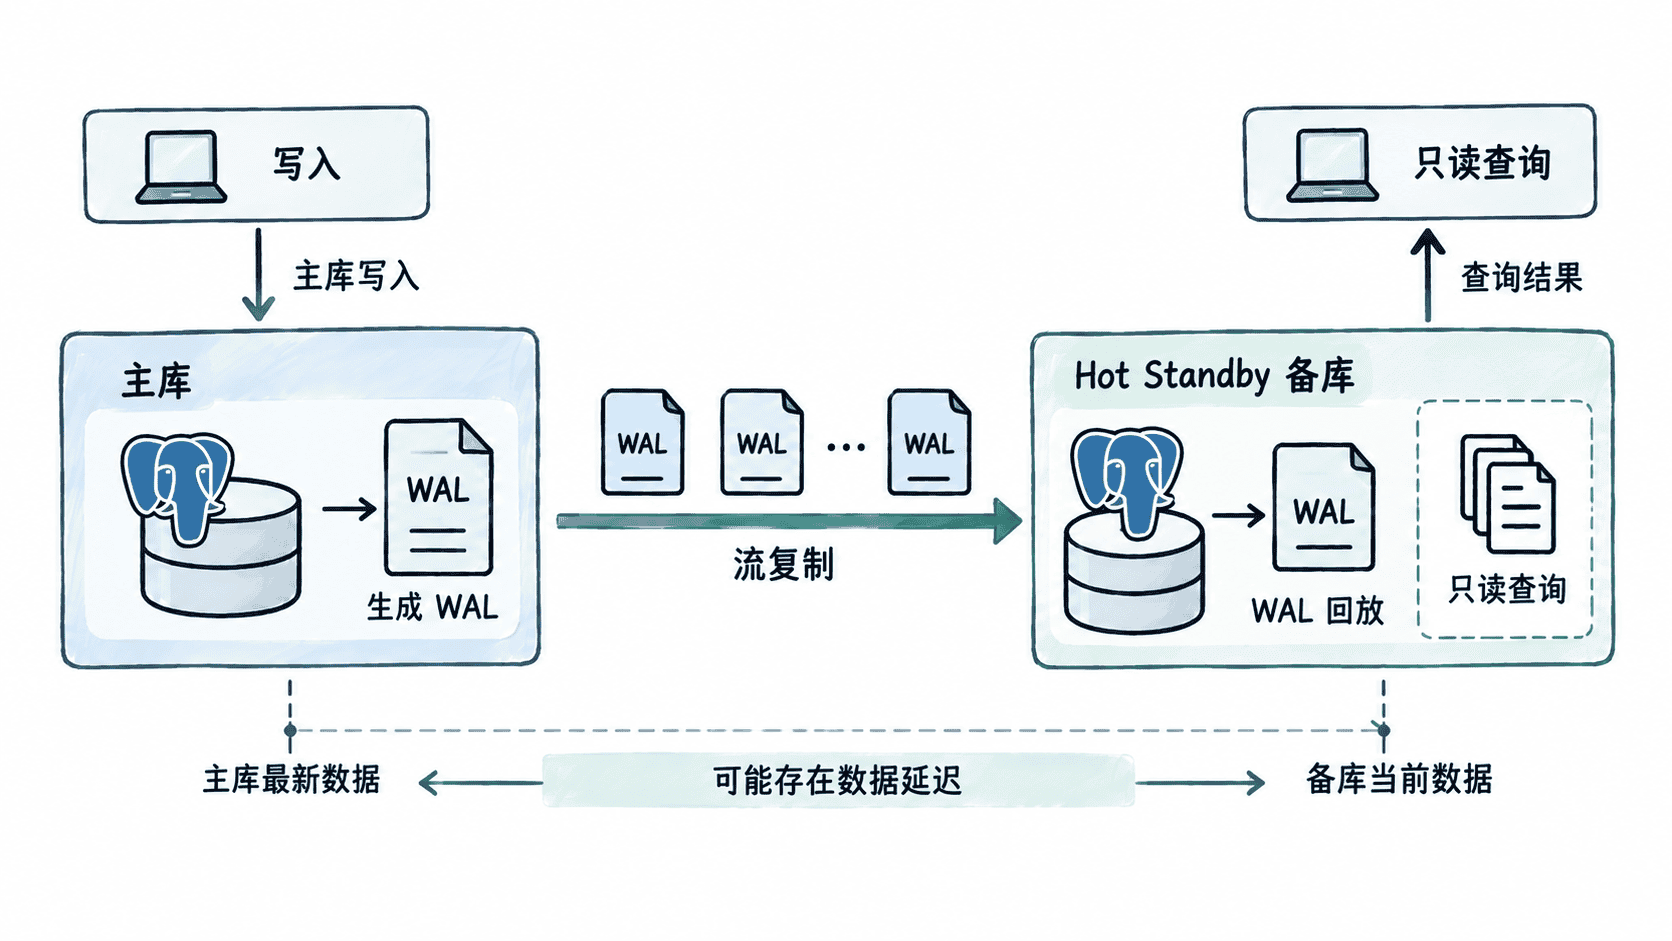
主库负责接受写事务并生成 WAL,备库接收 WAL 后按顺序恢复这些变更。查询看到的是已经回放到当前恢复位置的数据,因此备库天然可能比主库稍旧。读写分离时,应用不能假设“刚在主库写完,下一次从备库读取就一定立即可见”。
Hot Standby 更适合报表、统计、搜索辅助查询以及允许少量复制延迟的读取。需要严格读己之写、参与写事务或依赖最新提交结果的请求,通常仍应访问主库。
验证写事务会被拒绝
可以使用一个测试事务直接验证只读限制。下面尝试创建测试表;在恢复中的 Hot Standby 上,这类写操作会失败,因此不会留下实际对象。
BEGIN;
CREATE TABLE hot_standby_write_test(id integer);
ROLLBACK;
预期结果
BEGIN
ERROR:  cannot execute CREATE TABLE in a read-only transaction
ROLLBACK
具体错误文字可能因 PostgreSQL 版本和操作类型略有差异,但核心结果是写操作不会成功。普通 INSERT、UPDATE、DELETE 和 DDL 都不能把恢复中的备库当作可写实例使用。
判断哪些读请求适合下沉
选择备库读流量时,应同时看一致性要求和查询成本。允许复制延迟的 BI 报表、后台统计和大范围只读分析通常是较好的候选;下单后立即查询订单状态、余额扣减后的即时读取等强一致链路,则不适合直接随机落到备库。
还要注意,Hot Standby 查询并不是完全没有代价。长时间运行的查询可能与 WAL 回放需要执行的清理或锁操作发生恢复冲突,PostgreSQL 可能延迟回放或取消冲突查询,具体行为受相关恢复冲突参数影响。因此把分析查询迁到备库可以隔离部分 CPU 与 I/O 压力,却不能把备库视为无限制的查询仓库。
实际接入读流量前,应至少确认三个条件:备库持续处于正常流复制状态、业务能容忍当前复制延迟、查询运行时间不会长期干扰恢复。满足这些条件后,Hot Standby 才真正承担的是可控的读扩展,而不是把主库压力转化成新的复制风险。