
PostgreSQL / 系统课时
排查复制延迟持续增长
排查复制延迟持续增长
复制延迟持续增长时,关键不是重新解释各个 LSN,而是用连续采样确定积压正在从哪一段扩大,再把这一变化与同一时间窗口的主库负载、网络、备库存储和回放证据对应起来,修复后继续观察趋势是否真正收敛。
学习目标
- 用连续 LSN 采样锁定持续增长的积压阶段
- 根据增长点选择对应的资源指标和排查方向
- 修复后通过趋势变化判断复制是否真正恢复
先用连续采样锁定增长点
前面已经介绍过 sent_lsn、write_lsn、flush_lsn 和 replay_lsn 的关系,这里不再重复定义。故障现场应关注相邻采样之间哪一类 gap 持续扩大,而不是某一次查询中的绝对数值。
SELECT application_name,
       state,
       sent_lsn,
       write_lsn,
       flush_lsn,
       replay_lsn,
       pg_wal_lsn_diff(pg_current_wal_lsn(), sent_lsn) AS generation_gap_bytes,
       pg_wal_lsn_diff(sent_lsn, write_lsn) AS network_gap_bytes,
       pg_wal_lsn_diff(write_lsn, flush_lsn) AS flush_gap_bytes,
       pg_wal_lsn_diff(flush_lsn, replay_lsn) AS replay_gap_bytes
FROM pg_stat_replication;
预期结果:每个已连接备库返回一行。实际 LSN 和字节数会随负载变化,应按固定间隔连续采样并比较各 gap 的趋势。
 application_name | state     | sent_lsn | write_lsn | flush_lsn | replay_lsn | generation_gap_bytes | network_gap_bytes | flush_gap_bytes | replay_gap_bytes
------------------+-----------+----------+-----------+-----------+------------+----------------------+-------------------+-----------------+-----------------
 <VALUE>          | streaming | <LSN>    | <LSN>     | <LSN>     | <LSN>      | <VALUE>              | <VALUE>           | <VALUE>         | <VALUE>
(1 row)
建议每隔 10~30 秒采样一次,并同步查看该时间窗口的 WAL 产生量和业务写入强度。单次高 gap 可能只是瞬时突发;只有同一段连续扩大,才说明该阶段的处理能力长期低于上游输入速度。
从增长点转向根因证据
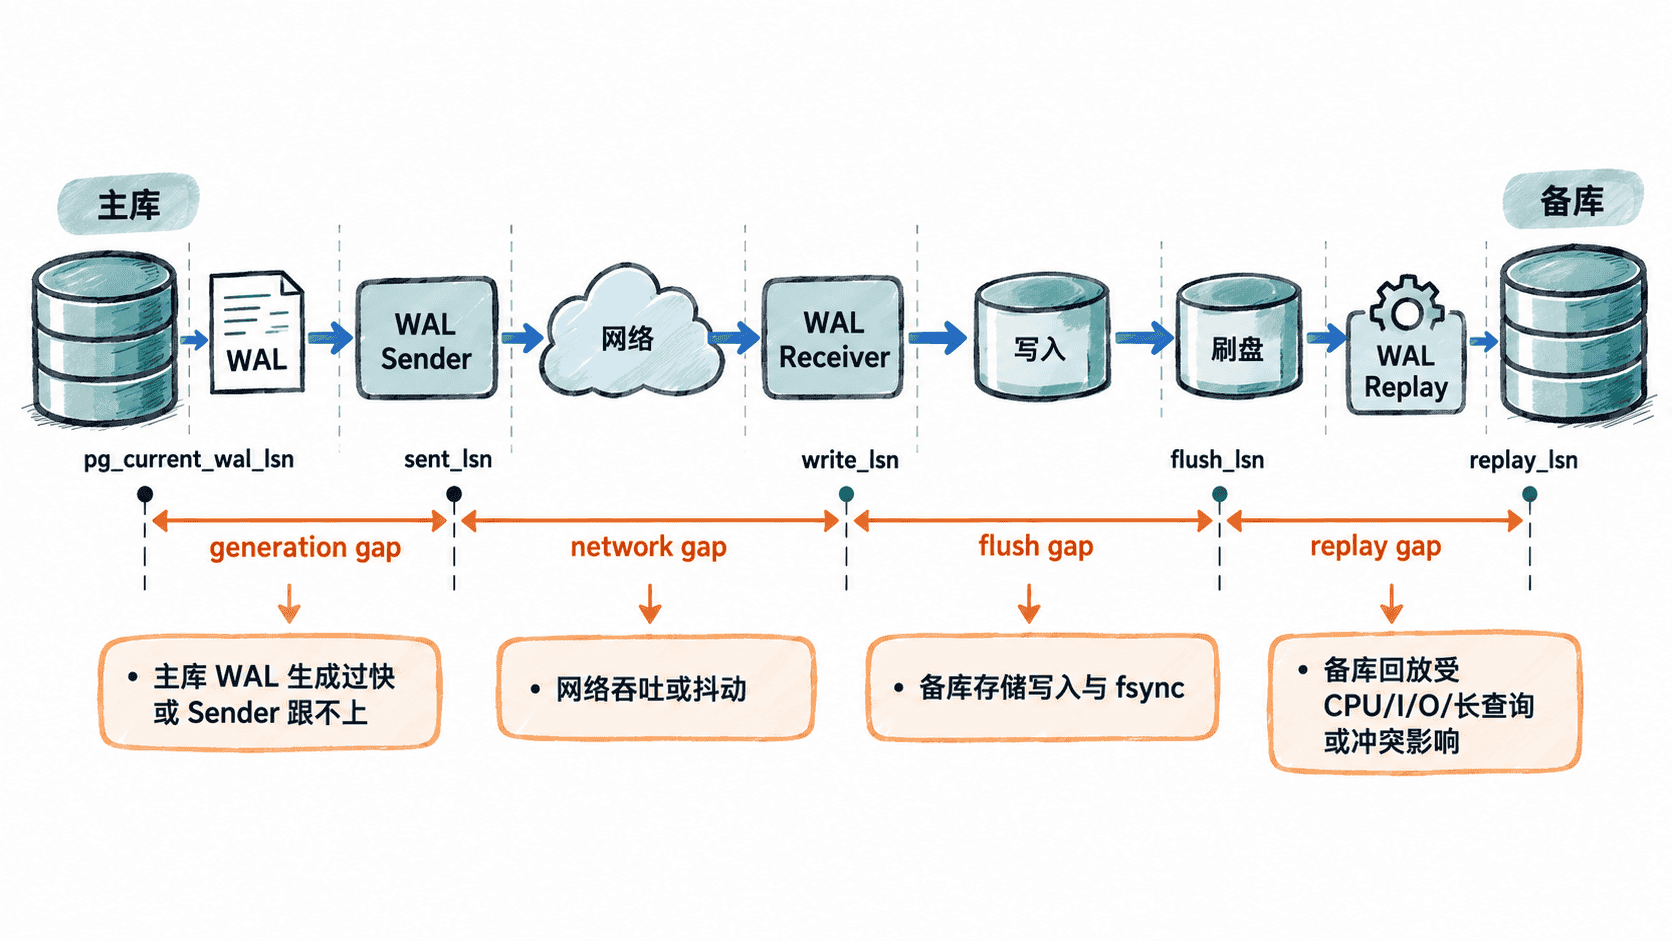
确定增长点后再采集对应证据,避免把所有资源指标同时翻一遍。这里的 gap 是定位信号,不应机械等同于某一种资源故障,例如 network_gap_bytes 同时可能受到链路传输、备库接收处理以及状态反馈间隔影响。
| 持续扩大的 gap | 优先核对的证据 | 处置重点 |
|---|---|---|
generation_gap_bytes |
WAL 产生速率、WAL Sender CPU、主库负载、发送端网络背压 | 控制异常写入突发,解除 WAL Sender 的资源竞争 |
network_gap_bytes |
带宽、丢包、重传、链路时延、备库接收状态 | 修复网络或接收端瓶颈,不先调整回放参数 |
flush_gap_bytes |
备库存储写延迟、I/O 队列、吞吐与设备饱和度 | 恢复备库 WAL 持久化能力 |
replay_gap_bytes |
备库 CPU、数据盘 I/O、恢复冲突和读取负载 | 解除回放端资源竞争或冲突 |
如果上游 gap 已经稳定,而下游 gap 仍扩大,说明瓶颈可能已经向后移动。排障过程中应始终以最新连续采样为准,而不是沿用最初的判断。
只在可疑备库补采接收与回放证据
当 replay_gap_bytes 明显增长时,再到对应备库检查 WAL Receiver 和本地回放位置。把原先分开的接收状态与回放积压合并到一次查询中,可以直接判断“还在接收,但回放追不上”这一类故障。
SELECT status,
       written_lsn,
       flushed_lsn,
       latest_end_lsn,
       latest_end_time,
       pg_last_wal_receive_lsn() AS receive_lsn,
       pg_last_wal_replay_lsn() AS replay_lsn,
       pg_wal_lsn_diff(
           pg_last_wal_receive_lsn(),
           pg_last_wal_replay_lsn()
       ) AS replay_backlog_bytes
FROM pg_stat_wal_receiver;
预期结果:正常流式接收时通常返回一行且 status 为 streaming。若连续采样时 receive_lsn 持续前进,而 replay_backlog_bytes 继续扩大,说明接收链路没有停止,应把排查重点转向备库回放能力。
  status   | written_lsn | flushed_lsn | latest_end_lsn | latest_end_time | receive_lsn | replay_lsn | replay_backlog_bytes
-----------+-------------+-------------+----------------+-----------------+-------------+------------+---------------------
 streaming | <LSN>       | <LSN>       | <LSN>          | <TIME>          | <LSN>       | <LSN>      | <VALUE>
(1 row)
如果查询没有返回 WAL Receiver 行,应先确认流复制连接是否仍然存在;如果接收位置本身也停止推进,则不能把问题直接归为回放性能不足。
处置时一次只解决主要瓶颈
发送端积压时,先确认是否发生批量更新、索引维护或异常写入峰值,再检查 WAL Sender 是否受到 CPU 或发送带宽限制。发送到写入之间扩大时,优先处理链路丢包、重传、限速或接收端处理异常。
写入到刷盘之间扩大时,应优先解决备库存储延迟和 I/O 饱和。刷盘已经追上而回放继续落后时,再检查备库 CPU、数据盘 I/O、恢复冲突和长期读取负载;此时继续调整网络参数通常不会改善回放速度。
修复后用趋势完成验收
修复后重新执行最开始的主库采样 SQL,不需要换一套指标。验收首先看目标 gap 是否在连续多个采样周期内停止增长;当新增 WAL 速度低于复制处理能力时,还应看到积压逐步下降。
仅看到 state = 'streaming' 不能证明故障已经消失。如果原来的 network_gap_bytes 已收缩,但 replay_gap_bytes 开始扩大,说明复制连接仍在线,却只是把瓶颈推到了下游,需要继续沿新的增长点排查。
持续复制延迟的有效诊断路径应保持简洁:连续采样锁定增长点,针对该阶段补采资源证据,只修复主要瓶颈,再用同一组 LSN 指标验证积压从增长转为稳定并最终收敛。