
PostgreSQL / 系统课时
监控复制槽与 WAL 保留
监控复制槽与 WAL 保留
前文已经能用槽状态判断复制是否停滞,本课不再重复解释 active、restart_lsn 等字段,而是把复制槽当作容量风险源,重点回答:还能保留多少 WAL、风险增长多快,以及何时必须介入。
学习目标
- 用
wal_status、safe_wal_size和max_slot_wal_keep_size判断槽的剩余安全预算 - 将槽风险、
pg_wal占用与文件系统余量放到同一时间序列 - 用增长速率和剩余处置窗口设计分级告警
把槽状态转换成容量预算
单看某个槽是否活跃,只能说明消费者当前有没有连接;真正影响值班决策的是“这个消费者继续停滞,还能撑多久”。监控应把槽侧预算、WAL 目录占用和底层文件系统余量同时采样,而不是再次围绕单个 LSN 做静态判断。
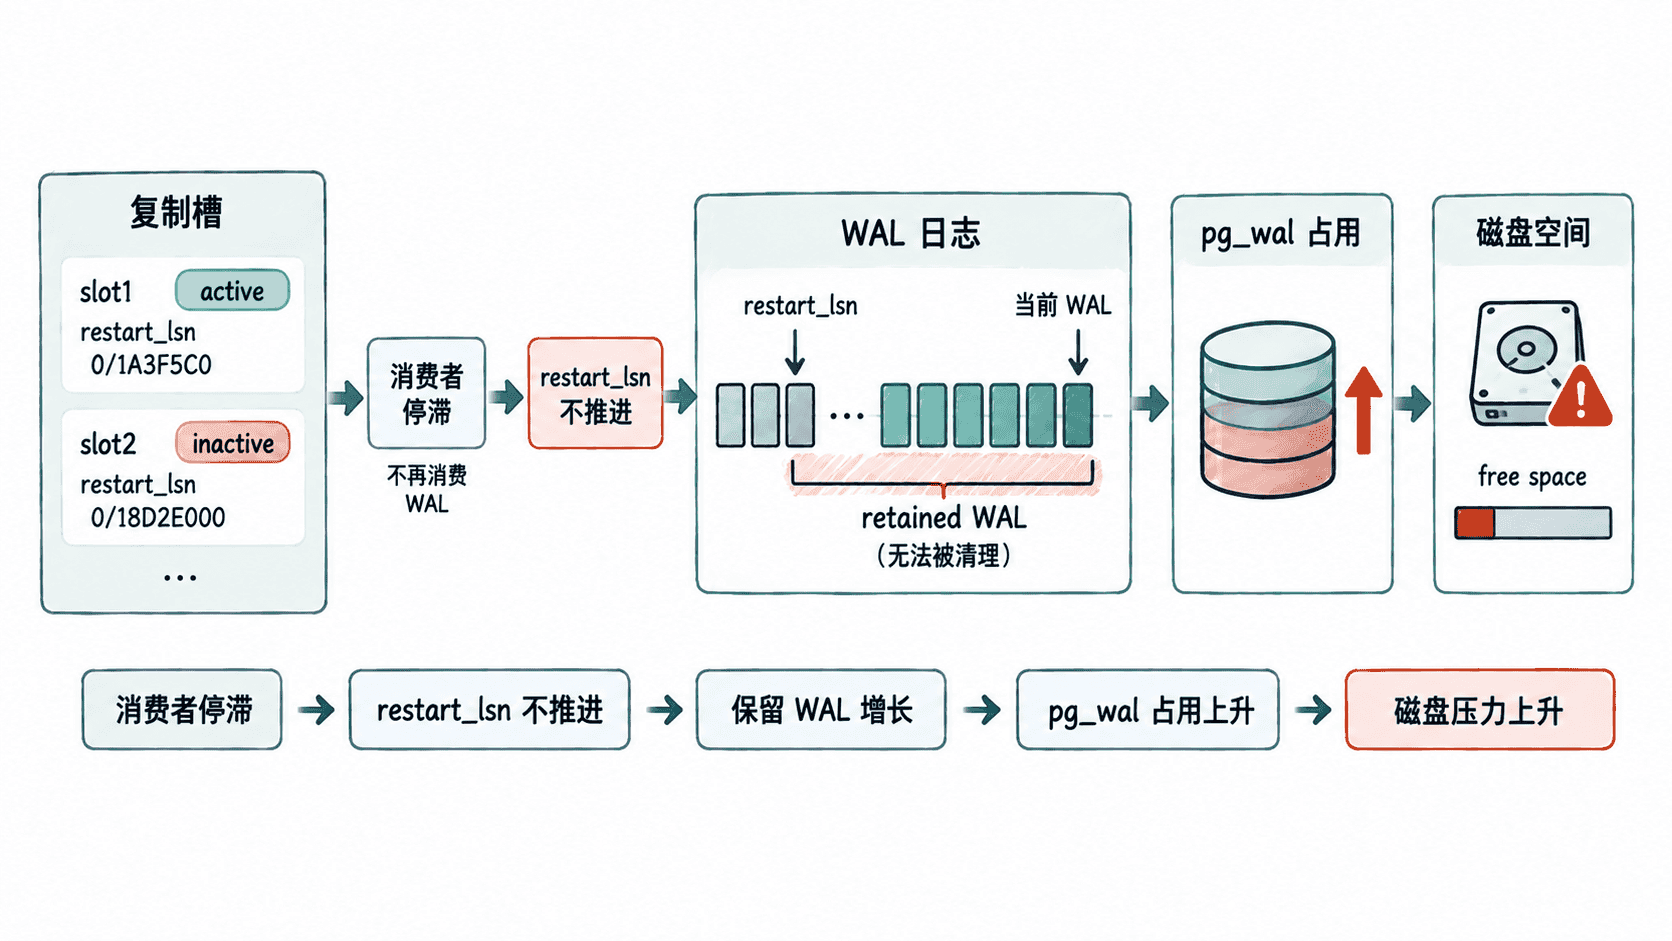
一次采样得到风险快照
在支持 wal_status 与 safe_wal_size 的 PostgreSQL 版本中,可以把槽的可用性、剩余安全预算、当前 WAL 保留量和 pg_wal 占用放进一次采样。safe_wal_size 不是磁盘剩余空间,而是在当前槽限制下还能继续写入多少 WAL、才会逼近 lost 风险。
WITH wal_dir AS (
    SELECT COALESCE(SUM(size), 0)::bigint AS pg_wal_bytes
    FROM pg_ls_waldir()
)
SELECT
    s.slot_name,
    s.active,
    s.wal_status,
    pg_size_pretty(
        pg_wal_lsn_diff(pg_current_wal_lsn(), s.restart_lsn)
    ) AS retained_wal,
    CASE
        WHEN s.safe_wal_size IS NULL THEN NULL
        ELSE pg_size_pretty(s.safe_wal_size)
    END AS safe_wal_remaining,
    pg_size_pretty(w.pg_wal_bytes) AS pg_wal_size,
    current_setting('max_slot_wal_keep_size') AS max_slot_wal_keep_size
FROM pg_replication_slots AS s
CROSS JOIN wal_dir AS w
WHERE s.restart_lsn IS NOT NULL
ORDER BY s.safe_wal_size NULLS LAST;
预期结果
 slot_name | active | wal_status | retained_wal | safe_wal_remaining | pg_wal_size | max_slot_wal_keep_size
-----------+--------+------------+--------------+--------------------+-------------+------------------------
 <ID>      | <VALUE>| <VALUE>    | <VALUE>      | <VALUE>            | <VALUE>     | <VALUE>
<ID> 和 <VALUE> 会随环境变化。wal_status 应重点识别 unreserved 与 lost;safe_wal_size 为 NULL 时也不能直接判定异常,因为当 max_slot_wal_keep_size = -1 时,该值本来就没有有限预算可计算。监控账号还需要具备读取相关系统视图和函数的权限。
用增长速率估算处置窗口
快照只告诉你“现在多危险”,时间序列才告诉你“还有多久”。建议以固定周期采样,在最近 15~30 分钟窗口计算 retained WAL、pg_wal_size 和文件系统已用空间的净增长速率,再用文件系统可用字节除以持续增长速率估算剩余处置时间。
这里要避免两个常见误判:pg_wal_size 不等于“被某个槽独占保留的 WAL”,因为目录内还包含数据库正常需要的 WAL;文件系统剩余空间也不能只从 PostgreSQL 内部推断,应由主机或容器监控采集,并确认 pg_wal 实际所在挂载点。
把限制值理解为保护阀
max_slot_wal_keep_size = -1 表示复制槽可以不受该参数限制地保留 WAL,这提高了消费者长期离线后的连续性,却把最终风险转移给磁盘容量。设置有限值后,系统会在检查点相关处理过程中限制槽可保留的 WAL;落后过多的槽可能进入 unreserved,最终变成不可继续使用的 lost。
因此,这个参数不是“可以放心用满的配额”。告警必须早于失效边界触发,并为网络恢复、消费者追平或重新初始化预留时间。
按原因、压力和后果分级告警
可以把告警拆成三层:消费者长时间无进展属于原因信号;safe_wal_size 持续下降或 retained WAL 高速增长属于压力信号;wal_status 进入 unreserved、lost,或文件系统余量逼近安全下限,则属于后果信号。分级时同时要求持续时间和趋势,避免短暂重连或一次 WAL 峰值直接触发高等级人工处置。
真正有用的监控不是再次罗列槽字段,而是把它们换算成处置窗口:哪个消费者在消耗预算、预算下降有多快、磁盘还能支撑多久,以及先恢复消费者还是先保护主库容量。