
PostgreSQL / 系统课时
建立故障切换前健康门禁
建立故障切换前健康门禁
故障切换不是“备库能连上就可以提升”。切换前要同时验证可达性、恢复状态、WAL 接收与回放差距、时间线、磁盘余量和旧主写入隔离,并把不同复制差距对应到不同风险,任何关键证据无法解释都应阻断提升。
学习目标
- 用 SQL 和系统命令检查候选备库是否具备提升条件
- 区分主库到接收点的差距与接收点到回放点的积压,正确评估数据风险
- 把时间线、磁盘、可达性和旧主写入隔离纳入可执行的切换门禁
先定义“可以切换”的最低条件
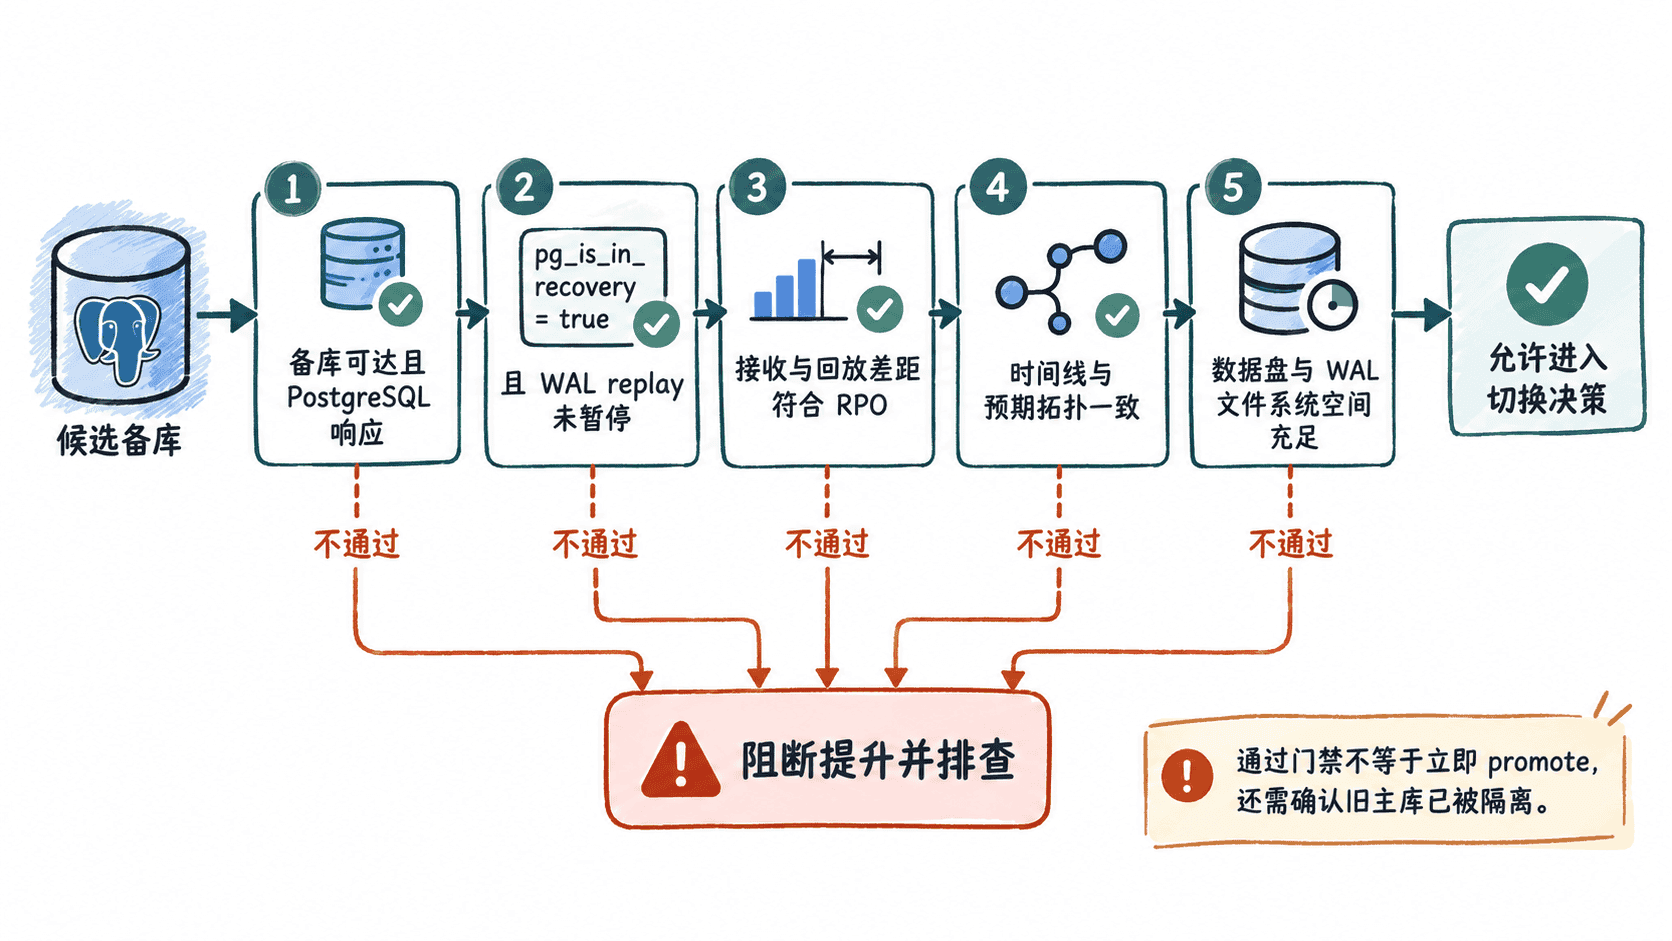
候选备库至少应满足五类条件:节点可连接且 PostgreSQL 正常响应;仍处于恢复状态且 WAL 回放没有暂停;复制进度满足业务允许的数据损失边界;时间线与预期拓扑一致;数据盘和 WAL 所在文件系统没有逼近容量风险。
复制进度必须拆成两段判断。第一段是主库当前持久化 WAL 到候选备库接收点的差距,它反映还有多少 WAL 尚未可靠到达候选节点;只有主库仍可访问,或主库侧仍保留候选备库的复制状态时,才能直接补充这部分证据。第二段是候选备库已接收位置到已回放位置的差距,它反映 WAL 已经到达但尚未应用到数据库状态的积压。
因此,receive_lsn - replay_lsn 不能代表候选备库相对主库的完整落后量。主库已经永久失联时,只能把候选备库已知的接收点和回放点当作当前恢复边界,不能据此证明丢失 WAL 的精确数量,更不能声称已经满足零数据丢失。
在候选备库读取恢复与回放状态
先登录候选备库读取恢复状态。pg_last_wal_receive_lsn() 表示流复制最近接收并同步到磁盘的 WAL 位置,pg_last_wal_replay_lsn() 表示已经回放的位置;二者差值只描述候选备库内部的接收到回放积压。
SELECT
    pg_is_in_recovery() AS in_recovery,
    pg_is_wal_replay_paused() AS replay_paused,
    pg_last_wal_receive_lsn() AS receive_lsn,
    pg_last_wal_replay_lsn() AS replay_lsn,
    pg_size_pretty(
        pg_wal_lsn_diff(
            pg_last_wal_receive_lsn(),
            pg_last_wal_replay_lsn()
        )
    ) AS receive_to_replay_gap,
    clock_timestamp() - pg_last_xact_replay_timestamp() AS replay_age,
    (SELECT timeline_id FROM pg_control_checkpoint()) AS checkpoint_tli;
预期结果
 in_recovery | replay_paused | receive_lsn | replay_lsn | receive_to_replay_gap | replay_age      | checkpoint_tli
-------------+---------------+-------------+------------+-----------------------+-----------------+---------------
 t           | f             | <LSN>       | <LSN>      | <VALUE>               | <TIME_INTERVAL> | <ID>
实际 LSN、间隔和时间线编号会随环境变化。首先确认 in_recovery=t 和 replay_paused=f,再检查 receive_to_replay_gap 是否在切换窗口允许的范围内。该差值很小只说明已收到的 WAL 基本回放完成,并不证明主库产生的 WAL 已全部到达候选备库。
replay_age 是距离最近一次事务回放时间的间隔。低写入或空闲系统中它可能持续增大,因此只能作为辅助信号,不能单独作为复制延迟或故障证据。
分别核对上游差距与接收链路
正在通过流复制接收 WAL 的备库,pg_stat_wal_receiver 通常应有一行。received_tli、latest_end_lsn 和 latest_end_time 可以确认最近接收的时间线和上游进度。
SELECT
    status,
    sender_host,
    received_tli,
    written_lsn,
    flushed_lsn,
    latest_end_lsn,
    latest_end_time
FROM pg_stat_wal_receiver;
预期结果
 status    | sender_host | received_tli | written_lsn | flushed_lsn | latest_end_lsn | latest_end_time
-----------+-------------+--------------+-------------+-------------+----------------+----------------
 streaming | <HOST>      | <ID>         | <LSN>       | <LSN>       | <LSN>          | <TIME>
查询返回 0 行只说明当前没有 WAL receiver 进程;计划内断链、归档恢复和真实复制故障都可能产生这种结果。切换前必须解释最后一段 WAL 来自哪里,并确认候选节点没有跟随错误的上游或未知时间线。
如果旧主仍可访问,还应从主库侧独立检查主库到候选备库的差距。pg_stat_replication.flush_lsn 是备库最近报告给主库的持久化位置,可与主库当前持久化 WAL 位置比较。应通过 application_name、client_addr 等字段确认正在观察的确实是本次候选节点。
SELECT
    application_name,
    client_addr,
    state,
    pg_current_wal_flush_lsn() AS primary_flush_lsn,
    flush_lsn AS standby_flush_lsn,
    replay_lsn AS standby_replay_lsn,
    pg_size_pretty(
        pg_wal_lsn_diff(pg_current_wal_flush_lsn(), flush_lsn)
    ) AS primary_to_standby_flush_gap
FROM pg_stat_replication
ORDER BY application_name;
预期结果
 application_name | client_addr | state     | primary_flush_lsn | standby_flush_lsn | standby_replay_lsn | primary_to_standby_flush_gap
------------------+-------------+-----------+-------------------+-------------------+--------------------+------------------------------
 <NAME>           | <IP>        | streaming | <LSN>             | <LSN>             | <LSN>              | <VALUE>
这里的 primary_to_standby_flush_gap 与备库侧的 receive_to_replay_gap 是两个不同门禁:前者关注 WAL 是否已经从主库可靠传到候选节点,后者关注候选节点是否已经把收到的 WAL 回放完成。采样期间主库仍可能继续产生 WAL,因此数值应视为某一时刻的近似证据,而不是永久不变的边界。
如果主库已经永久失联,主库侧查询自然无法执行。此时不能用候选备库自身很小的 receive_to_replay_gap 推导“只会丢这些数据”;只能记录候选节点最后已接收和已回放的 LSN,并结合故障前监控、同步复制策略或其他可靠证据判断可能的数据损失范围。
检查可达性与磁盘余量
数据库状态正常仍不代表节点具备持续接管能力。用 pg_isready 检查服务响应,再分别检查数据目录和 WAL 所在文件系统。若 pg_wal 位于独立文件系统,应确认实际挂载点也有足够余量。
export STANDBY_HOST="db-standby.example.com"
export STANDBY_PORT="5432"
export PGDATA="/var/lib/postgresql/18/main"

pg_isready -h "$STANDBY_HOST" -p "$STANDBY_PORT" -t 3
ssh "$STANDBY_HOST" "df -h '$PGDATA' '$PGDATA/pg_wal'"
预期输出
db-standby.example.com:5432 - accepting connections
Filesystem      Size   Used   Avail  Use%  Mounted on
<DEVICE>        <SIZE> <SIZE> <SIZE> <VALUE>% <PATH>
<DEVICE>        <SIZE> <SIZE> <SIZE> <VALUE>% <PATH>
实际设备名、容量和挂载点会不同。如果数据目录和 pg_wal 位于同一文件系统,出现相同挂载点是正常的。容量门禁不应只依赖固定百分比,而应覆盖切换期间可能产生的 WAL、检查点和业务增长,并预留足够的处置时间。
把检查结果变成真正的切换门禁
值班手册不要只写“检查复制正常”,而要为每项定义证据、阈值和失败动作。可达性失败要先区分数据库不可用还是网络路径故障;回放暂停必须恢复或明确解释;主库到候选接收点的差距超过 RPO 时应阻断或升级决策;接收点到回放点仍有明显积压时,应等待回放或确认提升后的恢复行为。时间线关系无法解释时不要提升,磁盘余量不足则先扩容或降低风险。
最后还要有一条独立于复制健康度的安全门禁:旧主库是否已经确认失去写入资格。候选备库即使所有数据库检查通过,也不等于可以立即提升。没有 fencing、STONITH、云平台隔离或等价的写入隔离证据时,切换仍应被阻断,因为此时最大的风险不是候选备库落后多少,而是旧主重新出现后形成双主。