
PostgreSQL / 系统课时
设计多备库与级联复制
设计多备库与级联复制
多备库并不只有“再加几台从库”这一种结构。主库直连多备库能缩短传播路径,级联复制则可以把跨地域流量和 WAL 发送压力转移到中继备库。本课从传播路径、故障域和恢复能力出发,完成可落地的拓扑选择。
学习目标
- 区分主库直连多备库与级联复制的 WAL 传播路径和故障影响范围
- 配置一个最小级联复制链路,并验证下游备库确实从中继备库接收 WAL
- 根据跨机房带宽、故障域与同步提交需求选择合适拓扑
两类拓扑解决的是不同问题
主库直连多备库时,每台备库都直接连接主库,由主库为每条物理复制连接提供 WAL Sender。结构简单、传播层级少,适合备库数量有限、网络条件良好,并希望每台备库直接掌握主库 WAL 流的场景。
级联复制中,下游备库不再直接连接主库,而是连接另一台已经处于恢复状态的备库。中继备库既持续接收上游 WAL,也通过自己的 WAL Sender 将 WAL 继续发送给下游,从而减少主库的跨地域连接数和重复发送流量。
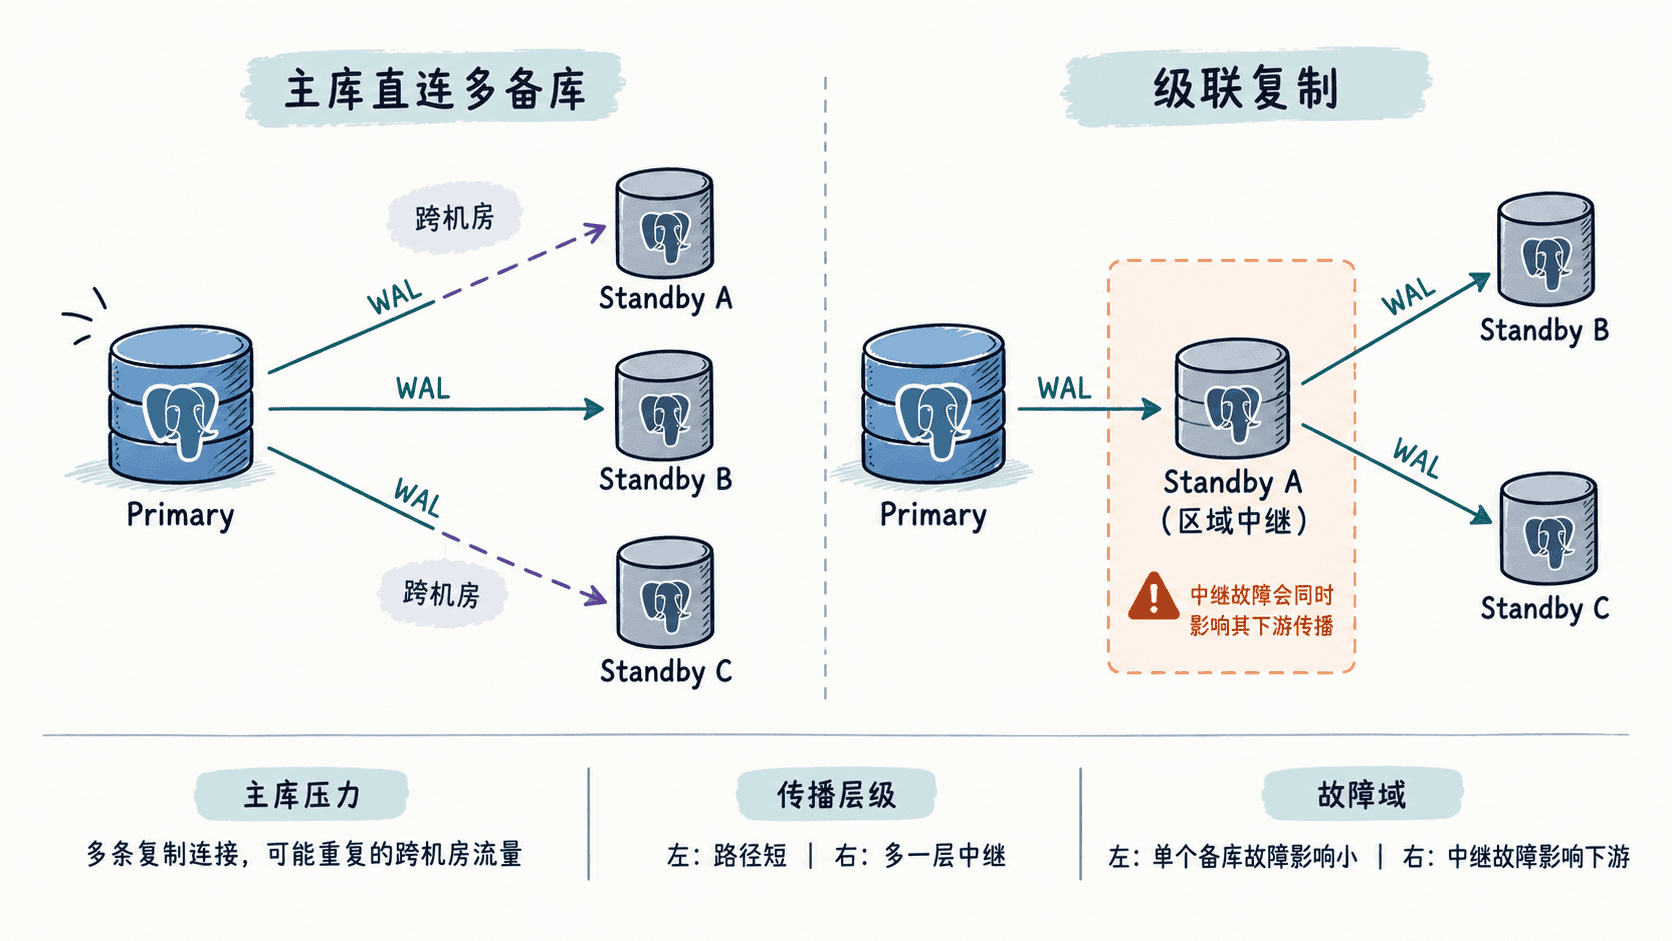
直连与级联并不是互斥选择。生产环境常见的是混合拓扑:主库直连两台位于不同故障域的核心备库,其中一台或多台核心备库再向本地只读节点、报表节点或灾备节点级联发送 WAL。
配置一个最小级联链路
假设已有 primary 和 standby1,现在增加 standby2,并让 standby2 从 standby1 接收 WAL。前提是 standby1 已开启足够的复制连接能力,并允许复制用户从 standby2 所在地址连接。
在 standby1 上确认它虽然处于恢复状态,但可以作为下游复制源。
SELECT pg_is_in_recovery();
SHOW max_wal_senders;
预期结果是 pg_is_in_recovery() 为 t,同时 max_wal_senders 大于 0。具体数值取决于实例配置。
 pg_is_in_recovery
-------------------
 t

 max_wal_senders
-----------------
 <VALUE>
还需要在 standby1 的 pg_hba.conf 中允许 standby2 使用复制账号连接。下面是片段示例,其中网段和用户名必须按实际环境替换。
host replication replicator <IP>/<MASK> scram-sha-256该配置文件修改后需要 reload,并应使用网络连通性和复制连接实际验证规则是否匹配。
SELECT pg_reload_conf();预期结果为 t。
 pg_reload_conf
----------------
 t
初始化 standby2 时,将 pg_basebackup 的连接目标指向 standby1,而不是主库。以下命令应在 standby2 主机上执行,目标目录必须为空,认证信息应通过 .pgpass 等安全方式提供。
pg_basebackup \
  -h <STANDBY1_IP> \
  -p <PORT> \
  -U replicator \
  -D <PATH> \
  -R \
  -X stream \
  -P
预期结果是基础备份完成,并在目标数据目录写入用于后续流复制的 standby 配置。传输字节数、时间和进度百分比会随数据量变化。
<BYTES>/<BYTES> kB (100%), 1/1 tablespace-R 会创建 standby.signal,并把用于连接上游的参数写入自动配置,使新节点启动后进入恢复模式并尝试连接 standby1。配置中的密码处理方式取决于认证方案,不应把长期凭据直接写进课程示例。
从上下游两侧验证传播关系
启动 standby2 后,首先在 standby2 自己确认它正在恢复,并检查 WAL Receiver 的上游信息。
SELECT pg_is_in_recovery();

SELECT status,
       sender_host,
       sender_port,
       written_lsn,
       flushed_lsn
FROM pg_stat_wal_receiver;
预期结果是恢复状态为 t,并且 sender_host 指向 standby1 的地址,而不是主库地址。LSN 和端口属于动态值。
 pg_is_in_recovery
-------------------
 t

 status    | sender_host   | sender_port | written_lsn | flushed_lsn
-----------+---------------+-------------+-------------+------------
 streaming | <STANDBY1_IP> | <PORT>      | <LSN>       | <LSN>
再到 standby1 查询 pg_stat_replication。如果级联连接正常,中继备库会看到来自 standby2 的复制连接。
SELECT application_name,
       client_addr,
       state,
       sync_state,
       sent_lsn,
       replay_lsn
FROM pg_stat_replication;
预期结果至少有一行代表下游 standby2。如果未显式设置 application_name,名称可能不是 standby2,应结合 client_addr 和连接配置判断。
 application_name | client_addr |   state   | sync_state | sent_lsn | replay_lsn
------------------+-------------+-----------+------------+----------+-----------
standby2 | <IP> | streaming | async | <LSN> | <LSN>这两侧证据组合起来才能证明拓扑成立:standby2 的 WAL Receiver 指向 standby1,同时 standby1 的 WAL Sender 正在服务该下游连接。
按带宽与故障域选择拓扑
如果所有备库都位于同一低延迟网络,且数量不多,主库直连通常更简单。每台备库独立连接主库,一个备库失联不会切断其他备库的 WAL 来源,故障关系也更容易分析。
跨机房场景则要考虑重复链路成本。假设主库位于机房 A,而机房 B 有三台备库,三台都直连主库意味着跨机房链路需要重复传输多份相似 WAL 流。让机房 B 的一台核心备库直连主库,再由它向同机房其他节点级联,可以把大部分重复流量留在机房内部。
但级联会引入新的故障集中点。如果中继备库停止、与主库断连或自身 WAL 供应出现问题,其所有下游都可能同时停止推进。设计时应把“少一条跨机房连接”与“增加一个共享故障点”同时计算,而不是只看主库连接数。
| 场景 | 更常见的选择 | 主要理由 |
|---|---|---|
| 少量同机房高可用备库 | 主库直连 | 路径短,故障相互独立 |
| 远端机房有多台只读或灾备节点 | 级联或混合 | 减少重复跨地域 WAL 流量 |
| 要求多个独立故障域都直接掌握主库复制源 | 主库直连核心备库 | 避免单个中继成为共同依赖 |
| 大量下游读取节点 | 核心备库加级联 | 分散主库 WAL Sender 与网络压力 |
不要把级联备库等同于同步提交节点
拓扑上的“下游最终会收到 WAL”和事务提交时“主库等待谁确认”是两个不同问题。同步提交由主库的同步复制策略决定,主库只能基于它直接可见的同步复制连接进行等待关系管理。
因此,若目标是让某个远端故障域参与严格的同步提交保障,更清晰的设计通常是让该故障域至少有一台核心备库直接连接主库,并把它纳入同步备库策略;其后的只读节点再从核心备库级联。不要因为下游在拓扑上位于某台同步备库之后,就假设主库提交已经等待了所有级联层级完成重放。
最终拓扑应同时回答三个问题:主库故障后哪些节点可以独立接管、任一中继失联会影响哪些下游、跨故障域需要复制多少份 WAL。能明确这三点,直连、级联或混合结构的选择才真正具备可运维性。