
PostgreSQL / 系统课时
区分同步复制与异步复制
区分同步复制与异步复制
流复制并不天然意味着事务已经安全落到备库。本课从一次事务提交的路径出发,比较异步复制与同步复制在确认时机、数据丢失窗口、提交延迟和故障可用性上的差异,并用 PostgreSQL 状态视图判断当前复制连接实际处于哪种模式。
学习目标
- 区分异步复制与同步复制的事务提交确认路径
- 判断两种模式在主库故障时的数据丢失风险与延迟代价
- 使用 PostgreSQL 状态视图确认同步备库与复制状态
提交确认发生在哪里
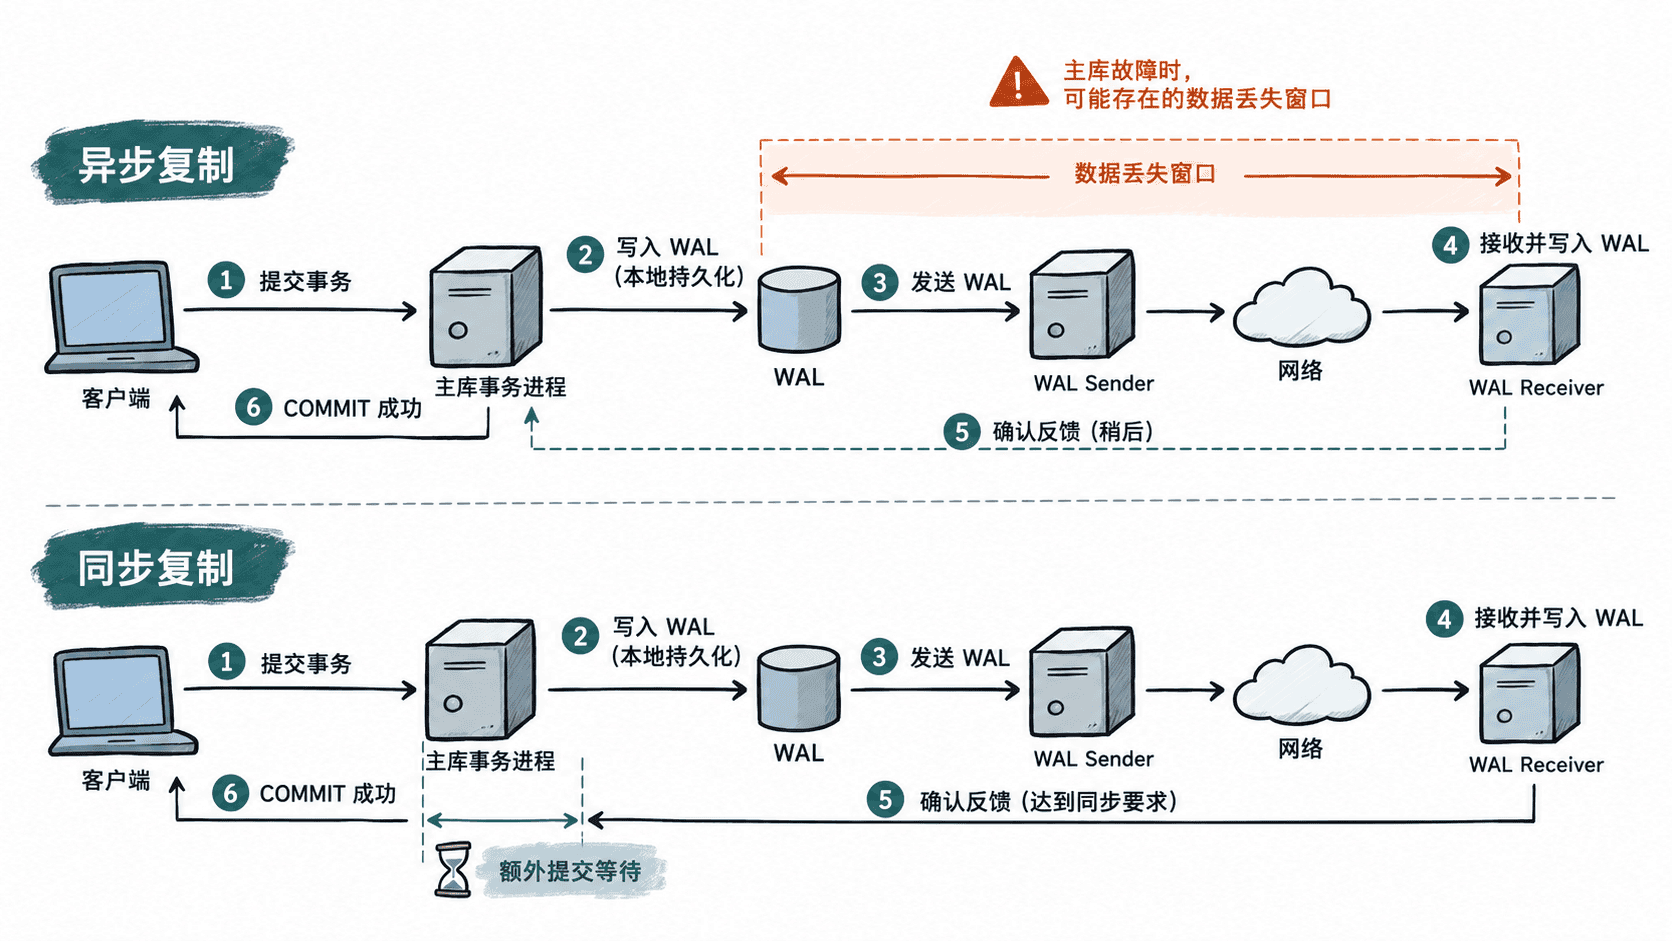
客户端执行 COMMIT 时,主库首先要把事务的 WAL 持久化到本地。之后 WAL sender 将新增 WAL 发送给备库,备库的 WAL receiver 接收数据,并根据复制进度向主库反馈位置。
异步复制的关键点是:主库完成本地提交所需的持久化后,不需要等待备库确认即可向客户端返回成功。因此正常情况下提交延迟较低,但客户端已经收到成功时,最新 WAL 可能仍停留在主库或网络传输途中。
同步复制则额外设置了提交等待条件。满足 synchronous_standby_names 选择规则的同步备库,需要把进度反馈到主库;事务必须等到 synchronous_commit 所要求的确认阶段满足后,才能完成相应的同步等待。
数据丢失窗口与延迟代价
异步复制中的风险窗口可以理解为“主库已经确认提交,但对应 WAL 尚未到达可接管备库”的时间区间。若主库在这一窗口内发生不可恢复故障,并立即把落后的备库提升为新主库,最后一部分已确认事务可能不存在于新主库。
同步复制通过把备库确认放进提交路径缩小这一窗口,但代价是客户端提交耗时会受到网络往返时间、备库 WAL 处理速度以及同步备库健康状况影响。因此同步复制主要改变的是事务确认条件,而不是让备库查询、故障切换或数据一致性自动完成。
还要区分不同的同步确认级别。synchronous_commit 可以要求等待备库接收、持久化,或者进一步等待回放;等待越靠后,提交确认所依赖的远端工作越多,通常延迟也越高。实际生产选择应以允许的数据损失目标和延迟预算为依据,而不是简单认为“同步一定更好”。
查看当前同步复制状态
可以先检查主库的同步备库配置,再观察当前复制连接。下面的 SQL 可直接在主库执行。
SHOW synchronous_standby_names;
SHOW synchronous_commit;

SELECT application_name,
       state,
       sync_state,
       sent_lsn,
       write_lsn,
       flush_lsn,
       replay_lsn
FROM pg_stat_replication
ORDER BY application_name;
预期结果
 synchronous_standby_names
---------------------------
 <VALUE>

 synchronous_commit
--------------------
 <VALUE>

 application_name | state     | sync_state | sent_lsn | write_lsn | flush_lsn | replay_lsn
------------------+-----------+------------+----------+-----------+-----------+-----------
 <VALUE>          | streaming | <VALUE>    | <VALUE>  | <VALUE>   | <VALUE>   | <VALUE>
实际的备库名称和 LSN 会不同。重点观察 sync_state:它反映该复制连接当前在同步复制选举中的状态;不能只因为存在流复制连接,就推断事务正在等待这个备库确认。同时还要把 synchronous_standby_names 与 synchronous_commit 一起检查,因为同步备库候选和事务等待级别是两个不同维度。
故障时如何选择
异步复制适合能够接受少量最新事务丢失、同时更强调写入延迟和主库提交独立性的场景。主库与备库跨较远网络部署时,异步方式也更容易避免网络延迟直接进入事务响应时间。
同步复制适合要求已确认事务尽量不能因单点主库故障而丢失的系统,但必须同时设计同步备库失联时的策略。如果配置要求必须等待某个同步备库,而该备库或网络长时间不可用,新提交可能持续等待,从“降低数据损失风险”转变为“影响写入可用性”。
选择模式时可以归结为一个取舍:异步复制优先降低提交等待,但保留故障时的最新数据窗口;同步复制把远端确认纳入提交路径,以更高的事务延迟和潜在写入阻塞换取更严格的已确认数据保护。