
PostgreSQL / 系统课时
切换数据库客户端流量
切换数据库客户端流量
新主库提升成功并不意味着业务已经完成故障切换。客户端可能仍缓存旧 DNS,连接池里仍保留旧连接,代理也可能尚未更新后端。本课把连接入口切换、旧连接淘汰和客户端读写验证串成一套可执行的流量恢复步骤。
学习目标
- 区分 DNS、VIP、数据库代理与连接池在流量切换中的作用
- 设计从入口切换到旧连接淘汰的完整刷新过程
- 从真实客户端路径验证连接、写入、提交和读取都落到新主库
先识别客户端真正使用的连接入口
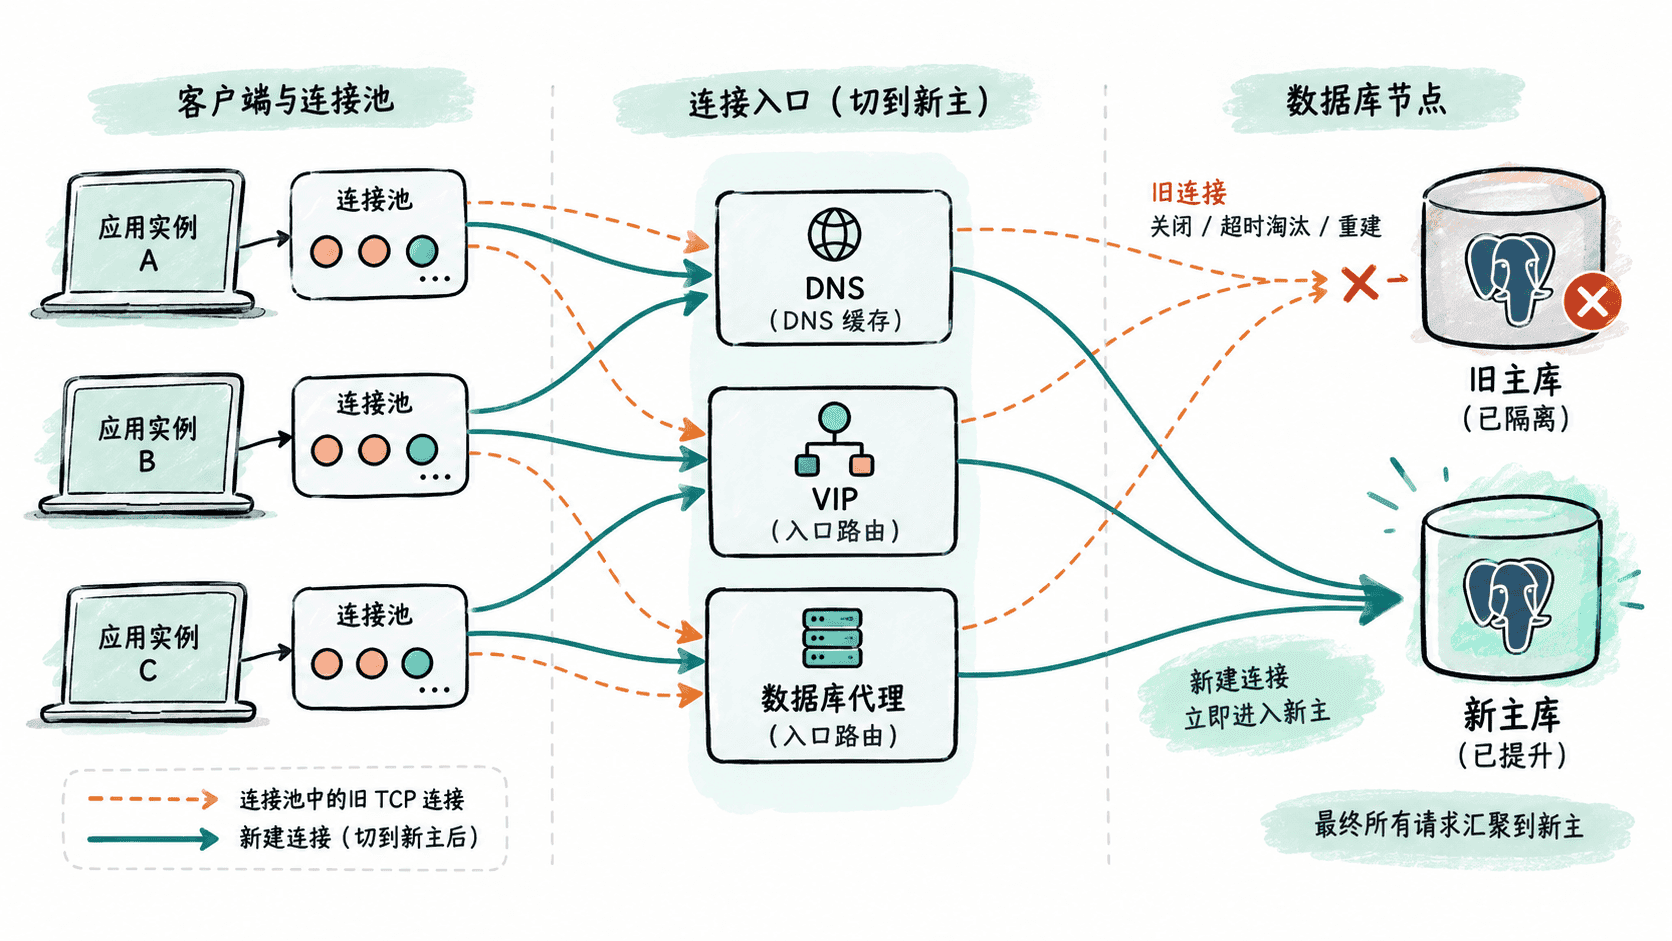
故障切换时最容易遗漏的是“数据库地址”并不一定直接指向 PostgreSQL。应用可能连接域名,域名解析到 VIP;也可能连接 PgBouncer、HAProxy 或云数据库代理,再由代理选择后端。即使入口已经更新,连接池中已经建立的 TCP 会话通常也不会自动迁移。
因此切换前应明确四层对象:应用进程、连接池、连接入口和 PostgreSQL 后端。DNS、VIP 或代理切换通常只改变链路中的某一层;已有连接是否失效、何时重连以及最终落到哪台数据库,还取决于连接池与客户端的刷新行为。
按入口类型执行切换
DNS 方案通常把数据库域名更新为新主地址。它部署简单,但实际生效速度同时受权威记录 TTL、本地 DNS 缓存、运行时解析策略和现有长连接影响,因此降低 TTL 并不等于已有连接立即迁移。
VIP 方案通过漂移同一个虚拟地址,让新主接管客户端原先访问的 IP。它可以避免应用修改主机名,但仍要处理原有 TCP 连接失效后的重连,并确保旧主已经释放 VIP,且不会继续接受写流量。
代理方案则更新后端主节点,或通过健康检查重新选择新主。它能把数据库拓扑变化与应用隔离,但健康检查不能只确认端口存活,还应确认目标节点已经退出恢复状态并具备写入能力。
如果使用 HAProxy、PgBouncer 或其他代理,应执行已经演练过的运行时切换或自动化流程,不要在事故现场临时修改未经验证的配置。无论入口类型如何,最终都要从业务客户端视角验证,而不能只依据基础设施控制面显示“已成功”。
强制淘汰指向旧主的连接
连接池会复用已经建立的连接,因此入口切换后,旧连接仍可能继续存在。若旧主已经断开,这些连接通常会在下一次使用时报错;如果旧主网络仍可达而隔离不完整,则可能形成更危险的双主写入风险,所以旧主隔离应先于客户端流量恢复完成。
应用侧应具备连接失败重试和连接池健康检查机制。故障切换时,可以滚动重启应用、调用连接池刷新能力,或临时缩短连接最大生命周期来加速旧连接淘汰。不要同时重启所有实例,以免新主刚恢复就遭遇集中认证和建连形成的重连风暴。
先从与生产应用相同的网络和连接入口新建一个 psql 会话,确认新连接实际落到哪台服务器:
SELECT inet_server_addr() AS server_addr,
       inet_server_port() AS server_port,
       pg_is_in_recovery() AS in_recovery;
预期结果:
 server_addr | server_port | in_recovery
-------------+-------------+-------------
 <IP>        | <PORT>      | f
(1 row)
<IP> 和 <PORT> 应与新主实际监听地址和端口对应,实际值因环境不同而变化。pg_is_in_recovery() 返回 f 说明该会话连接到主库,但它只能证明角色正确,不能替代真正的写入验证。
做一次端到端读写验证
只验证“能连上”不足以证明业务已经恢复。应从与生产应用相同的连接入口执行一次受控事务,覆盖认证、路由、写入、提交和提交后的再次读取。不要在故障现场临时向核心业务表写探测数据,最好事先准备专用健康检查表。
下面假设已经存在 ops_failover_probe(id bigint primary key, checked_at timestamptz not null)。示例写入一个固定探针、提交、再次读取,然后清理探针数据:
BEGIN;
INSERT INTO ops_failover_probe(id, checked_at)
VALUES (900001, clock_timestamp())
ON CONFLICT (id)
DO UPDATE SET checked_at = EXCLUDED.checked_at;
COMMIT;

SELECT id, checked_at IS NOT NULL AS persisted
FROM ops_failover_probe
WHERE id = 900001;

DELETE FROM ops_failover_probe
WHERE id = 900001;
预期结果:
BEGIN
INSERT 0 1
COMMIT
   id   | persisted
--------+-----------
 900001 | t
(1 row)

DELETE 1
这组结果同时证明当前入口允许事务提交,并且提交后的新会话可见数据能够被读取。若环境没有专用探针表,应改用事先定义的幂等健康检查流程,而不是临时改动生产业务数据。
处理失败连接和重连风暴
入口切换后的短时间内,常见现象是旧连接出现 connection reset、server closed the connection unexpectedly 或连接建立超时。应用应把这类连接级失败与业务 SQL 错误区分开:物理连接已经失效时,应丢弃该连接并重新从连接池获取,而不是持续在同一个坏连接上重试。
重连策略应加入退避和抖动,避免大量应用实例在同一秒同时创建连接。同时观察新主的连接数、认证失败、CPU 和磁盘延迟,必要时分批刷新应用实例。可以在新主观察客户端连接数量:
SELECT count(*) AS client_connections
FROM pg_stat_activity
WHERE backend_type = 'client backend';
预期结果:
 client_connections
--------------------
 <VALUE>
(1 row)
<VALUE> 会随着连接池规模和业务流量变化。切换后应关注它是否平稳恢复,而不是追求某个固定数字;如果连接数在极短时间持续暴涨,应优先检查客户端是否正在高频、无退避地重试。
以客户端视角完成验收
流量切换完成至少要同时满足:新建连接指向新主,旧连接正在被淘汰,受控写事务能够成功提交,提交后的数据能够从真实客户端路径读取,并且业务错误率与数据库连接数没有继续恶化。只有 DNS、VIP 或代理已经改指向新主,不能作为故障切换完成的依据。
安全顺序应保持为:先隔离旧主,再更新连接入口,随后逐步刷新旧连接,最后从真实客户端路径完成读写验收。这样才能把“数据库已经提升”真正转化为“业务已经恢复服务”。