
PostgreSQL / 系统课时
理解物理流复制工作链路
理解物理流复制工作链路
物理流复制的关键不是“把数据文件实时复制到备库”,而是持续传输 WAL,并由备库按恢复机制重放。理解 WAL Sender、WAL Receiver、Startup Process 与备库数据目录的协作关系后,你就能把复制延迟拆成发送、接收写入、持久化和回放几个可观测阶段。
学习目标
- 能说明 WAL Sender、WAL Receiver 与 Startup Process 在物理流复制中的职责边界。
- 能按发送、接收写入、刷盘和回放理解 WAL 从主库到备库的数据路径。
- 能读取备库的接收与回放 LSN,判断延迟发生在传输侧还是回放侧。
WAL 复制的是变更记录
主库事务修改数据页时,会先生成 WAL。物理流复制传输的是这些 WAL 记录,而不是逐条 SQL,也不是每次把修改后的数据文件复制到备库。备库收到 WAL 后,通过恢复过程重放同样的物理变更,使自身数据目录逐步追上主库。
这意味着物理流复制面向整个 PostgreSQL 数据库集群实例工作,主备需要兼容的数据目录格式。它保留了主库的底层数据库状态,因此非常适合作为热备与故障切换基础,但不提供按表筛选复制的语义。
三个进程如何协作
主库上的 WAL Sender 为每个直接连接的备库发送 WAL。备库上的 WAL Receiver 主动连接上游,接收字节流并写入备库的 pg_wal;Startup Process 则按照恢复流程读取可用 WAL,并把记录回放到备库的数据状态中。
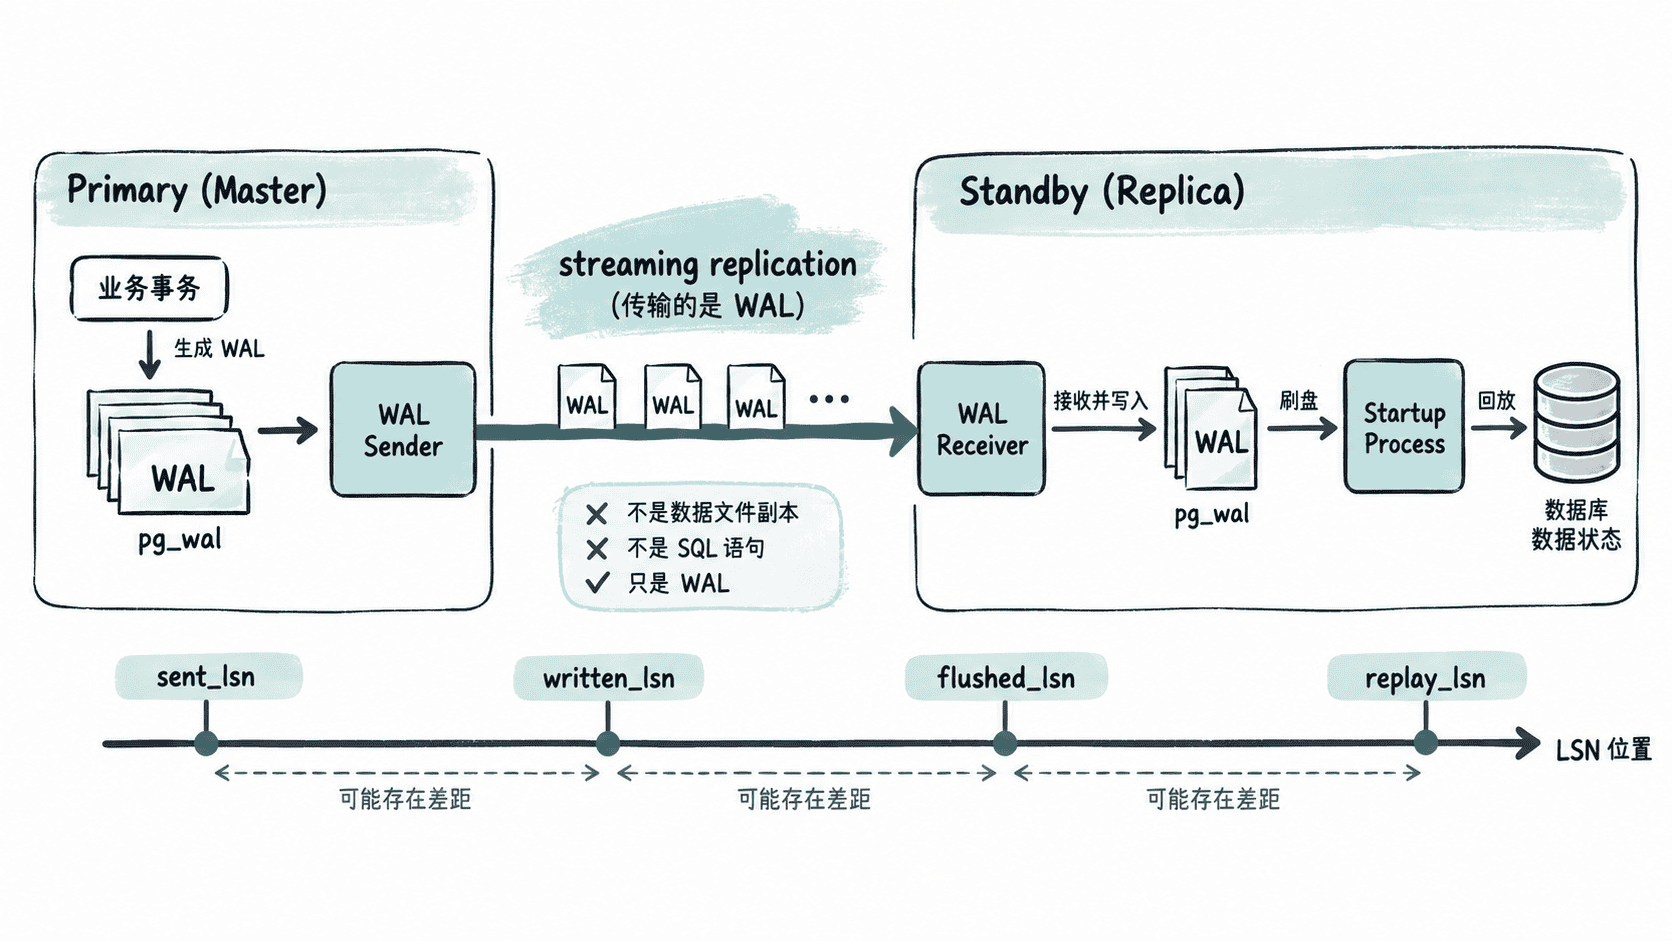
可以把这条链路理解为四个位置。WAL Sender 已发送到哪里,是发送进度;WAL Receiver 收到并写到操作系统缓冲或文件位置,是写入进度;真正刷到持久化存储后形成 flush 进度;Startup Process 实际重放到哪里,则是 replay 进度。不同位置之间的差距就是不同阶段的积压。
用 LSN 看接收与回放
在备库执行下面的 SQL,可以同时观察 WAL Receiver 的连接状态、接收写入与刷盘位置,以及恢复进程已经回放到的位置。
SELECT
    w.status,
    w.sender_host,
    w.sender_port,
    w.written_lsn,
    w.flushed_lsn,
    pg_last_wal_replay_lsn() AS replay_lsn
FROM pg_stat_wal_receiver AS w;
预期结果
 status    | sender_host | sender_port | written_lsn | flushed_lsn | replay_lsn
-----------+-------------+-------------+-------------+-------------+------------
streaming | <HOST> | <PORT> | <LSN> | <LSN> | <LSN><HOST>、<PORT> 和 <LSN> 都是动态值。正常流复制时通常会看到一行 streaming 状态;如果视图没有记录,说明当前没有活动的 WAL Receiver,需要继续检查备库是否处于恢复模式、上游连接配置、认证、网络以及主库是否允许复制连接。
从差距判断瓶颈位置
如果主库不断产生 WAL,而备库接收位置长期落后,优先怀疑网络吞吐、上游发送能力或接收端 I/O。若 written_lsn 与 flushed_lsn 差距明显,说明 WAL 已到达备库,但持久化速度跟不上,应关注存储延迟。
若 flushed_lsn 已接近最新接收位置,而 replay_lsn 明显落后,瓶颈就在回放侧。常见原因包括备库 I/O 压力、恢复冲突或 WAL 回放本身跟不上主库产生速度。此时继续优化网络通常不会解决问题。
主库的 pg_stat_replication 还能从发送端观察 sent_lsn、write_lsn、flush_lsn 和 replay_lsn。把两端视图放在同一条 LSN 链上,就能把“复制慢”拆成明确阶段,而不是只看一个笼统的延迟数字。
流复制与故障切换的关系
流复制负责让备库持续接近主库状态,故障切换负责在主库不可用时改变写入角色。两者不是同一件事:复制链路健康只能说明备库正在追赶,不能自动完成主库失效检测、旧主库隔离、客户端改向和备库提升。
因此,在高可用设计里,应把物理流复制看成“数据状态持续准备机制”。只有当发送、刷盘与回放进度都能被观测,并且切换流程能安全处理旧主库与客户端入口时,这条复制链路才真正具备可用于故障接管的工程价值。