
PostgreSQL / 系统课时
使用 pg_rewind 重建旧主
使用 pg_rewind 重建旧主
故障切换后,旧主与新主可能已经进入不同时间线,不能只修改连接参数后直接把旧主作为备库启动。本课用 pg_rewind 完成前置检查、dry-run、实际回绕与双向验证,把旧主安全重新加入当前主库。
学习目标
- 判断旧主是否满足
pg_rewind的硬性前置条件 - 用 dry-run 验证时间线、系统标识和所需 WAL,再执行实际回绕
- 验证旧主以备库角色连接当前主库并恢复流复制
判断是否具备回绕条件
假设节点 A 原来是主库,节点 B 已提升为当前主库。A 在分叉后若继续产生过 WAL,两边就不再是可以直接继续复制的同一数据状态。pg_rewind 会依据时间线历史确定分叉位置,再扫描目标侧分叉后的 WAL,找出需要用源端内容覆盖的关系数据块,并复制其他必要文件。
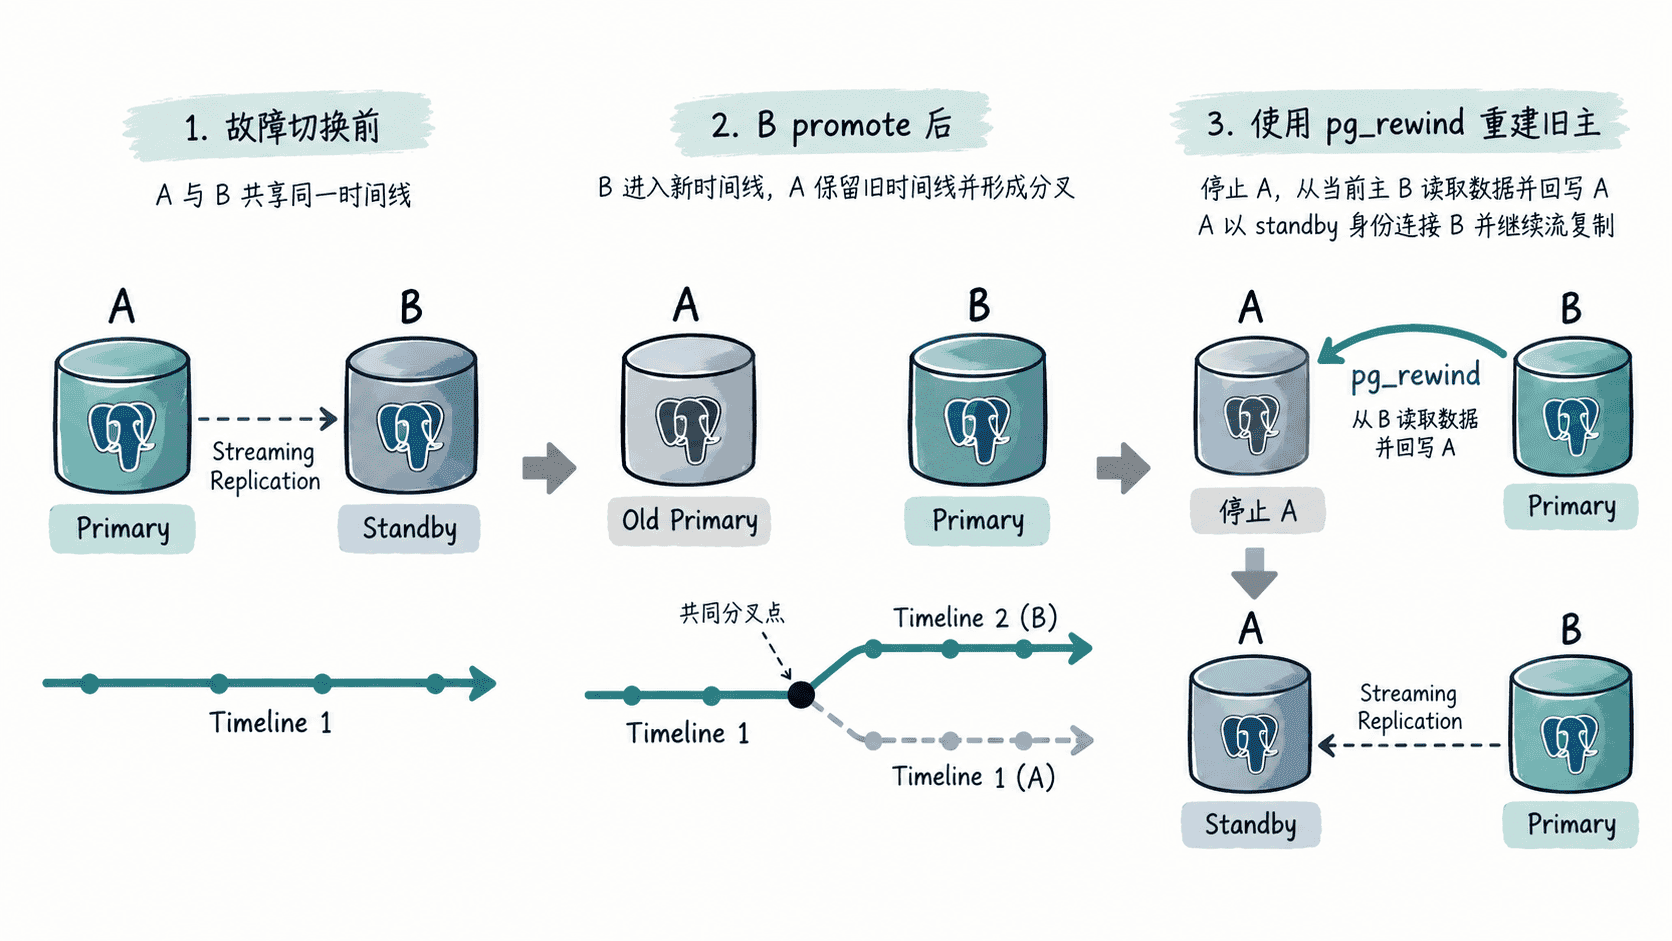
执行前要把条件和操作绑定在一起:目标目录必须属于与当前主库同一原始集群,目标实例执行回绕时必须停止;目标在分叉前已经启用数据校验和,或已经启用 wal_log_hints=on,同时 full_page_writes 保持开启。--source-server 必须使用普通 libpq 数据库连接,源端需要处于运行状态,连接角色必须具备 pg_rewind 读取源端文件信息所需的权限。
先停旧主并检查目标目录。若旧主本来已经停止,条件判断会直接跳过停库动作。下面同时检查校验和、wal_log_hints、full_page_writes,并用普通数据库连接确认当前主库可访问。
if pg_ctl -D <PATH> status >/dev/null 2>&1; then
  pg_ctl -D <PATH> stop -m fast >/dev/null
fi

pg_controldata <PATH> | grep -E 'Database cluster state|Data page checksum version'
printf 'wal_log_hints=%s\n' "$(postgres -D <PATH> -C wal_log_hints)"
printf 'full_page_writes=%s\n' "$(postgres -D <PATH> -C full_page_writes)"
psql "host=<IP> port=<PORT> user=rewind_user dbname=postgres" -Atc "SELECT pg_is_in_recovery();"
预期输出
Database cluster state:               shut down
Data page checksum version:           <VALUE>
wal_log_hints=<VALUE>
full_page_writes=on
f
Data page checksum version 的实际值取决于初始化方式;若校验和未启用,则必须确认分叉发生前就已经启用 wal_log_hints=on。故障后才修改该参数,不能补齐之前缺失的 WAL 信息。最后一行 f 表示 --source-server 指向当前主库而不是仍处于恢复状态的节点。
用 dry-run 作为执行门禁
dry-run 会完成源端连接、系统标识兼容性检查、时间线分析和目标 WAL 扫描,但不修改目标目录。它也是“两个目录来自同一原始集群”的实际门禁:系统标识不一致时应直接停止,而不是尝试绕过检查。
pg_rewind \
  --target-pgdata=<PATH> \
  --source-server="host=<IP> port=<PORT> user=rewind_user dbname=postgres" \
  --dry-run \
  --progress
预期结果
pg_rewind: servers diverged at WAL location <VALUE> on timeline <VALUE>
pg_rewind: rewinding from last common checkpoint at <VALUE> on timeline <VALUE>
pg_rewind: Done!
具体日志行数会因 PostgreSQL 版本和数据量不同而变化,验收条件是命令正常退出且没有兼容性或 WAL 错误。若提示分叉点附近的目标 WAL 已不在 pg_wal,并且目标配置中的 restore_command 能从归档取回这些 WAL,可在同一条命令中增加 --restore-target-wal 后重新 dry-run;若归档也缺失所需 WAL,就应停止回绕方案并改用新的基准备份。
执行回绕并准备备库
确认 dry-run 成功后执行实际回绕。--write-recovery-conf 会在目标目录创建 standby.signal,并根据 --source-server 的连接信息写入恢复连接配置。下面假设 rewind_user 同时可用于后续物理复制;若实际环境使用独立复制账号,应在启动前把 primary_conninfo 调整为该账号。
pg_rewind \
  --target-pgdata=<PATH> \
  --source-server="host=<IP> port=<PORT> user=rewind_user dbname=postgres application_name=old_primary_rejoined" \
  --write-recovery-conf \
  --progress
预期结果
pg_rewind: servers diverged at WAL location <VALUE> on timeline <VALUE>
pg_rewind: rewinding from last common checkpoint at <VALUE> on timeline <VALUE>
pg_rewind: Done!
pg_rewind 不会把旧主分叉后的独有提交合并进当前主库。它会以当前主库为源重新对齐目标数据目录,因此旧主在分叉后独有的写入会被舍弃。回绕结束后,目标启动时还要继续重放所需 WAL,直到数据目录达到一致状态。
启动并双向验证复制
确认 standby.signal 和恢复连接配置正确后启动旧主。先在旧主验证恢复状态与 WAL receiver,再到当前主库验证对应的 replication sender,避免只看单侧状态。
test -f <PATH>/standby.signal && echo "standby.signal=present"
pg_ctl -D <PATH> start
psql -d postgres -c "SELECT pg_is_in_recovery();"
psql -d postgres -c "SELECT status, sender_host, sender_port FROM pg_stat_wal_receiver;"
预期输出
standby.signal=present
waiting for server to start.... done
server started
 pg_is_in_recovery
-------------------
 t
(1 row)

  status   | sender_host | sender_port
-----------+-------------+-------------
 streaming | <IP>        | <PORT>
(1 row)
再在当前主库执行反向确认。
SELECT application_name, state, sync_state
FROM pg_stat_replication
WHERE application_name = 'old_primary_rejoined';
预期输出
    application_name     |   state   | sync_state
-------------------------+-----------+------------
 old_primary_rejoined    | streaming | <VALUE>
(1 row)
sync_state 取决于同步复制策略,可能是 async、sync、potential 等状态。最终至少同时满足三点:旧主的 pg_is_in_recovery() 为 true,WAL receiver 进入 streaming,当前主库能看到对应 replication sender;这样才能确认旧主已经完成回绕并重新作为物理备库加入拓扑。