
PostgreSQL / 系统课时
演练旧主恢复与拓扑重建
演练旧主恢复与拓扑重建
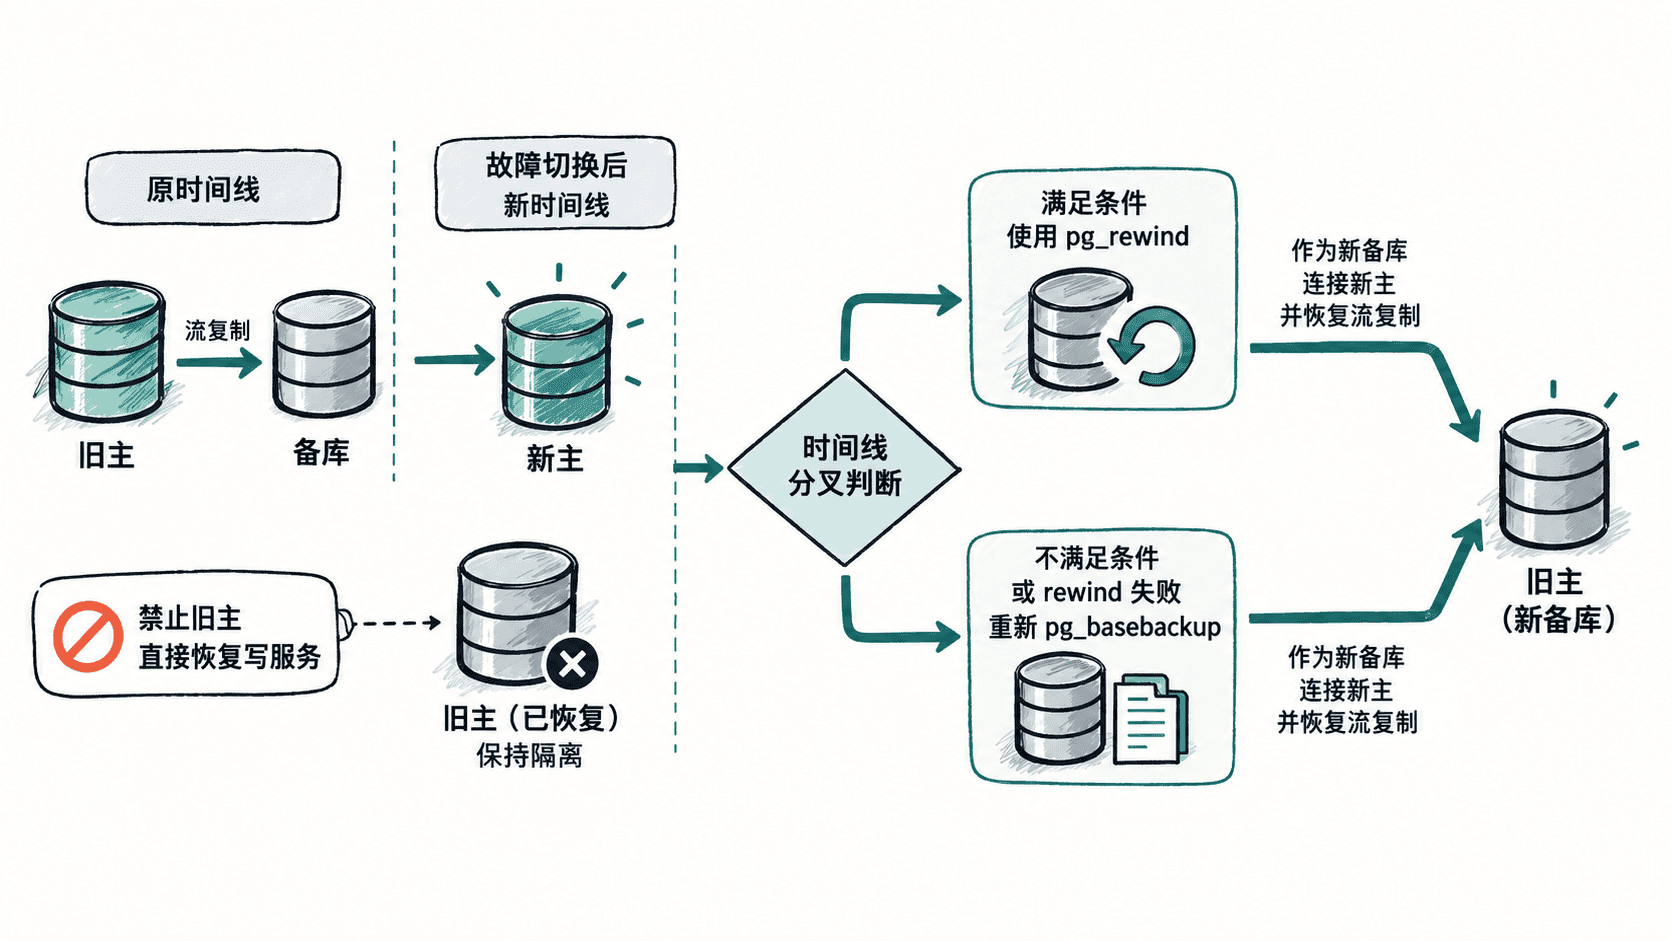
本课处理故障切换后的第二个关键问题:旧主重新上线时,不能直接把它接回集群。你将先确认时间线已经分叉,再根据前置条件选择 pg_rewind 或重新做基准备份,把旧主重建为新主的备库,并验证流复制重新稳定。
学习目标
- 判断提升后的新主与旧主是否已经产生时间线分叉
- 正确选择
pg_rewind或重新基准备份恢复旧主 - 验证旧主作为新备库重新进入持续流复制状态
先阻止旧主直接对外服务
旧主恢复电源或 PostgreSQL 进程后,仍要维持 fencing,不能把客户端流量立即切回。新主提升后会进入新的时间线,而旧主本地可能保留只存在于旧时间线上的 WAL;如果双方都继续接受写入,就会产生无法靠普通流复制自动合并的两套历史。
确认新主与旧主的时间线关系
先在新主上查看当前时间线。为了保持演练过程直观,可以使用 pg_controldata 查看控制文件记录的最近检查点时间线,并结合 PostgreSQL 日志中的提升记录判断角色变化。
pg_controldata <NEW_PRIMARY_DATA_DIR> | grep -E 'Latest checkpoint.*TimeLineID|Database cluster state'预期结果
Database cluster state:               in production
Latest checkpoint's TimeLineID:       <TIMELINE_ID>
随后在保持停库的旧主上执行同样检查。时间线 ID 不同并不单独说明所有数据差异,但在发生过提升后,它是“旧主不能直接按原历史继续工作”的重要证据。真正的共同祖先位置会由 pg_rewind 根据时间线历史和 WAL 记录判断。
判断能否使用 pg_rewind
pg_rewind 适合“数据目录大部分相同,只需把分叉后的少量块改回新主历史”的场景。目标节点是旧主的数据目录,源节点是当前新主。关键前提是旧主集群在初始化时启用了数据校验和,或在分叉前启用了 wal_log_hints=on;此外,执行 rewind 需要能够取得判断分叉和恢复所需的 WAL 与时间线历史文件。
先在旧主确认相关条件。
pg_controldata <OLD_PRIMARY_DATA_DIR> | grep -E 'Data page checksum version'
postgres -D <OLD_PRIMARY_DATA_DIR> -C wal_log_hints
预期结果
Data page checksum version:           <VALUE>
<on|off>
若校验和版本为非零值,表示启用了数据校验和;若未启用校验和,则应确保 wal_log_hints 在分叉前就是 on。两者都不满足时,不应强行使用 pg_rewind,直接重新做基准备份更可靠。
用 pg_rewind 重建旧主
确保旧主 PostgreSQL 已停止,然后以新主为源执行 rewind。示例假设维护账号具备读取源端所需系统信息的权限,且网络只允许旧主主动连接新主。
pg_rewind --target-pgdata=<OLD_PRIMARY_DATA_DIR> \
  --source-server='host=<NEW_PRIMARY_HOST> port=<PORT> user=<REWIND_USER> dbname=postgres' \
  --progress
预期结果
servers diverged at WAL location <LSN> on timeline <TIMELINE_ID>
rewinding from last common checkpoint at <LSN> on timeline <TIMELINE_ID>
Done!
具体 LSN、时间线和进度行会随演练而变化。pg_rewind 完成后,还需要把该节点配置成新主的备库,例如准备 standby.signal、设置 primary_conninfo,并确保复制槽策略与现场设计一致。
条件不满足时重新做基准备份
如果所需 WAL 已不可取得、前置条件不满足,或 rewind 失败且不值得继续修复,最清晰的路径是备份或移走旧数据目录,然后从新主重新获取基准备份。下面使用 -R 自动写入备库所需的连接配置并创建 standby.signal。
pg_basebackup -h <NEW_PRIMARY_HOST> -p <PORT> -U <REPLICATION_USER> \
  -D <OLD_PRIMARY_DATA_DIR> -R -X stream -P
预期结果
<PROGRESS_OUTPUT>进度输出取决于数据量和 PostgreSQL 版本。执行前必须确保目标目录为空或不存在,并确认复制用户、pg_hba.conf 与网络策略允许连接。
启动新备库并验证复制稳定
启动重建后的旧主,使其以备库身份连接当前新主。
pg_ctl -D <OLD_PRIMARY_DATA_DIR> start预期结果
waiting for server to start.... done
server started
然后在该节点验证恢复状态和 WAL 接收进程。
SELECT pg_is_in_recovery() AS in_recovery,
       status,
       sender_host,
       latest_end_lsn
FROM pg_stat_wal_receiver;
预期结果
 in_recovery |  status   | sender_host | latest_end_lsn
-------------+-----------+-------------+---------------
 t           | streaming | <HOST>      | <LSN>
最后还应在新主检查 pg_stat_replication,确认该备库处于 streaming,并观察 sent_lsn、write_lsn、flush_lsn、replay_lsn 是否持续推进。只有旧主保持备库角色、复制持续追平、客户端仍只写新主,并且 fencing 策略已按新拓扑更新,故障后的主备关系才算真正重建完成。