
PostgreSQL / 系统课时
重新基准备份加入备库
重新基准备份加入备库
当旧节点已经不适合安全执行 pg_rewind 时,更可靠的做法是隔离旧数据目录,从当前主库重新取得完整基准备份。本课完成数据目录重建、复制槽选择、pg_basebackup 执行以及流复制双端验收。
学习目标
- 判断何时应放弃旧数据目录并重新执行基准备份
- 使用
pg_basebackup创建可启动且配置完整的新备库 - 根据复制槽状态处理新建、复用、失败与 WAL 容量风险
什么时候应该重新做基准备份
重新基准备份的主要代价是完整传输数据,但它不依赖旧节点还能正确回绕。当 pg_rewind 的必要前提缺失,或者旧数据目录本身已不可信时,重新取得当前主库的一致副本通常更稳妥。
典型情况包括:旧主没有启用数据校验和且 wal_log_hints 也未满足要求;分叉所需 WAL 已被删除且归档中不存在;旧数据目录损坏;pg_rewind 在修改目录过程中失败;或者已经无法确认该目录是否仍属于当前集群。此时不应靠复制少量文件或重置 WAL 来修补旧目录。
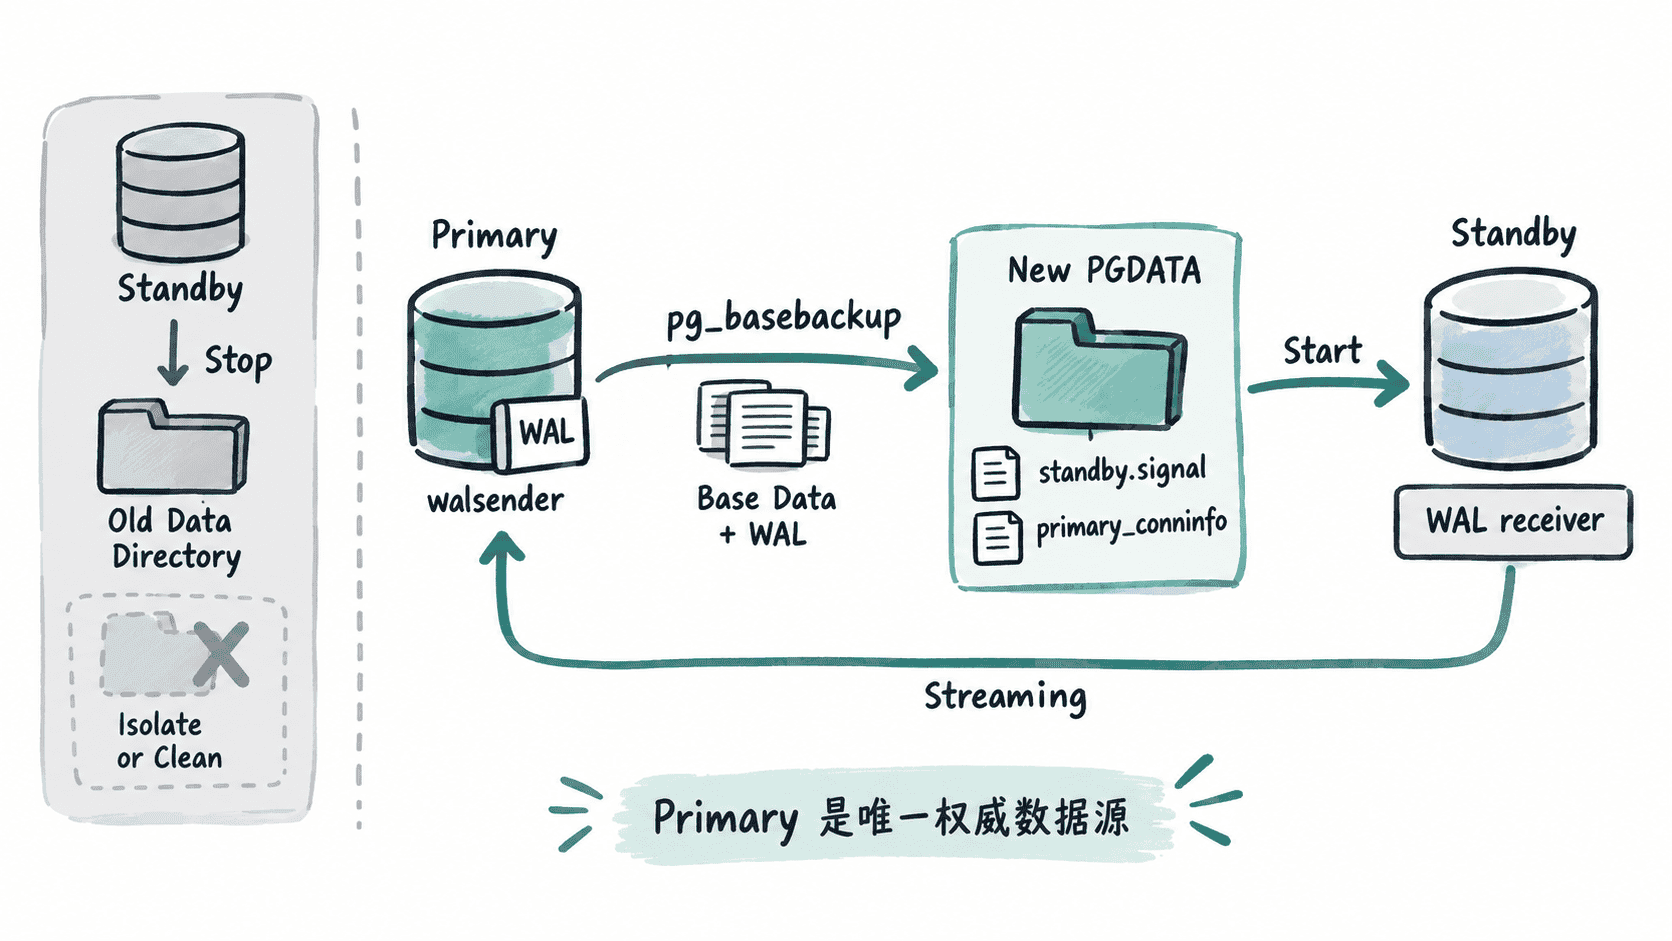
准备空的数据目录
在待重建节点上停止 PostgreSQL,并以数据库系统用户执行目录操作。新的目标目录必须为空,权限也必须允许 PostgreSQL 独占访问。
pg_ctl -D <PATH> stop -m fast
mv <PATH> <PATH>.old
mkdir <PATH>
chmod 700 <PATH>
预期结果
server stoppedmv、mkdir 和 chmod 成功时通常没有输出;pg_ctl 的等待提示可能因版本和运行状态不同而变化。执行前应分别确认 <PATH> 与 <PATH>.old 指向正确位置,并预留足以容纳完整副本的磁盘空间。
当前主库还必须允许复制账号建立物理复制连接。账号需要 LOGIN 与 REPLICATION 权限,pg_hba.conf 必须允许待重建节点连接 replication 通道。
先决定复制槽分支
复制槽不是建立备库的强制条件,但专属物理槽能够防止主库在备库尚未消费 WAL 时过早回收相关 WAL。槽也会带来容量责任,因此应在开始完整复制前先确认槽状态,而不是盲目使用 -C -S。
在当前主库查询计划使用的槽,并估算它当前可能保留的 WAL:
SELECT slot_name,
       slot_type,
       active,
       restart_lsn,
       CASE
         WHEN restart_lsn IS NULL THEN NULL
         ELSE pg_size_pretty(
           pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)::bigint
         )
       END AS approx_retained_wal
FROM pg_replication_slots
WHERE slot_name = '<ID>';
预期结果
 slot_name | slot_type | active | restart_lsn | approx_retained_wal
-----------+-----------+--------+-------------+--------------------
 <ID>      | physical  | f      | <VALUE>     | <VALUE>
(1 row)
槽不存在时查询返回 (0 rows)。根据结果选择操作分支:
- 新建专属槽:槽不存在时使用
-C -S <ID>,让pg_basebackup在开始备份前创建该槽。 - 复用已有槽:确认它是这台重建备库的物理槽且没有被其他客户端占用后,去掉
-C,保留-S <ID>;槽已存在却继续使用-C会直接失败。 - 不使用持久槽:去掉
-C和-S。在-X stream下,基础备份期间仍会保护自身需要的 WAL,但备库启动后的持续复制不再依赖该专属持久槽。
如果创建失败,应先根据错误原因处理:槽名已存在就检查是否可以复用;复制账号权限不足就修正权限;复制槽数量达到限制就清理确认无用的槽或调整容量规划。不要在这些错误未解决时继续使用不完整的数据目录。
还要把槽的 WAL 保留量与主库 pg_wal 所在磁盘的可用空间一起评估。备库长时间离线,或者 -C 已经成功创建槽但后续基础备份失败,都可能留下持续保留 WAL 的槽。若决定放弃本次重建,应再次检查新建槽,并只在确认没有客户端需要它时清理。
从当前主库执行 pg_basebackup
下面以“创建新的专属物理槽”为主示例。-F plain 将文件直接写入目标目录,-X stream 在复制数据文件的同时通过额外复制连接接收 WAL,-R 创建 standby.signal 并写入连接参数;指定 -S 后,槽名也会写入恢复配置。若前一步选择复用已有槽,只需从该命令移除 -C。
pg_basebackup -h <IP> -p <PORT> -U standby_user -D <PATH> -F plain -X stream -R -S <ID> -C -P && echo "basebackup_ok"
test -f <PATH>/standby.signal && echo "standby.signal exists"
grep -E '^(primary_conninfo|primary_slot_name)' <PATH>/postgresql.auto.conf
预期输出
<VALUE>/<VALUE> kB (100%), <VALUE>/<VALUE> tablespace
basebackup_ok
standby.signal exists
primary_conninfo = '<VALUE>'
primary_slot_name = '<ID>'
进度值、数据量和表空间数量会随集群变化,因此不能用某一组固定数字判断成功。更可靠的成功条件是 pg_basebackup 返回状态为 0,随后出现人为输出的 basebackup_ok,且 standby.signal、primary_conninfo 与所选槽配置均存在。
密码应通过 .pgpass、证书或其他受控凭据机制提供,不要为了方便把明文密码写进脚本。若命令失败,目标目录可能已经包含部分文件;排除根因后应重新准备空目录,再重新执行基础备份,而不是把失败目录直接启动为备库。
启动并验收新备库
基础备份成功后启动 PostgreSQL。先在重建节点确认它处于恢复模式,并检查 WAL receiver 是否已经进入 streaming。
pg_ctl -D <PATH> start
psql -d postgres -c "SELECT pg_is_in_recovery();"
psql -d postgres -c "SELECT status, sender_host, sender_port FROM pg_stat_wal_receiver;"
预期输出
server started
 pg_is_in_recovery
-------------------
 t
(1 row)

  status   | sender_host | sender_port
-----------+-------------+-------------
 streaming | <IP>        | <PORT>
(1 row)
启动过程中的等待提示可能不同,验收重点是 pg_is_in_recovery() 返回 t,并且 WAL receiver 持续处于 streaming。
最后在当前主库确认发送端和复制槽都已经被新备库实际使用:
SELECT application_name, client_addr, state, sync_state
FROM pg_stat_replication;
预期输出
 application_name | client_addr |   state   | sync_state
------------------+-------------+-----------+-----------
 <VALUE>           | <IP>        | streaming | <VALUE>
(1 row)
若没有显式配置 application_name,显示值可能不同。重新基准备份真正完成的标准不是“文件复制结束”,而是新目录来自当前主库、节点启动后保持 recovery、WAL 收发两侧持续显示流式复制,并且所采用的复制槽策略没有留下不可控的 WAL 保留风险。