
PostgreSQL / 系统课时
演练主库故障与人工切换
演练主库故障与人工切换
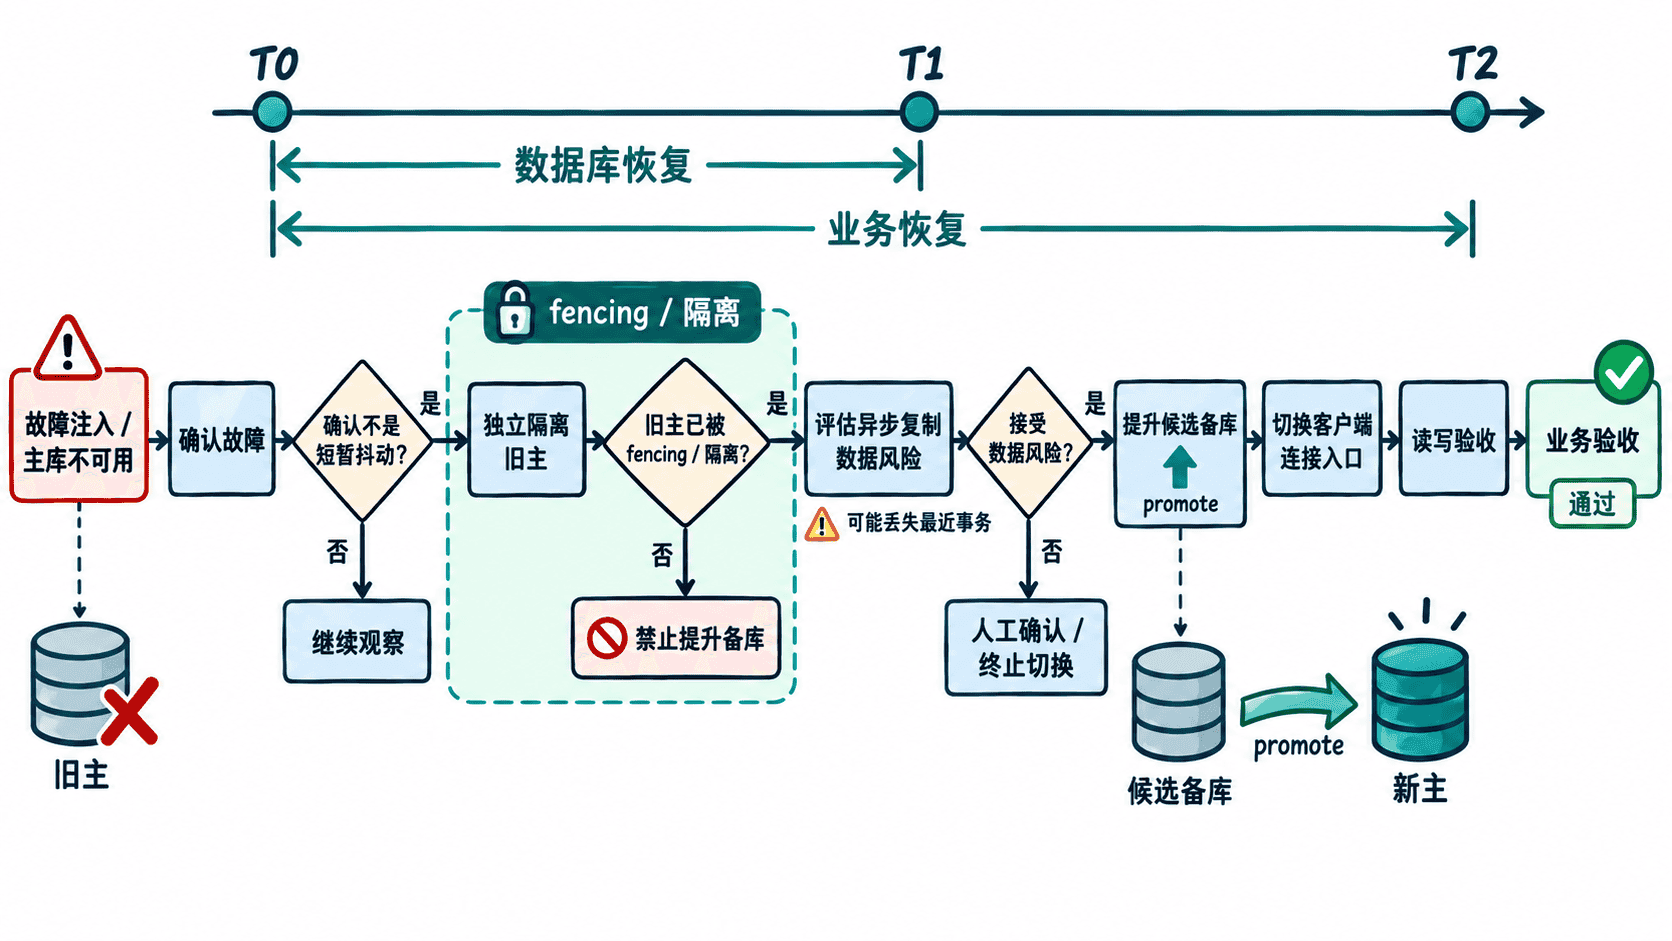
本课把一次“主库突然不可用”完整走通:先确认故障并隔离旧主,再判断复制数据风险,提升备库、切换客户端并验收。重点不是追求最快恢复,而是保证每一步都有证据、有回退边界,并记录实际恢复时间。
学习目标
- 按“确认故障→隔离旧主→判断数据风险→提升备库→切换客户端→验收”的顺序完成人工切换
- 使用 PostgreSQL 状态函数确认备库提升前后的角色与复制状态
- 区分受控停止与真实主机故障的 fencing 语义,并记录可复盘的 RTO 数据
建立演练边界与计时点
演练前先确定主库、候选备库和客户端连接入口,并确认没有其他人会同时执行切换。至少记录三个时间点:T0 为主库停止或故障注入时间,T1 为备库完成提升时间,T2 为客户端恢复成功时间。这样可分别得到数据库恢复时间 T1-T0 与业务恢复时间 T2-T0。
注入受控故障并确认现象
本演练选择在实验主库上主动停止 PostgreSQL,作为受控故障注入。这与真实事故中的主机掉电、操作系统崩溃或网络分区不是同一种故障:真实事故如果主机已经不可达,不需要也往往无法再执行 pg_ctl stop,而应直接进入故障确认和独立 fencing 流程。
pg_ctl -D <PRIMARY_DATA_DIR> stop -m immediate预期结果
waiting for server to shut down.... done
server stopped
实际输出中的等待点数量可能不同。随后从客户端或运维节点再次连接原主库,应出现连接失败;若仍能成功读写,说明本次故障注入或客户端接入隔离未按预期生效。
这里必须严格限定验收结论:主动 stop 证明数据库进程已停止,并且对依赖该进程的写入路径构成了部分 fencing;客户端连接失败也只证明已测试的接入路径不可用。二者都不能证明旧主在进程被重新启动、网络恢复或其他管理入口生效后仍无法接受写入。
隔离旧主并判断数据风险
完成受控停止后,仍要按真实切换标准验证隔离:确保旧主即使自行恢复或被重新启动,也不能重新接受客户端写入。可使用网络 ACL、负载均衡摘除、存储隔离或主机级 fencing,并保留可核验的生效证据。只有这个门禁通过,才进入备库提升判断。
在候选备库确认它仍处于恢复模式,并查看最近接收与回放的 WAL 位置。
SELECT pg_is_in_recovery() AS in_recovery,
       pg_last_wal_receive_lsn() AS receive_lsn,
       pg_last_wal_replay_lsn() AS replay_lsn,
       now() - pg_last_xact_replay_timestamp() AS replay_delay;
预期结果
 in_recovery | receive_lsn | replay_lsn | replay_delay
-------------+-------------+------------+--------------
t | <LSN> | <LSN> | <INTERVAL>这里的验收字段必须与实际函数一致:pg_is_in_recovery() 返回 t,说明候选节点尚未提升;receive_lsn 与 replay_lsn 的实际值取决于演练时 WAL 进度。若尚未回放过事务,replay_delay 也可能为 NULL。
若主库已经不可访问,就无法直接证明“最后一个已提交事务一定传到备库”。异步复制必须接受可能丢失尚未传送 WAL 的风险;若业务要求零数据丢失,应在架构层采用满足条件的同步复制,而不是在故障后临时假设 RPO 为零。
提升备库并切换客户端
确认旧主已经独立隔离、数据风险可以接受后,在候选备库执行提升。pg_promote(true, 60) 会等待提升完成,等待时间超过 60 秒时返回 false。
SELECT pg_promote(true, 60) AS promoted;
SELECT pg_is_in_recovery() AS in_recovery;
预期结果
 promoted
----------
 t

 in_recovery
------------
 f
第二条结果中的字段名与实际执行的 pg_is_in_recovery() 一致;返回 f 才能作为“节点已经离开恢复模式”的可比对验收证据。若 60 秒内未完成提升,第一条语句可能返回 f,此时应检查 PostgreSQL 日志和实例状态,而不是反复执行提升。
提升成功后,把客户端连接入口切换到新主库,例如更新 VIP、代理后端或服务发现记录;具体动作取决于既有接入架构。
验收写入与重新建立保护
客户端切换后,用一笔可回滚或专门的演练写入验证新主库确实可读写,同时确认应用错误率和连接池恢复。数据库侧可先检查角色与事务写能力。
SELECT pg_is_in_recovery() AS in_recovery,
       current_setting('transaction_read_only') AS read_only,
       pg_current_wal_lsn() AS current_lsn;
预期结果
 in_recovery | read_only | current_lsn
-------------+-----------+------------
 f           | off       | <LSN>
最后记录 T0、T1、T2,并把故障识别、人工决策、提升和客户端切换耗时分别记录。切换完成不代表高可用已经恢复:旧主仍应保持隔离,直到完成时间线判断和拓扑重建;新主重新拥有健康备库后,本次演练才真正闭环。