
PostgreSQL / 系统课时
认识 PostgreSQL 高可用故障链路
认识 PostgreSQL 高可用故障链路
高可用不是“有一台备库就不会中断”。本课从业务请求出发,把数据库进程、主机、存储、网络和客户端连接串成一条故障链,并明确恢复、切换与数据一致性分别解决什么问题,帮助你先判断故障属于哪一层,再决定是否需要切换。
学习目标
- 能按进程、主机、存储、网络和客户端连接定位 PostgreSQL 可用性故障层级。
- 能区分恢复、故障切换和数据一致性三个目标,避免把“服务恢复”误认为“数据零丢失”。
- 能用最小连通性检查判断数据库是否仍能接受客户端连接。
从业务请求反推故障链
一次数据库请求要真正成功,至少依赖客户端能找到正确地址、网络可达、PostgreSQL 实例可接受连接、主机与存储可用,以及事务所需的数据页和 WAL 能正常读写。任一环节失效,都可能表现为“数据库不可用”,但处置方式并不相同。
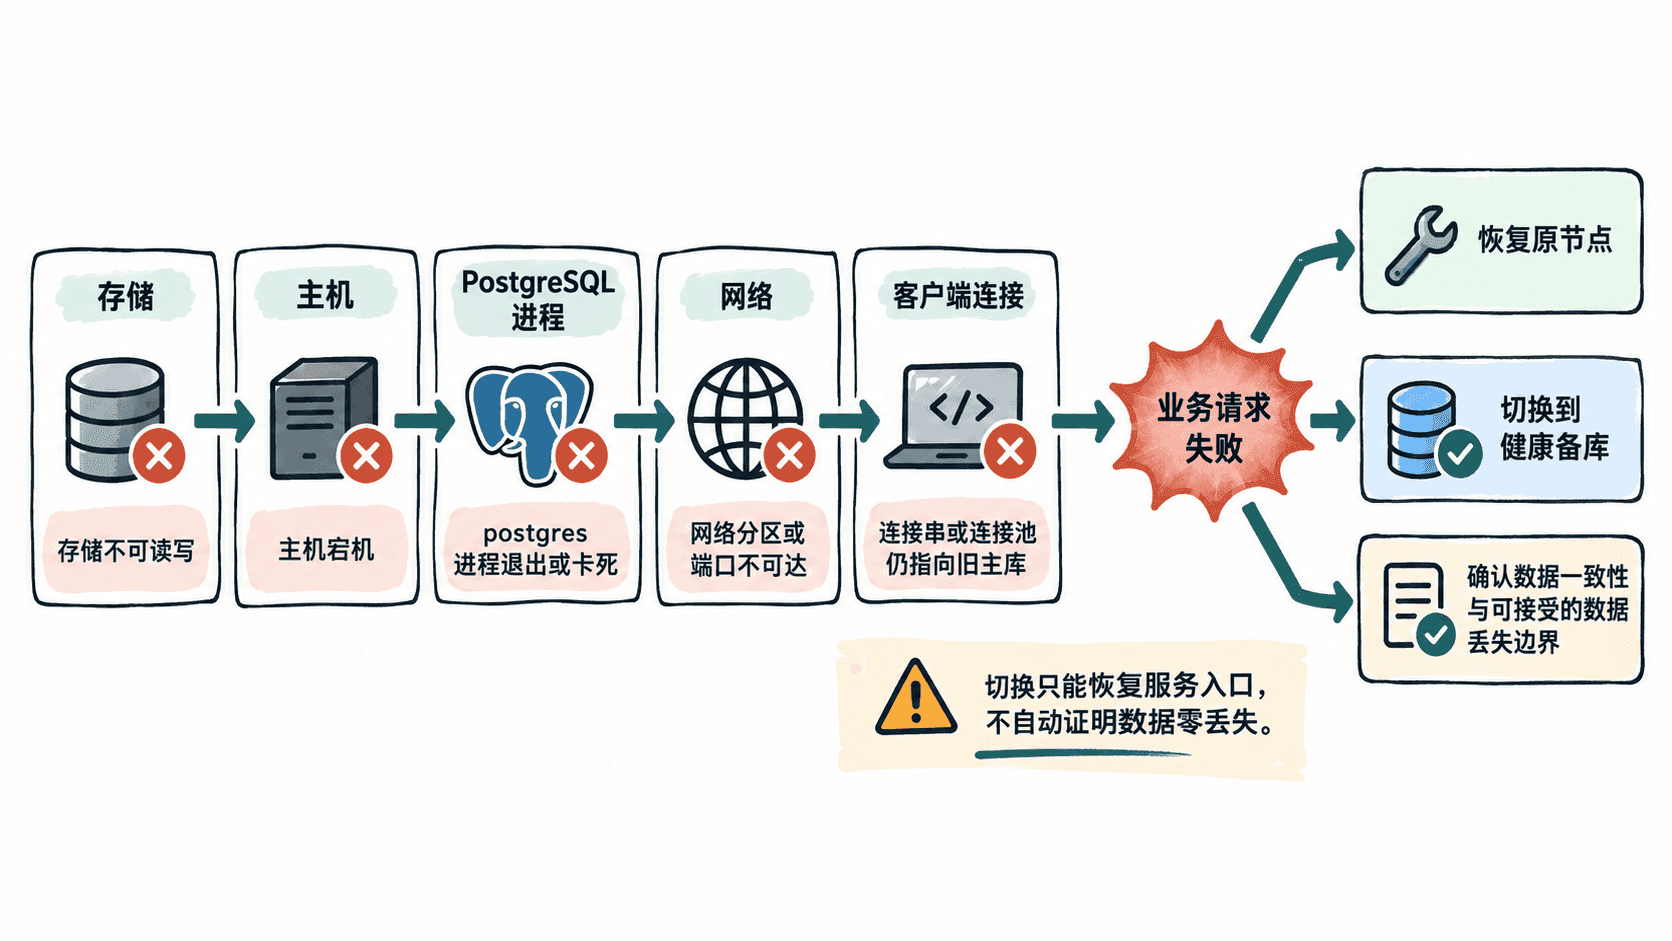
进程故障通常只影响 PostgreSQL 服务本身,主机仍可登录;主机故障则连操作系统都不可达。存储故障可能让进程仍在,却因 I/O 错误无法继续工作。网络分区更危险:主库可能健康运行,但客户端或备库看不到它,因此不能仅凭“连不上”就断言主库已经死亡。
客户端层还可能制造“假故障”。例如数据库已成功切换,但 DNS、VIP、代理或连接池仍指向旧主库,业务依然报错。此时继续操作数据库节点并不能解决问题,真正需要修复的是访问入口与连接刷新。
区分恢复、切换与一致性
恢复的目标是让原节点重新提供服务,例如重启进程、修复磁盘或恢复网络。它不改变主库身份,适合故障可在业务允许的恢复时间内修复的情况。
切换的目标是让另一台健康的备库成为新的写入节点,从而缩短不可用时间。切换前必须确认旧主库不会继续接受写入,否则两个节点同时被当作主库会形成脑裂风险。
数据一致性回答的是“新主库包含哪些已确认事务”。异步流复制允许主库提交后再由备库追赶,因此主库突然失效时,最新一段 WAL 可能尚未到达或回放到备库。同步复制可以收紧这一窗口,但可用性与提交延迟的权衡仍需单独设计。
先做最小连通性判断
故障发生后,第一步不是立即提升备库,而是确认客户端视角下 PostgreSQL 是否仍能接受连接。下面的命令可直接检查目标实例的服务可达性。
HOST="${PGHOST:-127.0.0.1}"
PORT="${PGPORT:-5432}"
pg_isready -h "$HOST" -p "$PORT"
预期输出
<HOST>:<PORT> - accepting connections<HOST> 与 <PORT> 会随实际环境变化。若结果为 no response,只能说明当前探测路径无法得到 PostgreSQL 响应,不能直接区分进程退出、主机故障、防火墙阻断还是网络分区;下一步应结合主机监控、数据库日志、网络探测和复制状态继续缩小范围。
用目标决定处置动作
如果原主库只是 PostgreSQL 进程异常且主机、存储健康,通常优先评估能否快速恢复;如果主机或存储明确失效且恢复时间不可接受,才进入故障切换流程;如果存在网络分区,则必须先建立旧主库隔离或 fencing 机制,再允许备库接管写入。
真正可执行的高可用判断顺序是:先确认故障层级,再判断原主库是否仍可能写入,然后检查候选备库的数据进度,最后才决定恢复还是切换。这样才能同时控制业务中断、脑裂和数据丢失三类风险。