
PostgreSQL / 系统课时
恢复多备库复制拓扑
恢复多备库复制拓扑
主库角色变化后,原有备库不会自动切换到新的 WAL 上游。本节按“先判定时间线是否可继续跟随,再更新连接与复制槽,最后从上下游双向验收”的顺序恢复多备库拓扑,重点区分仅需 reload 的正常分支与必须停库重建恢复关系的分叉分支。
学习目标
- 根据新的主库角色规划直连与级联备库的唯一直接上游
- 区分可直接 reload、需要受控停启和必须先
pg_rewind或重做基础备份的情况 - 从 WAL receiver、WAL sender、复制槽和 LSN 进度验证冗余能力已经恢复
先画清新的复制关系
发生主备切换后,旧拓扑已经失效。例如原主库 A 降级后可以重新跟随新主 B,备库 C 可以直接跟随 B,也可以级联跟随 A。恢复前先为每台实例确定唯一的直接上游,再为每条实际流复制链路分配独立的物理复制槽。
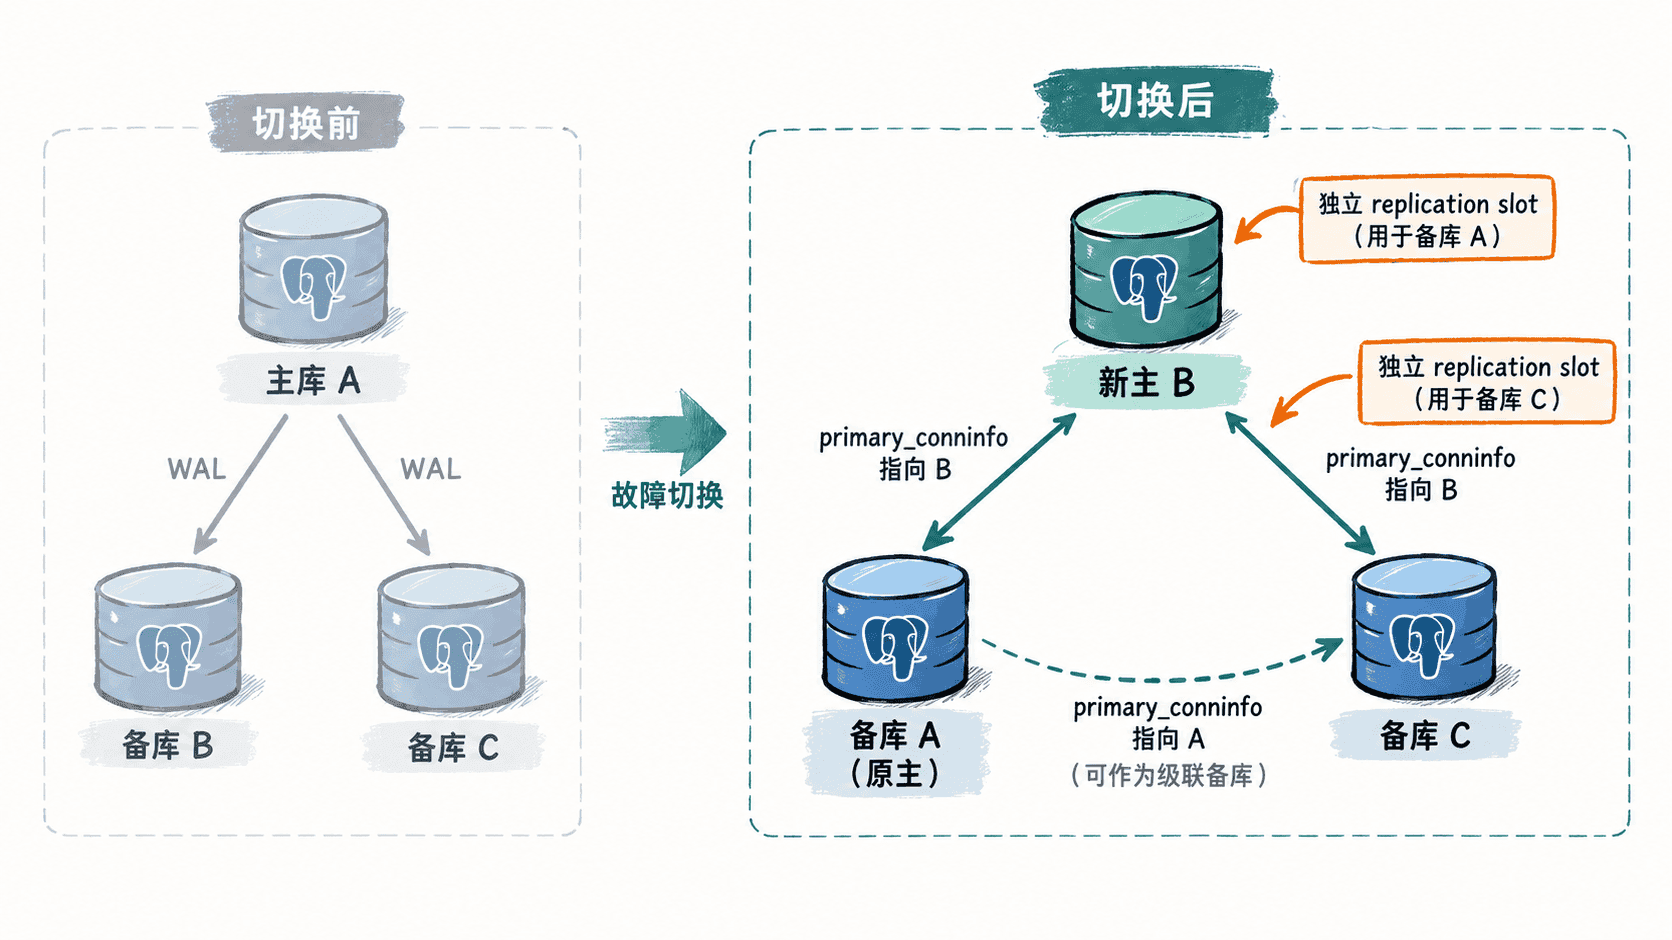
任何备库都不能继续指向已降级或不可达的旧主。多个同时工作的物理复制接收端也不应共用同一个物理槽;采用级联复制时,槽必须存在于该备库的直接 WAL 上游,而不是一律建在新主上。
建立角色与时间线硬门禁
先在待接入节点上确认当前角色、时间线和旧上游。pg_is_in_recovery() 为 t 只能证明实例仍是备库,不能证明它的数据历史一定能继续跟随新主;若它已经重放了旧主在分叉点之后产生的 WAL,同样不能只改连接参数。
SELECT pg_is_in_recovery() AS in_recovery;
SELECT timeline_id FROM pg_control_checkpoint();
SHOW primary_conninfo;
SHOW primary_slot_name;
预期结果
 in_recovery
-------------
 t
(1 row)

 timeline_id
-------------
 <VALUE>
(1 row)

 primary_conninfo
------------------
 host=<IP> port=<PORT> user=<VALUE> application_name=<VALUE>
(1 row)

 primary_slot_name
-------------------
 <VALUE>
(1 row)
实际时间线、地址和槽名会不同。时间线编号不同本身不等于发生冲突:旧时间线可能只是新主时间线的祖先。真正的门禁是当前节点是否已经包含新主分叉点之后、但不属于新主历史的 WAL。
| 当前状态 | 能否只改连接参数并 reload | 必要动作 |
|---|---|---|
| 仍是备库,且数据历史可沿新主时间线继续前进 | 可以 | 更新连接与槽后 reload,观察 WAL receiver 重连 |
| 仍是备库,但已重放旧分支的 WAL | 不可以 | 停止实例,使用 pg_rewind 或重新制作基础备份,再作为备库启动 |
原主或曾被提升,pg_is_in_recovery() 为 f |
不可以 | 先受控停库并判断是否分叉;准备 standby.signal,必要时先 rewind/重建,再启动进入恢复模式 |
更新连接、复制槽与重载
只有通过上面的时间线门禁后,才更新仍处于恢复模式的备库。下面以 C 直接跟随新主 B 为主示例:C 使用 application_name=standby_c,并绑定自己的物理复制槽 standby_c_slot。
ALTER SYSTEM SET primary_conninfo = 'host=<IP> port=<PORT> user=<VALUE> application_name=standby_c sslmode=require';
ALTER SYSTEM SET primary_slot_name = 'standby_c_slot';
SELECT pg_reload_conf();
预期结果
ALTER SYSTEM
ALTER SYSTEM
 pg_reload_conf
----------------
 t
(1 row)
对这两个参数,正常的 standby 分支应先 reload,而不是无条件重启整个实例。参数变化被加载后,运行中的 WAL receiver 会退出并按新配置重新建立连接。可继续检查参数上下文和是否存在待重启状态。
SELECT name, setting, context, pending_restart
FROM pg_settings
WHERE name IN ('primary_conninfo', 'primary_slot_name')
ORDER BY name;
预期结果
       name        | setting                                      | context | pending_restart
-------------------+----------------------------------------------+---------+----------------
 primary_conninfo  | host=<IP> port=<PORT> user=<VALUE> ...       | sighup  | f
 primary_slot_name | standby_c_slot                               | sighup  | f
(2 rows)
如果参数已经加载但 WAL receiver 仍无法建立连接,应先检查认证、网络、新上游的 pg_hba.conf、槽名和服务端日志;这些问题通常不会因为重启而消失。受控停启是“让非备库重新以 standby 身份启动”或“完成 pg_rewind、基础备份重建后重新进入恢复模式”时的必要步骤,而不是修改这两个参数后的固定动作。
为每条直连链路准备专属槽
如果使用物理复制槽,在 C 的直接上游 B 上确认 standby_c_slot 不存在后再创建;若 C 改为级联跟随 A,则同名用途的槽应创建在 A 上。
SELECT * FROM pg_create_physical_replication_slot('standby_c_slot');预期结果
    slot_name     | lsn
------------------+-----
 standby_c_slot   |
(1 row)
普通物理槽创建时 lsn 可以为空。C 成功使用该槽后,再检查活动状态。
SELECT slot_name, slot_type, active, restart_lsn
FROM pg_replication_slots
WHERE slot_name = 'standby_c_slot';
预期结果
    slot_name     | slot_type | active | restart_lsn
------------------+-----------+--------+-------------
 standby_c_slot   | physical  | t      | 0/<VALUE>
(1 row)
从两端验证拓扑和冗余
备库侧先确认 WAL receiver 已连接到预期的新上游,并且接收位置正在推进。
SELECT status, sender_host, sender_port, written_lsn, flushed_lsn
FROM pg_stat_wal_receiver;
预期结果
  status   | sender_host | sender_port | written_lsn | flushed_lsn
-----------+-------------+-------------+-------------+-------------
 streaming | <IP>        | <PORT>      | 0/<VALUE>   | 0/<VALUE>
(1 row)
再到每个直接上游检查 WAL sender。若 B 有两台直连备库,应看到两条记录;若 C 级联跟随 A,则 C 只应出现在 A 的 pg_stat_replication 中。
SELECT application_name, client_addr, state, sync_state,
       sent_lsn, write_lsn, flush_lsn, replay_lsn
FROM pg_stat_replication
ORDER BY application_name;
预期结果
 application_name | client_addr |   state   | sync_state | sent_lsn  | write_lsn | flush_lsn | replay_lsn
------------------+-------------+-----------+------------+-----------+-----------+-----------+-----------
 standby_c        | <IP>        | streaming | <VALUE>    | 0/<VALUE> | 0/<VALUE> | 0/<VALUE> | 0/<VALUE>
(1 row)
最后在备库重复观察接收与重放位置,确认它们随新 WAL 持续推进,而不是只在某一时刻显示 streaming。
SELECT pg_last_wal_receive_lsn() AS receive_lsn,
       pg_last_wal_replay_lsn() AS replay_lsn,
       pg_last_xact_replay_timestamp() AS last_replay_time;
预期结果
 receive_lsn | replay_lsn | last_replay_time
-------------+------------+------------------
 0/<VALUE>   | 0/<VALUE>  | <TIME>
(1 row)
最终应逐节点核对:实例角色符合设计,直接上游与 application_name 对得上,专属槽处于预期状态,接收与重放 LSN 持续推进;曾经位于旧分支的节点还必须先完成时间线修复。只有这些条件同时成立,多备库拓扑才真正恢复了故障切换后的冗余能力。