
PostgreSQL / 系统课时
理解 RPO 与切换数据边界
理解 RPO 与切换数据边界
主库突然不可用时,能否安全提升备库,关键不是笼统地看“复制有没有延迟”,而是确认哪些已提交事务的 WAL 已经到达并持久保存在候选备库。本课用复制模式和 WAL LSN 划定可确认恢复点与潜在数据缺口。
学习目标
- 区分异步复制与同步复制对 RPO 的实际影响
- 使用主库和备库的 WAL LSN 判断复制进度与持久化边界
- 在主库失联后准确描述可确认恢复范围和不可确认区间
RPO 本质上是在问哪些提交可能丢失
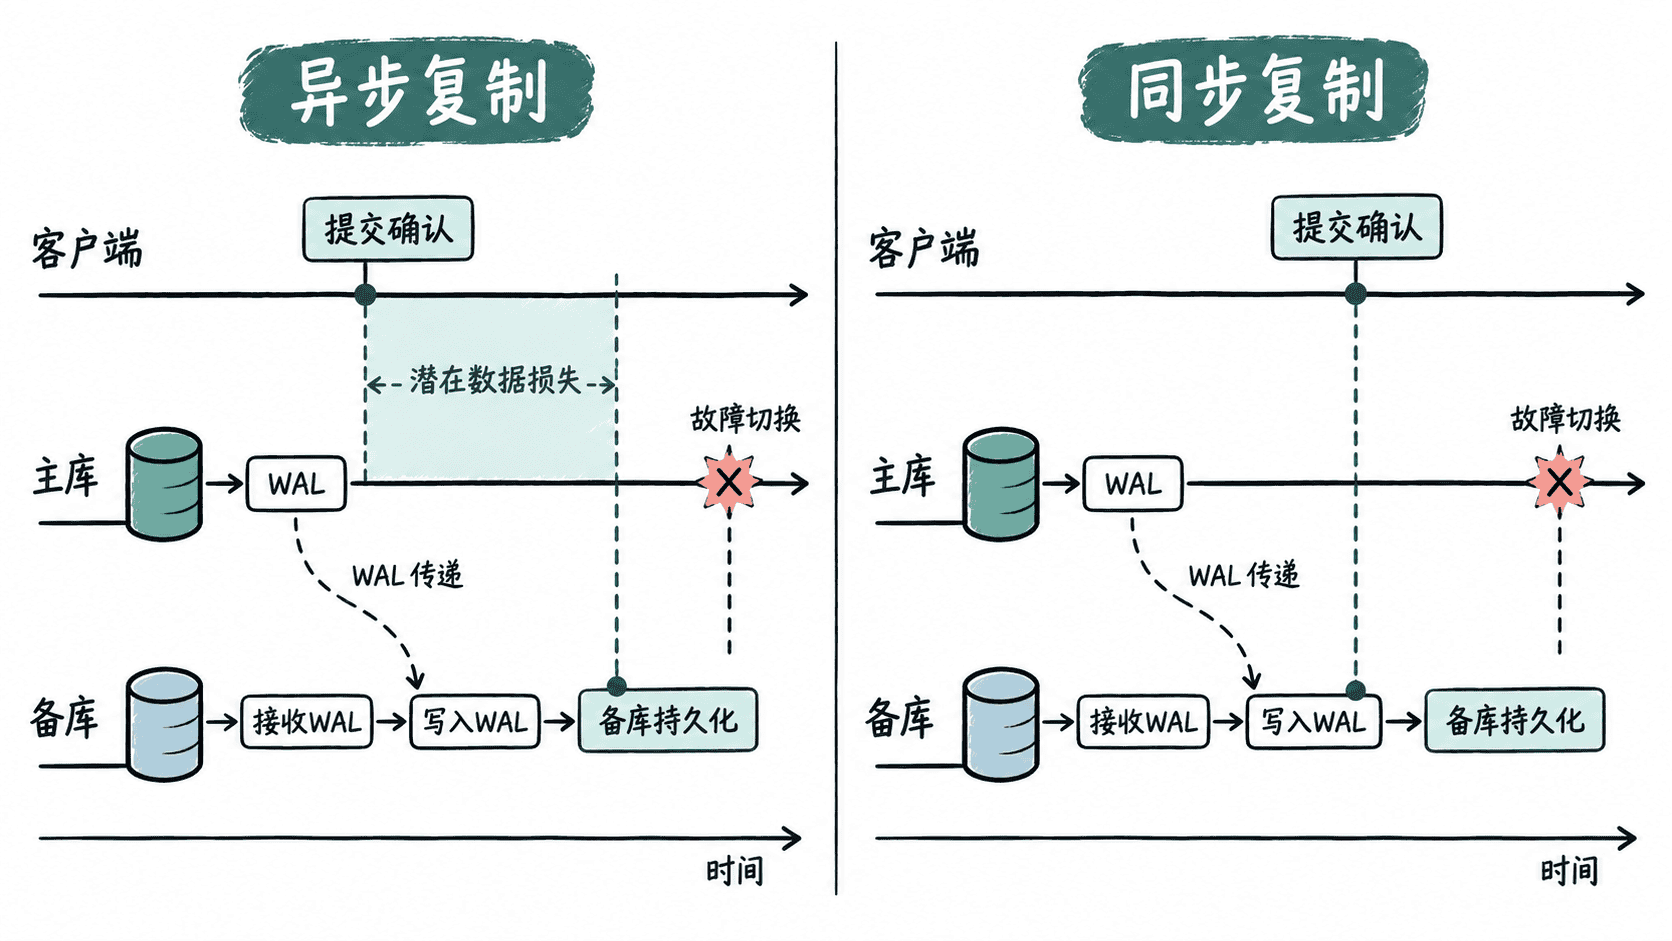
RPO(Recovery Point Objective)描述故障恢复时允许损失多少已经产生的数据。对 PostgreSQL 流复制而言,更具体的问题是:客户端收到事务提交成功时,对应 WAL 是否已经到达并持久保存到一个能够接管的备库。
异步复制中,主库提交通常不等待备库确认。客户端可能已经看到 COMMIT 成功,而最后一段 WAL 仍只存在于主库;如果主库随后永久损坏,这些事务就可能无法从备库恢复。因此异步流复制可以缩小潜在数据损失窗口,却不能从机制上保证零 RPO。
同步复制必须结合 synchronous_standby_names、备库实际同步状态和事务使用的 synchronous_commit 判断保证级别。例如 remote_write 只要求远端 PostgreSQL 已把 WAL 写入操作系统,不等同于远端持久刷盘;常规 on 会等待同步备库报告 WAL 已刷盘,remote_apply 还会继续等待回放完成。只有明确这些条件,才能讨论已确认事务是否具备零损失保证。
用 LSN 读取复制进度
在主库仍可访问时,pg_stat_replication 可以显示每个复制连接已经发送、写入、刷盘和回放到哪个 LSN。下面的主查询同时计算候选备库相对主库当前 WAL 位置的字节差。
SELECT
    application_name,
    state,
    sync_state,
    sent_lsn,
    write_lsn,
    flush_lsn,
    replay_lsn,
    pg_wal_lsn_diff(pg_current_wal_lsn(), flush_lsn) AS flush_lag_bytes,
    pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn) AS replay_lag_bytes
FROM pg_stat_replication;
预期结果
 application_name |   state   | sync_state | sent_lsn | write_lsn | flush_lsn | replay_lsn | flush_lag_bytes | replay_lag_bytes
------------------+-----------+------------+----------+-----------+-----------+------------+-----------------+-----------------
 standby1         | streaming | async      | <LSN>    | <LSN>     | <LSN>     | <LSN>      | <VALUE>         | <VALUE>
实际 LSN 和差值会随写入变化。write_lsn 表示备库报告已经写入的位置,flush_lsn 表示已经刷入持久存储的位置,replay_lsn 表示恢复进程已经回放的位置。评估候选备库已经持久拥有多少 WAL 时,应重点关注 flush_lsn;评估提升后数据已经可见到哪里时,则还需要关注 replay_lsn。
在候选备库仍处于恢复状态时,可以从备库自身核对已接收和已回放位置:
SELECT
    pg_last_wal_receive_lsn() AS receive_lsn,
    pg_last_wal_replay_lsn() AS replay_lsn,
    pg_is_in_recovery() AS in_recovery;
预期结果
 receive_lsn | replay_lsn | in_recovery
-------------+------------+-------------
 <LSN>       | <LSN>      | t
这里的实际 LSN 会因环境而不同。该结果能够证明候选备库当前掌握到哪里,却不能在旧主失联后反推出旧主最终生成到了哪里。
故障后不要伪造精确的丢失量
主库永久失联后,最常见的误判是看到候选备库的 LSN 很新,就直接宣布“没有数据丢失”。如果没有故障前保存的主库 WAL 位置、事务级业务流水或其他外部证据,通常只能确认候选备库已经拥有的数据,无法确认旧主最后还成功提交了多少尚未复制出去的事务。
因此切换结论应明确区分两个边界:一是候选备库可确认恢复到的 LSN;二是从该位置到旧主未知最终 WAL 末端之间的不可确认区间。异步复制下,这段未知范围必须按潜在数据损失处理,而不能因为观测不到就视为零。
把 RPO 转成可执行的切换门槛
生产环境应在故障发生前定义候选备库资格,例如要求复制连接处于正常状态、WAL 接收持续推进,并设置允许的 WAL 字节差或业务时间窗口。对不能接受已确认事务丢失的写路径,则应使用同步复制,并明确同步备库数量、synchronous_commit 级别以及同步备库不可用时业务是等待还是降级。
切换时能够可靠声明的是“候选备库已确认持有并可恢复到哪个位置”。异步模式下,旧主已提交但尚未传到候选备库的事务在永久故障后可能丢失;没有足够证据时,不应宣称零数据损失,而应把不可确认区间明确记录为 RPO 风险边界。