
Linux 与服务器运维 / 系统课时
排查 CPU 使用率过高
排查 CPU 使用率过高
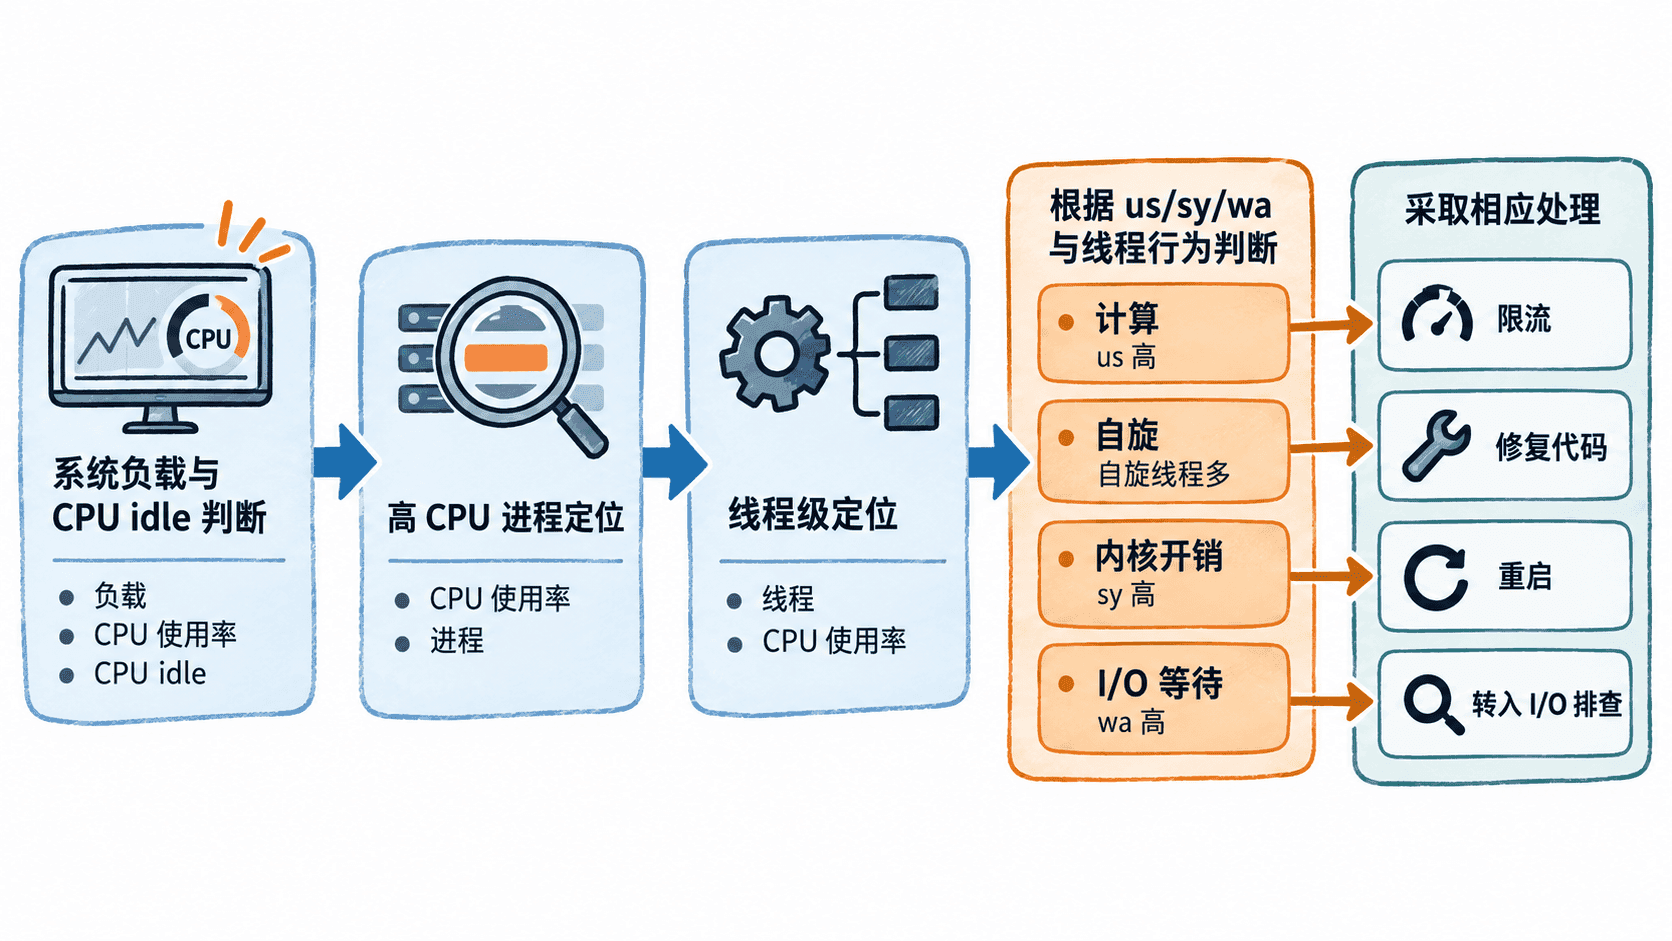
CPU 异常排查的目标不是先杀进程,而是确认系统是否真的处于 CPU 压力,再定位到进程与线程,并判断是持续计算、异常自旋还是短时峰值。本节给出一条可重复执行的最短排查链路。
学习目标
- 用负载、CPU 核数和利用率判断是否存在持续 CPU 压力
- 从系统级指标定位到高占用进程,再下钻到线程
- 根据现象选择限流、重启、优化代码或继续观察
先确认系统是否真的忙
先看逻辑 CPU 数量与最近 1、5、15 分钟的负载。负载表示正在运行或等待不可中断资源的任务数量,不能简单等同于 CPU 百分比;只有结合 CPU 核数和后续指标,才能判断是否过载。
nproc
uptime
top -b -n 1 | head -n 12
预期输出
<VALUE>
<TIME> up <VALUE>,  <VALUE> users,  load average: <VALUE>, <VALUE>, <VALUE>
top - <TIME> up <VALUE>,  <VALUE> users,  load average: <VALUE>, <VALUE>, <VALUE>
Tasks: <VALUE> total, <VALUE> running, <VALUE> sleeping, <VALUE> stopped, <VALUE> zombie
%Cpu(s): <VALUE> us, <VALUE> sy, <VALUE> ni, <VALUE> id, <VALUE> wa, <VALUE> hi, <VALUE> si, <VALUE> st
nproc 的实际结果取决于机器配置。若负载长期明显高于 CPU 核数,并且 id 持续很低,通常说明 CPU 已接近饱和;若 wa 很高,则应转向 I/O 排查,而不是把问题归因于纯 CPU 计算。
找到最耗 CPU 的进程
确认 CPU 压力后,再按 CPU 占用排序进程。不要只看某一瞬间的峰值,最好连续观察几次;如果同一进程持续位于前列,才值得继续下钻。
ps -eo pid,ppid,comm,%cpu,%mem,stat --sort=-%cpu | head -n 10预期输出
    PID    PPID COMMAND         %CPU %MEM STAT
   <PID>   <PID> <VALUE>       <VALUE> <VALUE> <VALUE>
   <PID>   <PID> <VALUE>       <VALUE> <VALUE> <VALUE>
%CPU 是采样与统计口径下的占用值,多核机器上单个进程可能超过 100%。同时观察 STAT:持续处于运行态的进程更可能正在消耗 CPU,而处于不可中断睡眠态的任务通常需要结合 I/O 指标分析。
下钻到线程判断行为
多线程程序可能只有少数线程异常。下面先自动选择当前 CPU 占用最高的进程,再按线程 CPU 排序,便于判断是否是单线程打满一个核心,或多个线程同时消耗 CPU。
PID=$(ps -eo pid,%cpu --sort=-%cpu | awk 'NR==2 {print $1}')
echo "PID=$PID"
ps -L -p "$PID" -o pid,tid,psr,pcpu,stat,comm --sort=-pcpu | head -n 12
预期输出
PID=<PID>
    PID     TID PSR %CPU STAT COMMAND
   <PID>   <ID> <VALUE> <VALUE> <VALUE> <VALUE>
   <PID>   <ID> <VALUE> <VALUE> <VALUE> <VALUE>
如果一个线程长期接近单核上限,常见原因是死循环、忙等、自旋或单线程热点计算;多个线程同时升高,则更可能是并行任务、请求洪峰或批处理。还应结合应用日志、性能剖析工具和业务时间点确认根因,避免只凭线程名下结论。
采取动作并验证
紧急止损可以先限流、降低并发或把异常实例摘出流量;确认进程可安全重启时再重启。生产环境不要把 kill -9 当作默认手段,因为它不给进程清理资源和落盘的机会。
处理后再次执行 uptime、top 和进程排序命令。负载会有滞后,重点观察 CPU id 是否恢复、异常进程是否下降,以及业务延迟和错误率是否同步回落。只有系统指标与业务指标都恢复,才能认为这次 CPU 故障真正闭环。