
Linux 与服务器运维 / 系统课时
安全执行系统更新
安全执行系统更新
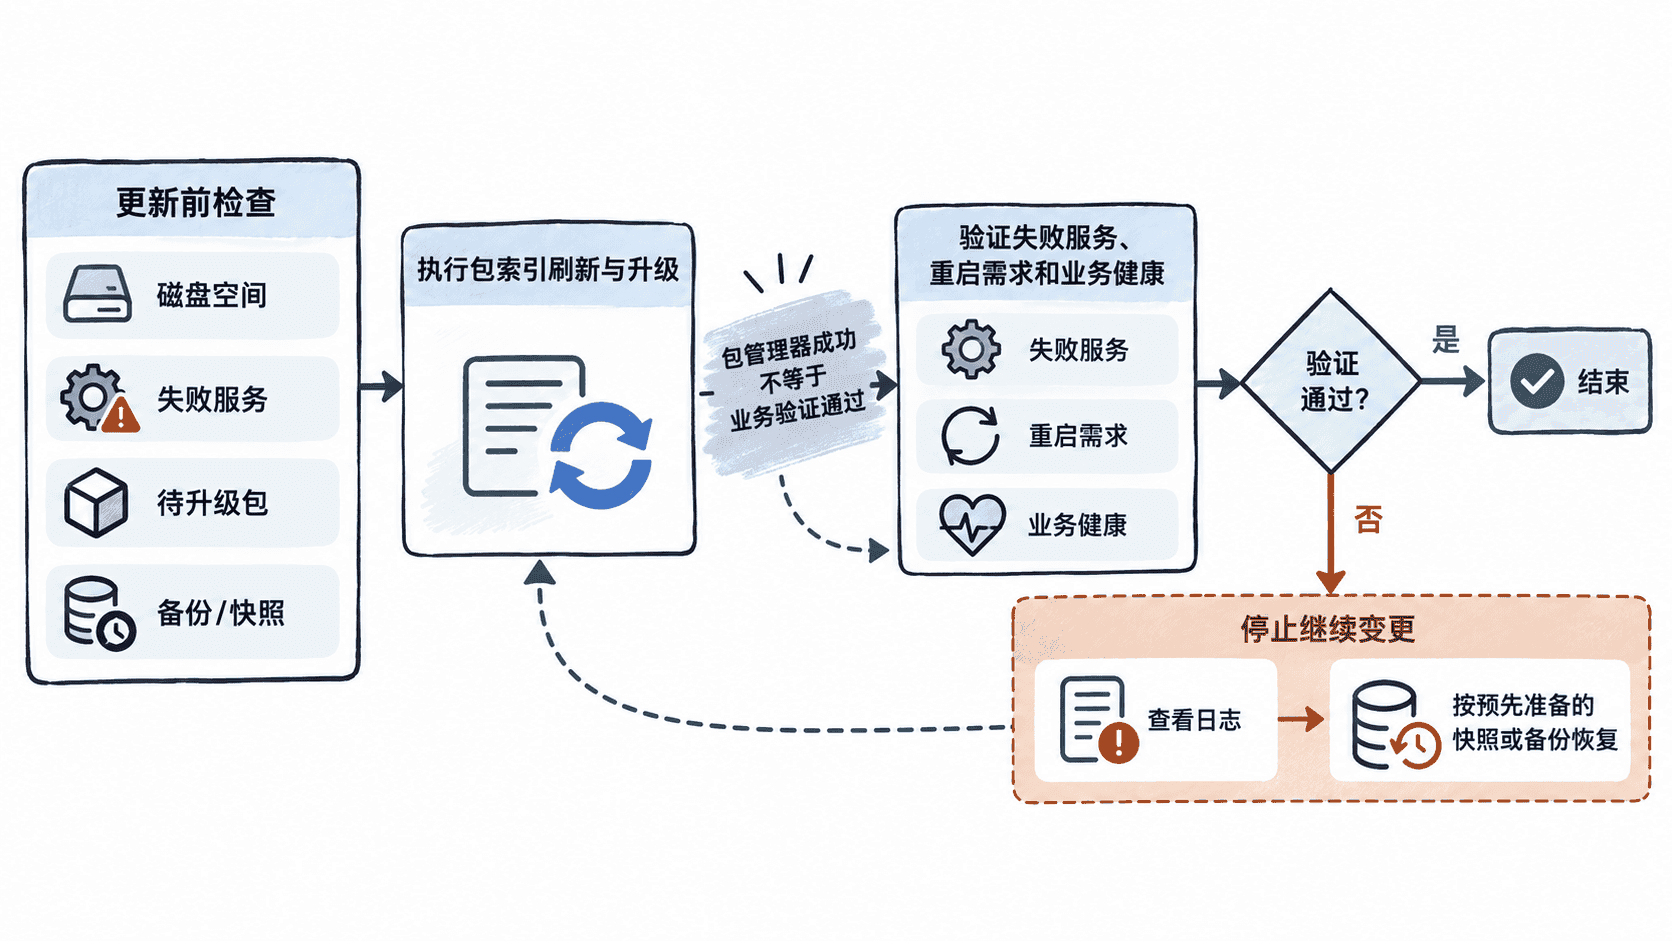
系统更新真正需要控制的不是一条升级命令,而是更新前确认风险、执行升级、验证关键状态,以及在异常时有可用的恢复路径。本节以 Debian/Ubuntu 的 APT 为例,建立一套可重复的最小安全流程。
学习目标
- 在升级前检查磁盘、失败服务和待更新范围。
- 按“预检—升级—验证”顺序执行系统更新。
- 理解系统更新无法通用一键回滚,提前准备快照或备份。
先把更新当成一次变更
生产主机不应直接从 sudo apt upgrade 开始。更新可能替换共享库、内核和系统服务,即使包管理器成功退出,业务进程也可能需要重启,新的配置也可能改变行为。
更新前至少确认三件事:根分区有足够空间、当前没有已知失败服务、待升级包列表符合预期。对关键服务器,还应先确认可用备份、虚拟机快照或文件系统快照,并记录业务健康基线。
执行一次可审查的 APT 更新
下面的主示例先刷新索引并模拟升级,再真正安装更新,最后输出几个可核对的状态。适用于使用 APT 的 Debian/Ubuntu;其他发行版应使用各自包管理器执行同样的流程思想。
set -euo pipefail
export LC_ALL=C

echo "== precheck =="
df -Pk / | awk 'NR==2 {print "root-free-kb=" $4}'
failed_before="$(systemctl --failed --no-legend --plain | wc -l)"
printf 'failed-before=%s\n' "$failed_before"

echo "== plan =="
sudo apt-get update >/dev/null
apt-get -s upgrade | grep -E '^[0-9]+ upgraded,' | tail -n 1

echo "== upgrade =="
sudo apt-get upgrade -y >/dev/null
echo "upgrade-command=ok"

echo "== verify =="
failed_after="$(systemctl --failed --no-legend --plain | wc -l)"
printf 'failed-after=%s\n' "$failed_after"

if [ -f /var/run/reboot-required ]; then
  echo "reboot-required=yes"
else
  echo "reboot-required=no"
fi
预期输出
== precheck ==
root-free-kb=<VALUE>
failed-before=<VALUE>
== plan ==
<VALUE> upgraded, <VALUE> newly installed, <VALUE> to remove and <VALUE> not upgraded.
== upgrade ==
upgrade-command=ok
== verify ==
failed-after=<VALUE>
reboot-required=yes|no
<VALUE> 会随主机状态变化。真正执行前应先阅读模拟升级的完整输出;示例用 -y 是为了形成可复现流程,关键服务器应在确认变更窗口和升级计划后再自动确认。
验证不能只看退出码
升级完成后,先比较更新前后的失败服务数量,再检查业务自身的健康指标、端口、接口或日志。若存在 /var/run/reboot-required,说明至少有组件建议通过重启加载新版本;是否立即重启应服从维护窗口和高可用策略。
如果更新后出现异常,应先停止继续安装更多包,保留 journalctl、应用日志和 /var/log/apt/ 中的变更证据,再决定修复还是恢复。
把回滚能力放在升级之前
APT 本身不是事务型系统快照工具,不能保证把整台主机“一键回到更新前”。单个包有时可以降级,但依赖关系、配置迁移和数据库格式变化可能让简单降级不可靠。
因此,关键系统应在更新前准备真正可恢复的手段,例如虚拟机快照、LVM/Btrfs/ZFS 快照、系统备份或可重新部署的镜像。只有在恢复路径经过验证后,升级流程才算完整;否则所谓“回滚”只是希望旧包还能装回去。