
Linux 与服务器运维 / 系统课时
建立分层排障思路
建立分层排障思路
排障最容易失败的地方,不是命令不会用,而是没有先缩小问题范围。本节用“现象、范围、时间、变更、依赖”五个维度组织证据,让你从模糊的“系统坏了”逐步得到可验证的故障假设。
学习目标
- 能把模糊故障描述改写成可验证的现象与范围
- 能按时间、最近变更和依赖关系逐层缩小根因
- 能用少量 Linux 命令建立一条可复查的证据链
先把“坏了”改写成可验证现象
不要从“可能是网络”“可能是 CPU”开始猜。先写清楚谁遇到什么问题、从什么时候开始、是否稳定复现、错误是什么。例如“网站打不开”应改成“本机访问 http://127.0.0.1/ 在 3 秒内失败,外部客户端也失败,故障从 <TIME> 左右开始”。
这一步的目标不是找根因,而是给后续检查设定边界。只有现象能复现,修复后的验证才有明确标准。
沿五个维度缩小范围
排障时可以按固定顺序提问:现象是否真实、影响范围有多大、故障从何时开始、时间点附近发生了什么变更、当前链路依赖哪些组件。每回答一次,就排除一批不相关方向。
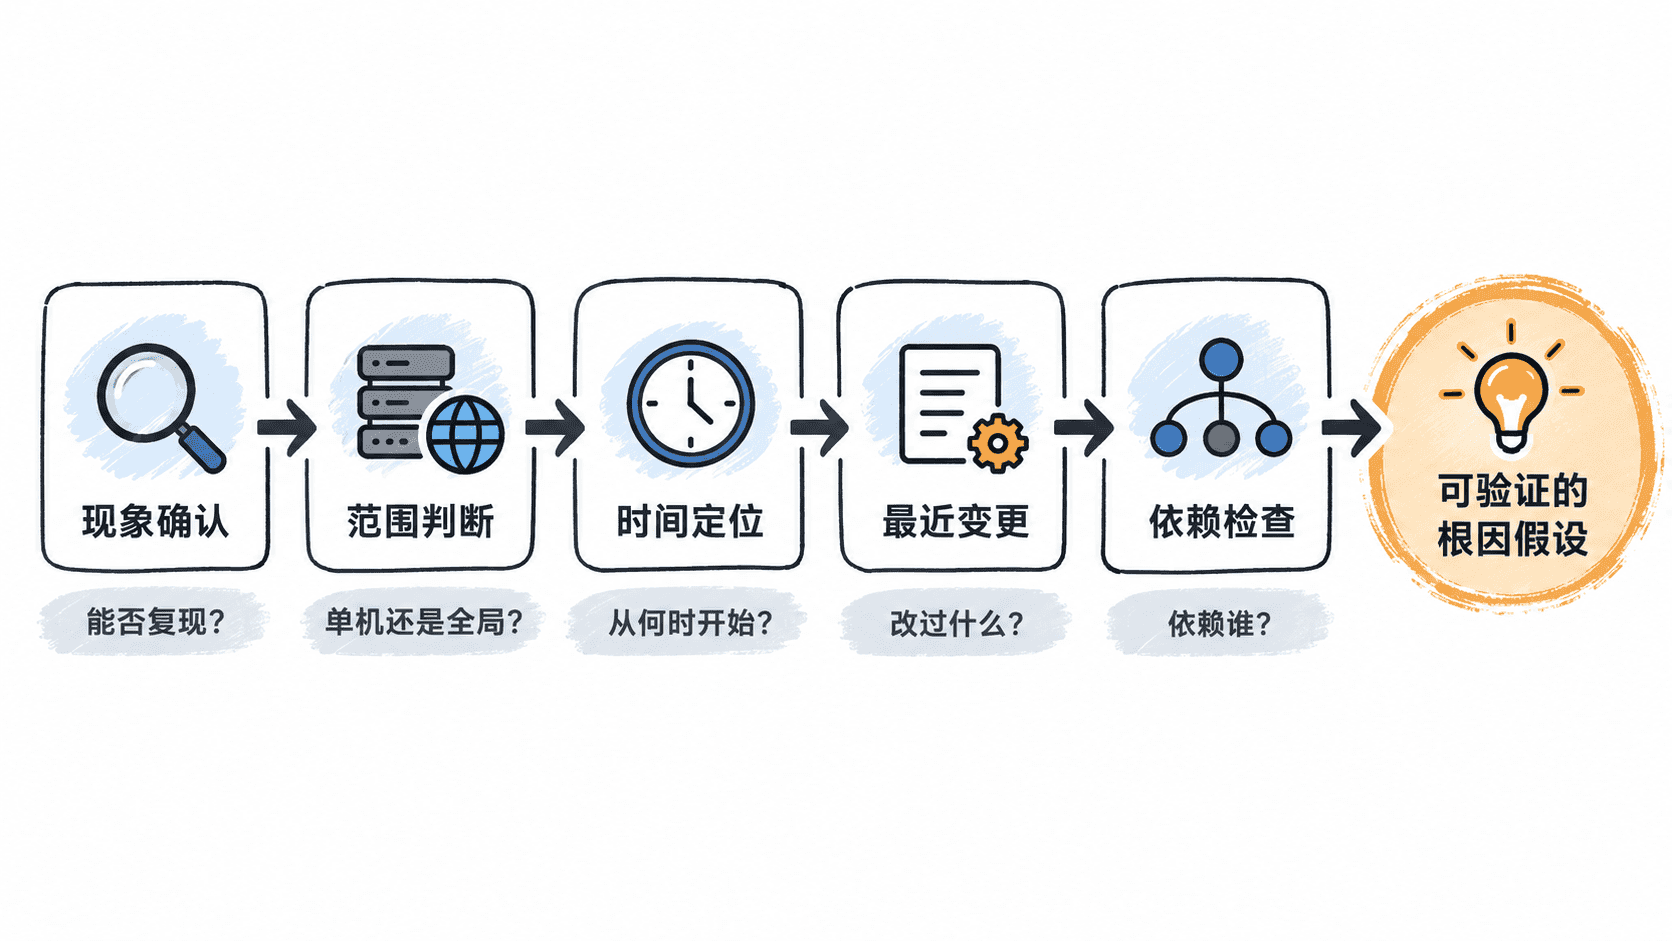
范围判断尤其重要。只有单个用户失败,优先看客户端、账号或局部配置;单台主机失败,优先看主机资源、进程和本机配置;多台主机同时失败,则应优先检查共享依赖、网络入口、发布变更或上游服务。
用最小证据链验证判断
假设主机已经安装 Nginx,并由 systemd 管理。下面用四个检查把“访问失败”拆成请求结果、服务状态和监听端口三个证据点。
SERVICE=nginx
date '+time=%F %T'
curl -sS -o /dev/null -w 'http=%{http_code}\n' --max-time 3 http://127.0.0.1/ || true
systemctl is-active "$SERVICE"
ss -lnt | grep ':80 ' || true
预期输出(服务健康时):
time=<TIME>
http=200
active
LISTEN <VALUE> <VALUE> <IP>:80 <IP>:*
实际时间和地址会不同。如果 HTTP 失败但服务为 active,继续检查监听地址、端口、应用日志和配置;如果服务已经 inactive 或 failed,则先转向启动失败原因,而不是继续排查客户端。
把时间、变更和依赖串起来
找到故障开始时间后,先问这个时间点前后是否发生过发布、配置修改、证书替换、内核或软件包升级、重启、扩缩容等变更。相关性不等于因果,但“故障开始时间”和“变更完成时间”高度接近时,应优先验证该变更能否解释现象。
依赖检查则从离故障点最近的组件开始向外扩展。Web 服务访问异常时,可以依次确认本地进程、监听端口、反向代理、DNS、数据库或外部 API,不要一上来就跨越多层检查最远端。
留下能复查的排障记录
一次有效排障至少留下现象、时间、影响范围、关键证据、已验证假设、采取动作和验证结果。记录的价值在于让下一个人能够沿着同一条证据链复现判断,而不是只看到一句“重启后恢复”。
当证据与假设不一致时,应回到上一个可靠事实重新缩小范围,而不是为了维护最初猜测继续堆命令。分层排障的核心,就是让每一步检查都能明确决定下一步往哪里走。