
编码与格式 / 系统课时
设计并发转码策略
设计并发转码策略
本课将把单任务测试结果转换为可执行的并发方案:先计算 CPU、GPU、内存和磁盘分别允许的任务数,再以最小值作为初始并发上限,并通过任务队列、GPU 槽位和独立日志实现资源隔离与稳定调度。
学习目标
- 根据实测资源消耗计算安全并发上限
- 设计任务队列、GPU 槽位和失败隔离机制
- 通过压力测试验证吞吐、等待时间与系统稳定性
用资源瓶颈计算并发上限
并发数不能只按 CPU 核数或 GPU 数量估算。对每种转码模板先测出单任务平均占用,再分别计算各资源允许的任务数,最终取最小值:
其中,C 表示可用 CPU 核心或配额,G 表示可用硬件编码会话槽位,M 表示可分配内存,D 表示磁盘安全吞吐。生产环境不要把资源用满,通常应为系统、监控、文件缓存和突发任务预留 15%~30% 余量。
例如,一台机器按安全余量后可用 12 个 CPU 核心、24 GB 内存、600 MB/s 磁盘吞吐和 4 个 GPU 会话槽位。若单任务分别需要 3 核、4 GB、120 MB/s 和 1 个 GPU 槽位,则四项上限为 4、6、5、4,初始并发数应设为 4。
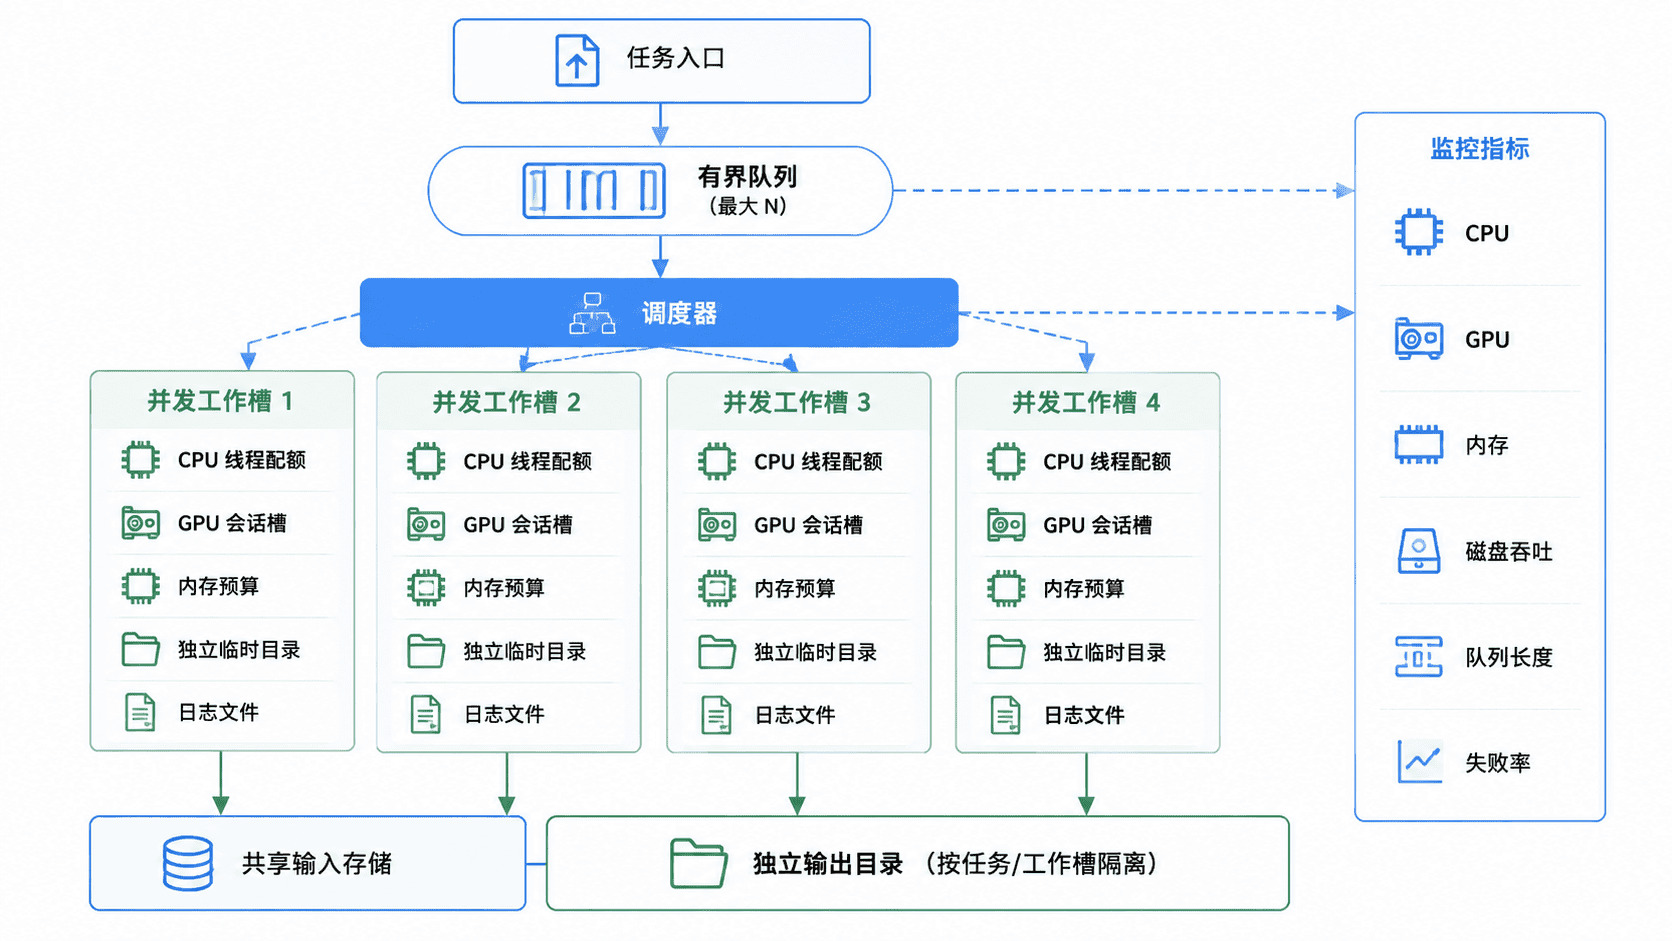
划分任务队列和资源槽位
调度层应维护一个有界队列,避免短时间大量提交把内存和磁盘打满。CPU 转码任务通过 -threads 限制单任务线程数;GPU 转码任务通过设备编号和每卡槽位数限制并发会话。每个任务使用独立输出文件、临时目录和日志,失败时只重试当前任务。
不同模板不要默认共享同一个并发池。4K 缩放、降噪、字幕烧录和纯编码的资源模型差异很大,适合按“模板或资源等级”划分队列,例如 cpu-heavy、gpu-light 和 io-heavy,分别设置并发上限。
实现一个最小并发调度器
下面的 Python 程序支持 CPU 与 NVIDIA GPU 两种模式。GPU 模式会把 GPU ID × 每卡槽位数 展开成可用槽位,任务开始时领取槽位,结束后归还,因此不会出现多个工作线程无限争用同一张卡。
将代码保存为 transcode_pool.py。程序要求 Python 3.10 及以上,并确保 ffmpeg 已加入 PATH。
from __future__ import annotations

import argparse
import queue
import subprocess
import threading
from concurrent.futures import ThreadPoolExecutor, as_completed
from pathlib import Path

def build_command(
    input_path: Path,
    output_path: Path,
    mode: str,
    gpu_id: str | None,
    cpu_threads: int,
) -> list[str]:
    base = [
        "ffmpeg",
        "-y",
        "-v",
        "warning",
        "-i",
        str(input_path),
        "-map",
        "0:v:0",
        "-map",
        "0:a?",
    ]

    if mode == "gpu":
        # 每个任务显式绑定 GPU,避免调度结果依赖驱动的隐式选择。
        video_args = [
            "-c:v",
            "h264_nvenc",
            "-gpu",
            str(gpu_id),
            "-preset",
            "p4",
            "-cq",
            "23",
            "-b:v",
            "0",
        ]
    else:
        video_args = [
            "-c:v",
            "libx264",
            "-preset",
            "veryfast",
            "-crf",
            "23",
            "-threads",
            str(cpu_threads),
        ]

    return base + video_args + ["-c:a", "aac", "-b:a", "128k", str(output_path)]

def transcode_one(
    input_path: Path,
    output_dir: Path,
    mode: str,
    gpu_slots: queue.Queue[str] | None,
    cpu_threads: int,
) -> tuple[Path, bool, str]:
    gpu_id: str | None = None
    if gpu_slots is not None:
        gpu_id = gpu_slots.get()

    try:
        output_path = output_dir / f"{input_path.stem}.mp4"
        log_path = output_dir / f"{input_path.stem}.log"
        command = build_command(input_path, output_path, mode, gpu_id, cpu_threads)

        # 不使用 shell=True,避免文件名被解释为额外命令。
        result = subprocess.run(
            command,
            stdout=subprocess.DEVNULL,
            stderr=subprocess.PIPE,
            text=True,
            check=False,
        )
        log_path.write_text(result.stderr, encoding="utf-8")
        return input_path, result.returncode == 0, str(log_path)
    finally:
        if gpu_slots is not None and gpu_id is not None:
            gpu_slots.put(gpu_id)

def main() -> int:
    parser = argparse.ArgumentParser(description="Bounded FFmpeg transcode pool")
    parser.add_argument("inputs", nargs="+", type=Path)
    parser.add_argument("--mode", choices=("cpu", "gpu"), default="cpu")
    parser.add_argument("--workers", type=int, default=2)
    parser.add_argument("--cpu-threads", type=int, default=2)
    parser.add_argument("--gpu-ids", default="0")
    parser.add_argument("--slots-per-gpu", type=int, default=1)
    parser.add_argument("--output-dir", type=Path, default=Path("output"))
    args = parser.parse_args()

    if args.workers < 1 or args.cpu_threads < 1 or args.slots_per_gpu < 1:
        raise ValueError("workers, cpu-threads and slots-per-gpu must be positive")

    args.output_dir.mkdir(parents=True, exist_ok=True)
    missing = [path for path in args.inputs if not path.is_file()]
    if missing:
        raise FileNotFoundError(f"missing inputs: {missing}")

    gpu_slots: queue.Queue[str] | None = None
    worker_count = args.workers

    if args.mode == "gpu":
        ids = [item.strip() for item in args.gpu_ids.split(",") if item.strip()]
        if not ids:
            raise ValueError("GPU mode requires at least one GPU ID")

        gpu_slots = queue.Queue()
        for gpu_id in ids:
            for _ in range(args.slots_per_gpu):
                gpu_slots.put(gpu_id)

        # 工作者数量不能超过实际 GPU 会话槽位。
        worker_count = min(worker_count, gpu_slots.qsize())

    print(f"start mode={args.mode} workers={worker_count}")
    failures = 0
    lock = threading.Lock()

    with ThreadPoolExecutor(max_workers=worker_count) as executor:
        futures = [
            executor.submit(
                transcode_one,
                input_path,
                args.output_dir,
                args.mode,
                gpu_slots,
                args.cpu_threads,
            )
            for input_path in args.inputs
        ]

        for future in as_completed(futures):
            input_path, success, log_path = future.result()
            with lock:
                print(f"{'ok' if success else 'failed'} input={input_path} log={log_path}")
            failures += 0 if success else 1

    print(f"finished total={len(args.inputs)} failed={failures}")
    return 1 if failures else 0

if __name__ == "__main__":
    raise SystemExit(main())
预期结果:源码保存后不会自动执行;运行时会创建输出目录,为每个输入生成一个 MP4 文件和独立日志,并以进程退出码汇总成功或失败。
CPU 模式示例把总并发限制为 3,每个任务最多使用 2 个编码线程:
python3 transcode_pool.py --mode cpu --workers 3 --cpu-threads 2 --output-dir output input-01.mp4 input-02.mp4 input-03.mp4预期输出格式如下,任务完成顺序可能不同:
start mode=cpu workers=3
ok input=input-01.mp4 log=output/input-01.log
ok input=input-02.mp4 log=output/input-02.log
ok input=input-03.mp4 log=output/input-03.log
finished total=3 failed=0
双 GPU 示例为每张卡分配 2 个会话槽位,但总工作者仍限制为 4:
python3 transcode_pool.py --mode gpu --workers 4 --gpu-ids 0,1 --slots-per-gpu 2 --output-dir output input-01.mp4 input-02.mp4 input-03.mp4 input-04.mp4预期输出格式如下,任务完成顺序可能不同:
start mode=gpu workers=4
ok input=input-<ID>.mp4 log=output/input-<ID>.log
ok input=input-<ID>.mp4 log=output/input-<ID>.log
ok input=input-<ID>.mp4 log=output/input-<ID>.log
ok input=input-<ID>.mp4 log=output/input-<ID>.log
finished total=4 failed=0
验证并发策略
从计算值开始压测,不要直接使用理论最大值。逐级增加并发,观察 15~30 分钟稳定阶段的 CPU、GPU 编码器利用率、显存、可用内存、磁盘吞吐、I/O 等待、队列长度、失败率和单任务耗时。
当并发增加后总吞吐不再明显上升,或单任务耗时、I/O 等待和失败率快速增长,就已经越过有效容量。此时应回退一个档位,并为生产峰值保留余量。若瓶颈来自缩放或滤镜,应优化处理链路,而不是继续增加编码会话。
隔离与恢复边界
任务隔离至少包括独立日志、唯一输出路径、临时文件目录和超时控制。输出应先写临时文件,成功后再原子重命名,避免失败任务留下看似完整的成品。
重试只适合瞬时故障,并应设置次数上限和退避间隔。输入损坏、参数非法或编码器不支持属于确定性失败,重复执行只会浪费资源,应直接进入失败队列等待人工处理。