
P2P 与分布式存储 / 系统课时
根据测试结果写出存储架构选型报告
根据测试结果写出存储架构选型报告
选型报告要让别人凭同一批证据复核你的决定:先锁定负载、一致性与故障门槛,再比较容量和故障注入结果,最后写明数据放置、恢复动作与重新评估条件。下面用一组明确标为教学示例的数据完成整份决策。
学习目标
- 把业务需求改写为可测量、可否决的验收条件。
- 按统一口径比较三副本、冷热混合纠删码与去中心化存储。
- 写出包含选型理由、实施规则和复验条件的架构决策记录。
把需求写成硬性门槛
假设对象存储当前有 200 TiB 逻辑数据,热数据 60 TiB、冷数据 140 TiB,冷数据每月净增长 5 TiB。三个可用区合计原始磁盘 600 TiB,每个可用区 200 TiB;先预留 20% 供故障恢复和容量波动,不能把预留空间算进可销售容量。
| 维度 | 示例负载与验收门槛 |
|---|---|
| 请求 | 稳态 1000 次/秒;GET 90%,PUT 10%;热区承接 80% 的请求 |
| 对象大小 | 中位数 64 KiB,P95 为 4 MiB;压测按实际大小分布采样 |
| 正常延迟 | 热读 P99 ≤100 ms,冷读 P99 ≤250 ms,PUT P99 ≤150 ms |
| 故障 | 任一可用区整体离线后,120 秒内恢复读取;冗余修复 ≤12 小时;新写入未达持久化条件时必须拒绝确认 |
| 数据正确性 | 已确认写入在单可用区故障下不丢失;版本化条件覆盖必须拒绝旧版本 |
| 容量 | 算上冗余后 ≤480 TiB,并保留容量增长空间 |
“读服务恢复”和“修复完成”不能混写:前者测 GET 何时重新成功,后者测冗余何时补足。报告还应记录故障期间的降级读 P99(本例上限 300 ms),并单独统计拒绝的 PUT,绝不把未持久化写入伪装成成功。
固定测试口径与证据
候选方案为 A(全部三副本)、B(热区三副本+冷区 RS(4,2))与 C(IPFS 配三个独立固定副本)。比较前必须固定磁盘类型、三可用区网络、数据集、并发量、对象大小分布和故障注入位置。C 的内容寻址读取与原地条件覆盖语义不同,不能将“成功获取 CID”冒充“版本化 PUT 成功”。
- 每轮预热 10 分钟,维持 1000 次/秒负载采样 30 分钟;共跑 3 轮,报告最差一轮的 P99,而非只挑最好结果。
- 在持续流量下隔离一个可用区,记录 GET 失败区间、读服务恢复时刻、PUT 拒绝数和后台补片完成时刻。
- 按对象版本与校验摘要逐一核对故障前已确认的 PUT,记录丢失数、旧版本覆盖数和校验失败数。
- 保留压测原始 CSV、节点与网络指标、部署版本、数据放置快照、故障注入时间线;指标截图不能替代原始记录。
例如报告的证据索引可写为 latency-run-03.csv、fault-az-01.csv 和部署提交号;这些名称只是填写示例,并不代表文件已经生成。每项结论都要能追溯到某次测试、某个对象版本和对应的测量窗口。
用脚本复核容量账
三副本的数据倍率是 3;RS(4,2) 将 4 片数据编码成 6 片,理想倍率为 1.5。按热区与冷区分别计算,不能拿全库平均请求量代替冷热分布。以下脚本适用于 Python 3,无需第三方依赖。
hot_tib = 60
cold_tib = 140
raw_tib = 600
reserve_ratio = 0.20

# 可用预算先扣除故障恢复预留
budget = raw_tib * (1 - reserve_ratio)
all_replica = (hot_tib + cold_tib) * 3
hybrid = hot_tib * 3 + cold_tib * (6 / 4)

# 纠删码倍率仅计编码数据,不含元数据和条带填充
print(f"容量预算: {budget:.0f} TiB")
print(f"全三副本: {all_replica:.0f} TiB / {'通过' if all_replica <= budget else '超限'}")
print(f"冷热混合: {hybrid:.0f} TiB / 剩余 {budget - hybrid:.0f} TiB")
预期输出:
容量预算: 480 TiB
全三副本: 600 TiB / 超限
冷热混合: 390 TiB / 剩余 90 TiB
B 在均匀放置时每个可用区约使用 130 TiB,而该区扣除预留后的预算为 160 TiB。390 TiB 是理论编码占用,不包括小对象条带填充、索引、日志与迁移期双写空间;正式报告必须用真实磁盘用量校准,并确认最满可用区仍有余量。
按门槛筛选候选方案
下表是为演示报告写法而设定的教学示例测量值,不是产品基准或实际实验结果。延迟取三轮最差 P99,修复时间从故障发生算到冗余恢复达标。
| 候选 | 物理占用 | 热/冷读 P99 | PUT P99 | 单区读恢复 | 冗余修复 |
|---|---|---|---|---|---|
| A:全三副本 | 600 TiB | 65/110 ms | 95 ms | 32 秒 | 5.2 小时 |
| B:冷热混合 | 390 TiB | 72/190 ms | 110 ms | 48 秒 | 8.4 小时 |
| C:IPFS+三处 Pin | 约 600 TiB | 280/430 ms | 无等价条件覆盖 | 390 秒 | 未定义保障 |
先过硬门槛:A 虽然延迟与恢复达标,但超出 480 TiB 预算;C 在该示例拓扑下延迟、服务恢复和覆盖语义不达标,且独立 Pin 并不自动提供修复时限。B 的容量、正常延迟和两项恢复指标均过线,且须以故障版本校验结果证明已确认写入未丢失。只有多方案都过线时,才继续用成本、运维复杂度等软指标评分。
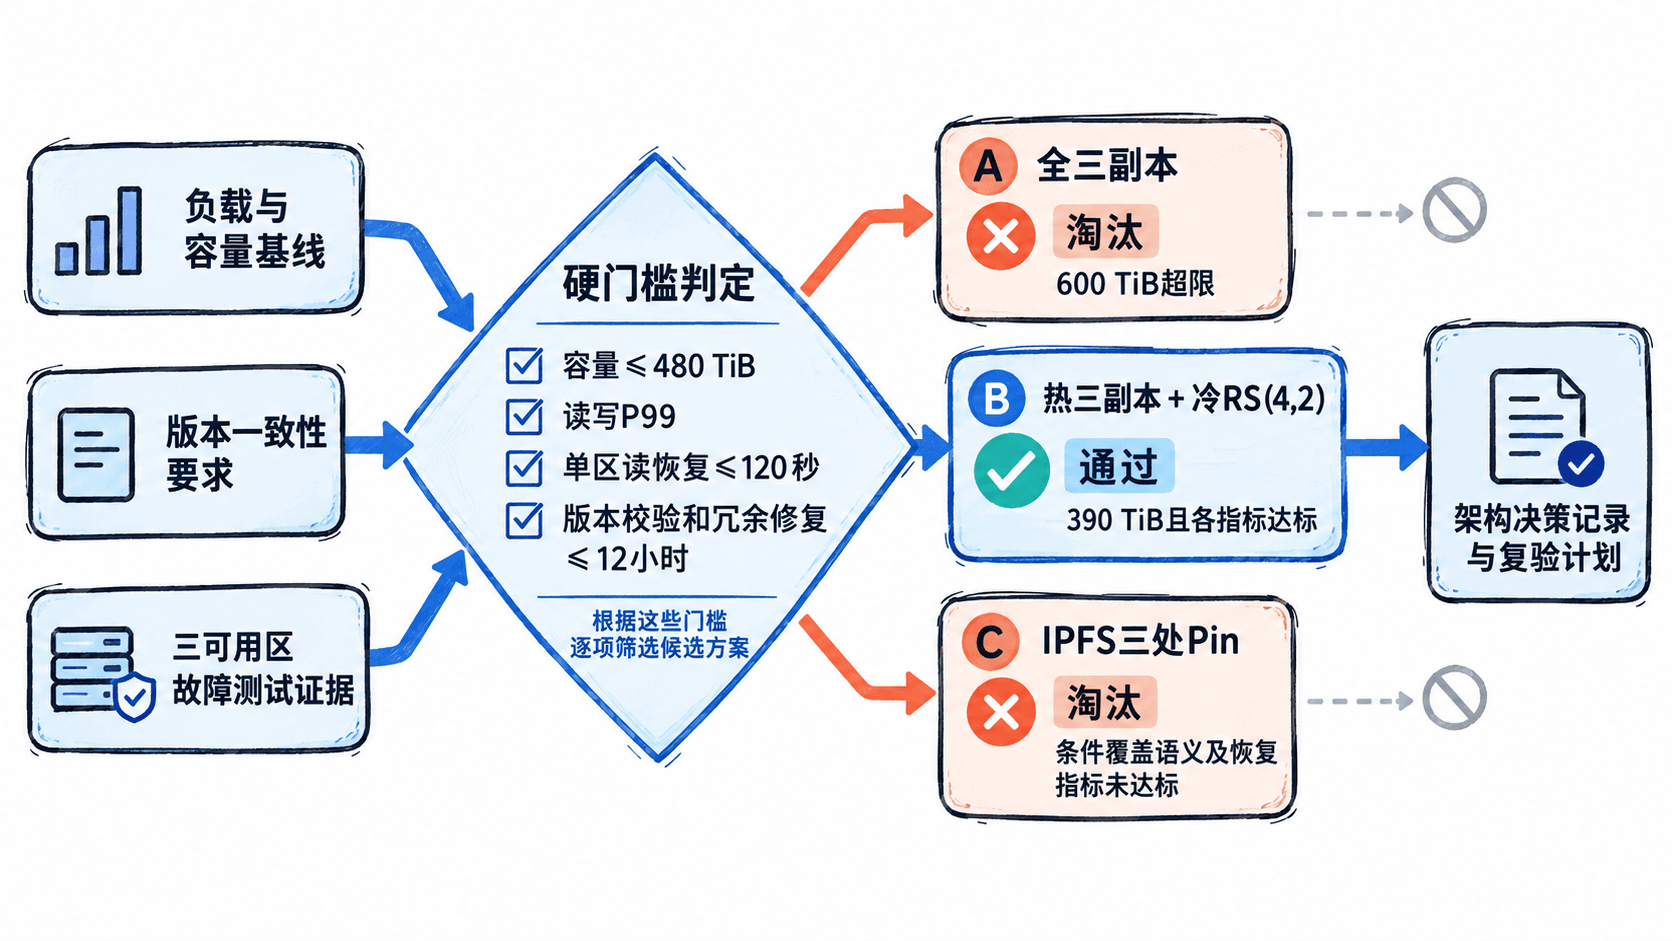
去中心化方案不是一概不可用:公开、不可变、可按 CID 校验且允许异步获取的资源,适合以 IPFS 分发;但若要承诺覆盖写的一致性、确定的恢复时限和副本保留,就必须另建可信元数据、固定副本策略及监控,并重新实测,不能直接套用本次 C 的结果。
写成可复验的决策记录
报告的决策段可以直接写成:ADR-08(教学示例):采用 B 作为主存储;A 因容量超限排除;C 仅保留为公开不可变内容的分发候选。 附上决策日期、负责人、版本、原始证据索引与未解决风险,不将教学数字写成正式实测结论。
实施约束也必须写进同一份记录:热对象放三份、三个可用区各一份;冷对象用 RS(4,2),六片置于六个不同节点,每个可用区两片;单区失联后仍剩四片可解码。元数据多数派跨可用区部署,只有数据持久化条件满足且新版本元数据提交后才能确认 PUT。对象连续 30 天未读可进入冷迁移候选;回热阈值暂定连续 3 天每天超过 10 次 GET,均需以真实热度分布复核。
冷热迁移采用“写入目标布局、校验片与版本、条件提交读取映射、延后回收旧布局”的次序;若提交前对象版本变化,取消本次切换并重试,不能让迁移覆盖新写入。修复任务保留前台请求优先级,故障下还须复核降级读 P99 ≤300 ms。
最后规定重新决策的触发器:任何已确认写丢失立即否决;任一恢复时限越线或最满可用区的剩余可分配容量低于 30 TiB,启动复评。在全部新增 5 TiB/月都进入冷区、其他占用不变的简化假设下,物理占用每月增加 7.5 TiB,当前 90 TiB 余量约 8 个月后降到 30 TiB。这样报告不仅说清今天为什么选 B,也说明何时必须重新测量并调整方案。