
P2P 与分布式存储 / 系统课时
用 Python 搭建三节点存储模拟器
用 Python 搭建三节点存储模拟器
这一节用一个可直接运行的 Python 程序搭出三个彼此独立的存储节点,并提供 PUT、GET、DELETE 与状态查询接口。完成后可以明确看到对象实际落在哪个节点、节点当前保存哪些对象,以及读写成功或失败的原因,为后续副本、分片和节点故障实验提供统一底座。
学习目标
- 用独立对象表示
storage-1、storage-2、storage-3三个存储节点,并维护各自的对象集合与在线状态。 - 实现可验证的对象写入、读取、删除和状态查询接口,区分对象不存在与节点不可用两类失败。
- 运行固定实验数据,检查对象归属、节点状态和操作结果是否符合预期。
定义最小三节点模型
模拟器先只保留后续实验真正需要的状态:节点名、是否在线、对象键值集合。不要一开始加入网络延迟、复制协议或磁盘文件,否则很难判断后续实验中的现象究竟来自哪一层。
三个节点分别命名为 storage-1、storage-2、storage-3。每个节点使用独立的 Python 字典保存对象,因此向一个节点写入数据不会自动影响另外两个节点。
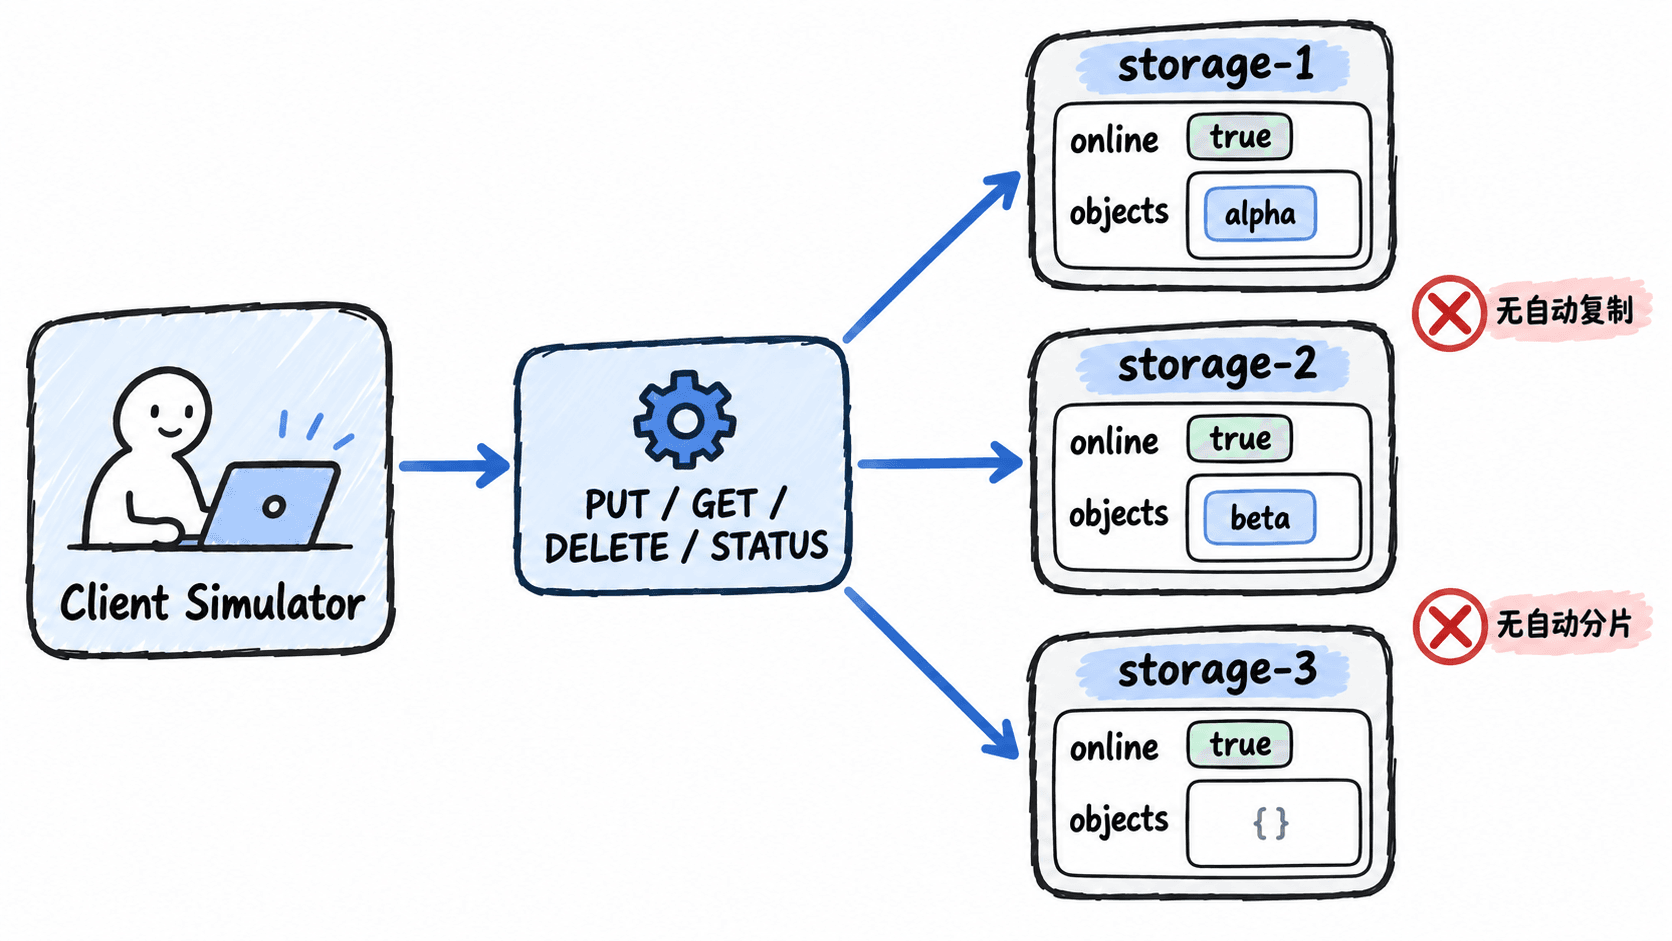
下面的程序只使用 Python 标准库,适用于 Python 3.10 及以上版本。StorageNode 负责单节点行为,StorageCluster 只负责按节点名称寻找目标节点,不替读写操作做自动路由。
from dataclasses import dataclass, field
from typing import Dict


@dataclass
class StorageNode:
    name: str
    online: bool = True
    objects: Dict[str, str] = field(default_factory=dict)

    def put(self, key: str, value: str) -> str:
        if not self.online:
            return f"PUT {key} -> {self.name}: NODE_UNAVAILABLE"
        self.objects[key] = value
        return f"PUT {key} -> {self.name}: OK"

    def get(self, key: str) -> str:
        if not self.online:
            return f"GET {key} <- {self.name}: NODE_UNAVAILABLE"
        if key not in self.objects:
            return f"GET {key} <- {self.name}: NOT_FOUND"
        return f"GET {key} <- {self.name}: {self.objects[key]}"

    def delete(self, key: str) -> str:
        if not self.online:
            return f"DELETE {key} @ {self.name}: NODE_UNAVAILABLE"
        if key not in self.objects:
            return f"DELETE {key} @ {self.name}: NOT_FOUND"
        del self.objects[key]
        return f"DELETE {key} @ {self.name}: OK"


class StorageCluster:
    def __init__(self) -> None:
        self.nodes = {
            name: StorageNode(name)
            for name in ("storage-1", "storage-2", "storage-3")
        }

    def node(self, name: str) -> StorageNode:
        if name not in self.nodes:
            raise ValueError(f"unknown node: {name}")
        return self.nodes[name]

    def status(self) -> None:
        for node in self.nodes.values():
            keys = sorted(node.objects.keys())
            print(f"{node.name}: online={node.online}, objects={keys}")


def main() -> None:
    cluster = StorageCluster()

    # 当前阶段由调用者显式决定对象写入哪个节点,便于观察真实归属。
    print(cluster.node("storage-1").put("alpha", "A-v1"))
    print(cluster.node("storage-2").put("beta", "B-v1"))

    print(cluster.node("storage-1").get("alpha"))
    print(cluster.node("storage-3").get("alpha"))
    cluster.status()


if __name__ == "__main__":
    main()
预期输出:
PUT alpha -> storage-1: OK
PUT beta -> storage-2: OK
GET alpha <- storage-1: A-v1
GET alpha <- storage-3: NOT_FOUND
storage-1: online=True, objects=['alpha']
storage-2: online=True, objects=['beta']
storage-3: online=True, objects=[]
这里最重要的现象是最后一次读取返回 NOT_FOUND。虽然 alpha 已经存在于整个实验环境里,但它只被写进了 storage-1;读取 storage-3 不应该凭空得到这个对象。这个行为正好为后续“为什么需要复制或分片路由”留下明确基线。
区分对象不存在与节点不可用
存储实验中不能把所有失败都表示成 None。对象不存在意味着节点正常工作但没有对应键;节点不可用则意味着根本无法向该节点完成本次访问。两种情况在真实系统中的恢复策略完全不同。
可以在 main() 中暂时加入下面的故障注入代码。它复用上面的完整类定义,因此属于片段示例,应放在首次状态检查之后运行。
node1 = cluster.node("storage-1")
node1.online = False

print(node1.get("alpha"))
print(node1.put("gamma", "G-v1"))
print(cluster.node("storage-2").get("gamma"))
预期输出:
GET alpha <- storage-1: NODE_UNAVAILABLE
PUT gamma -> storage-1: NODE_UNAVAILABLE
GET gamma <- storage-2: NOT_FOUND
这三个结果分别说明:已有对象可能因为节点离线而暂时无法读取;写入离线节点不会成功;失败的写入也不能让其他节点自动获得 gamma。后续实现副本时,可以直接用同一组结果检查故障容忍是否真的发生了变化。
检查对象归属和删除行为
除了看操作返回值,还要检查节点内部实际保存了什么。对于这个最小模型,可以把“对象归属”定义为:某个键当前出现在哪些节点的 objects 字典中。当前还没有副本机制,因此正常情况下一个测试对象只应出现在你明确写入的目标节点。
在 StorageCluster 中加入下面的方法即可查询归属。该代码是片段示例,依赖前面的 StorageCluster 定义。
def owners(self, key: str) -> list[str]:
    return [
        node.name
        for node in self.nodes.values()
        if key in node.objects
    ]
把方法加入类后,在节点均保持在线的实验中执行:
cluster = StorageCluster()
cluster.node("storage-1").put("photo-001", "binary-placeholder")

print(cluster.owners("photo-001"))
print(cluster.node("storage-1").delete("photo-001"))
print(cluster.owners("photo-001"))
预期输出:
['storage-1']
DELETE photo-001 @ storage-1: OK
[]
如果第一次归属查询出现两个或三个节点,说明程序已经发生了隐式复制,不再是本节要求的基线模型。如果删除后仍能查到 storage-1,则说明删除逻辑没有真正修改节点数据。
用固定验收条件保存实验基线
完成模拟器后,不要只确认“程序能运行”。后续复制、分片和故障注入都会在这个模型上增加行为,因此现在应固定一组可重复检查的验收条件。
建议保留以下四项基线:写入 alpha 到 storage-1 后只有该节点拥有它;从 storage-3 读取 alpha 返回 NOT_FOUND;将 storage-1.online 设为 False 后读取返回 NODE_UNAVAILABLE;删除一个对象后归属列表变为空。
还应确保三个节点持有的是三个独立字典。下面这个检查可直接发现误把同一个字典传给多个节点的实现错误。
cluster = StorageCluster()

print(cluster.node("storage-1").objects is cluster.node("storage-2").objects)
print(cluster.node("storage-2").objects is cluster.node("storage-3").objects)
预期输出:
False
False
得到这组结果后,三节点实验环境就具备了清晰的初始语义:节点彼此独立、对象位置可检查、故障状态可注入、失败原因可区分。后续无论加入多副本还是按哈希分片,都可以通过对比这套基线判断新机制究竟改变了哪些行为。