
P2P 与分布式存储 / 系统课时
哈希分片怎样定位数据所属节点
哈希分片怎样定位数据所属节点
给定一个对象键,网关需要稳定找到负责存储它的节点,扩容时又不能让大量对象无谓搬家。这里采用“稳定哈希 → 固定逻辑分片 → 可更新路由表”三级定位,用 12 个分片、3 至 4 个节点的实例验证路由结果,并明确在线迁移的安全顺序。
学习目标
- 将对象键映射为固定范围的逻辑分片编号。
- 使用分片路由表确定负责节点,判断扩容后的归属变化。
- 计算迁移比例,并识别哈希均匀分布不等于负载均匀。
哈希先决定逻辑分片
约定对象键为 UTF-8 字符串,使用 SHA-256 得到 256 位无符号整数,再对固定的分片数取模。设分片数为 12,则路由规则为:
这里 是完整对象键, 必然位于 0~11。所有网关必须使用相同的编码、哈希算法和分片数;Python 内置的 hash() 不适合持久路由,因为不同进程的字符串哈希值可能不同。
多个对象可以落入同一个分片,但分片内仍以完整对象键区分数据,不能只存哈希值。对象名大小写、路径分隔符或 Unicode 规范化规则一旦变化,都可能导致路由位置改变,应在客户端和网关之间统一约定。
路由表再决定存储节点
不要直接用“哈希值对当前节点数取模”选择物理节点,而是先确定固定的逻辑分片,再查分片归属表。以下表格表示每个分片的主负责节点,副本放置是另一层决策。
| 逻辑分片 | 扩容前归属 | 扩容后归属 |
|---|---|---|
| 0~2 | A | A |
| 3 | A | D |
| 4~6 | B | B |
| 7 | B | D |
| 8~10 | C | C |
| 11 | C | D |
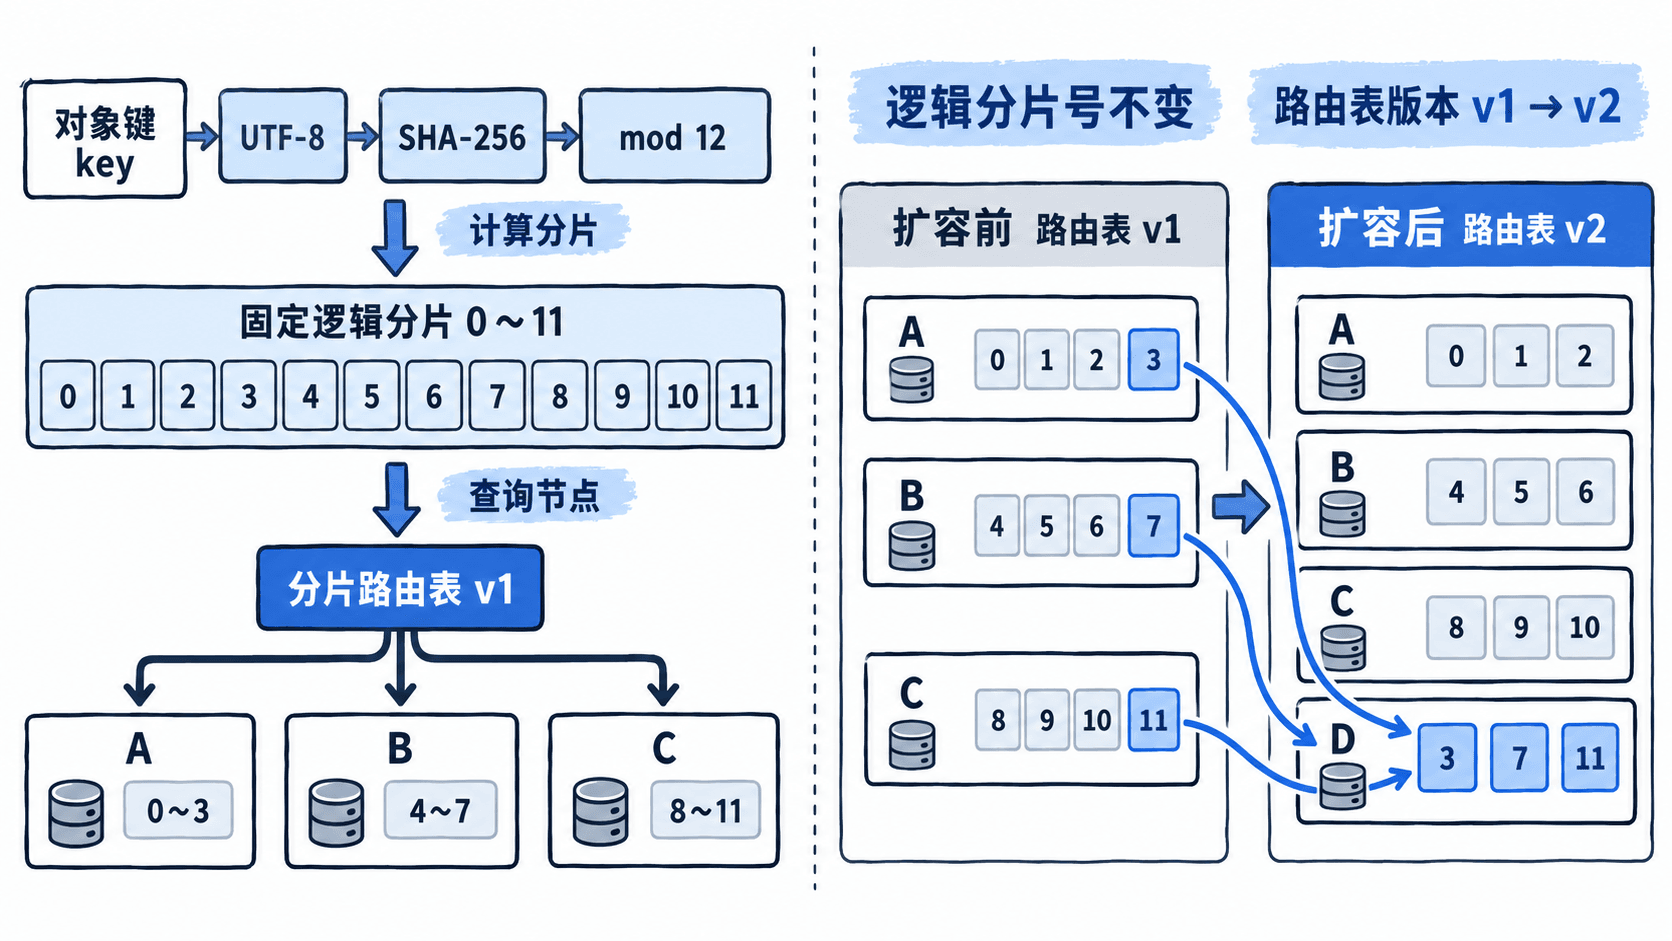
比如键 obj/1007 哈希后落到分片 3。扩容前查询路由表返回 A,扩容后返回 D;键的哈希值和分片号都没有变化。路由表可由元数据服务发布并带版本号,避免不同网关长期使用不一致的归属信息。
用 Python 验证定位结果
以下程序只模拟路由,不执行真实的数据拷贝。使用 Python 3.8+ 标准库即可运行;修改节点映射不会更改对象的逻辑分片号。
import hashlib

SHARD_COUNT = 12
keys = ["obj/1004", "obj/1001", "obj/1002", "obj/1007"]
owners_v1 = {
    i: ("A" if i < 4 else "B" if i < 8 else "C")
    for i in range(SHARD_COUNT)
}
owners_v2 = owners_v1.copy()
for shard in (3, 7, 11):
    owners_v2[shard] = "D"

def route(key, owners):
    # 哈希算法、字符编码和分片数在路由版本之间保持不变
    digest = hashlib.sha256(key.encode("utf-8")).digest()
    shard = int.from_bytes(digest, "big") % SHARD_COUNT
    return shard, owners[shard]

for key in keys:
    shard, old_node = route(key, owners_v1)
    _, new_node = route(key, owners_v2)
    print(f"{key}: shard={shard}, old={old_node}, new={new_node}")

# 迁移清单由路由表差集生成,而不是重新哈希全部对象
changed = sum(owners_v1[i] != owners_v2[i] for i in range(SHARD_COUNT))
print(f"changed_shards={changed}/{SHARD_COUNT}")
预期输出:
obj/1004: shard=0, old=A, new=A
obj/1001: shard=4, old=B, new=B
obj/1002: shard=8, old=C, new=C
obj/1007: shard=3, old=A, new=D
changed_shards=3/12
分片 3、7、11 的归属改变,共需迁移 3/12,即 25% 的逻辑分片。如果改用哈希值直接对节点数取模,那么节点编号从 0~2 增至 0~3 时,在哈希值均匀的前提下,约 75% 的键会映射到不同编号,扩容代价显著更高。
在线扩容要先迁数据再切路由
上例中的 owners_v2 只是目标路由表。若先发布新表再拷贝数据,针对分片 3 的读取会立刻访问 D,而 D 可能还没有对象。因此实际切换至少需要以下顺序:
- 保留 v1 路由,指定 A→D 的分片 3、B→D 的分片 7、C→D 的分片 11 为迁移清单;初始复制期间旧节点继续处理业务请求。
- 追平复制期间产生的增量写入,校验分片对象数量、校验和与写入序号。简化实现可在最终切换时短暂停止这些分片的写入,并等待在途操作完成。
- 原子发布路由表 v2,让新请求访问 D;针对持有旧路由的网关提供版本失效重试或旧节点转发,避免切换窗口读错位置。
- 验证读写和副本健康状态,再回收旧节点上的分片数据;切换失败时按约定版本回滚,而不是直接删除新副本。
这套步骤必须与具体存储系统的写入确认和一致性协议配合;只更新归属表不会自动搬运对象,也不能保证迁移期间读写正确。
分片数与均匀性怎样取舍
12 个逻辑分片放在 3 个节点上,每节点 4 个;扩到 4 节点后每节点 3 个。若有 120 万个大小相近且均匀散列的对象,平均每分片约 10 万个,但实际大小和访问次数不一定均匀。一个分片含热门对象,仍可能把负责节点打满。
分片数过小,扩容只能一次挪动大块数据;分片数过多,路由项、迁移任务和元数据维护成本增加。例如 4096 个分片分布在 32 个节点上,平均每节点 128 个分片,便于细粒度调整,但不能仅凭这个数字决定生产配置。上线前应测量每分片的字节数、读写 QPS 和迁移耗时,按三项指标重新分配归属,而不只数分片个数。
如果把固定分片数直接从 12 改为 16,大量对象的分片编号也会变化。这不能仅靠修改节点归属表完成,而需要重新分片和数据迁移。因此应提前规划逻辑分片数量,节点扩容时优先调整已有分片的归属,不要每次增加节点都改变取模基数。
固定逻辑分片的价值在于:对象到分片的计算不变,扩容主要改变少量分片到节点的映射。副本策略还须独立确保同一分片的副本分布在不同故障域,不能把主归属表误当作全部副本的位置表。