
P2P 与分布式存储 / 系统课时
副本与纠删码该如何按冷热数据组合
副本与纠删码该如何按冷热数据组合
当小对象频繁覆盖、大对象长期只读时,统一采用三副本会浪费容量,全部改成纠删码又可能拉高写入尾延迟。可以先用可观测的读写负载划分冷热区,再比较容量、故障域和延迟,最终得到可验证、可回滚的混合布局。
学习目标
- 根据对象大小、覆盖频率和访问时延要求划分热数据与冷数据。
- 计算三副本与 4+2 纠删码的容量和节点失效边界。
- 用同条件性能实验制定选型门槛,并设计安全的冷热迁移。
先把访问模式量化
以下是一个假设的 100 TiB 逻辑数据集,数值仅用于演示选型过程,不是冷热划分的行业固定阈值。
| 维度 | 热区 | 冷区 |
|---|---|---|
| 逻辑容量与典型对象 | 20 TiB;256 KiB | 80 TiB;64 MiB |
| 请求模式 | 每秒 300 次整对象覆盖 PUT、500 次 GET | 每秒 30 次顺序 GET,30 天无覆盖写 |
| 正常状态时延目标 | 覆盖 PUT 的 p99 ≤30 ms | 完整 GET 的 p99 ≤200 ms |
| 候选布局 | 三副本 | 4+2 Reed–Solomon 纠删码 |
对象年龄不能单独决定冷热:一份 30 天没修改但每天被读取几千次的文件,可能仍要求低延迟;一份从不读取却持续被小幅修改的对象,也不适合直接迁入写放大较高的布局。应从请求日志统计对象大小的 P50/P95、每对象读写次数、整对象覆盖比例、读写字节数及 p99 延迟,并至少覆盖业务高峰。
这里的 PUT 表示对象接口的整对象覆盖,不要把它等同于块存储中的 4 KiB 原地修改;后者涉及额外的局部写机制和不同的放大成本。
算出容量收益与故障边界
三副本的理论物理容量是逻辑数据的 3 倍。4+2 纠删码将数据拆成 4 个数据片、2 个校验片,理论容量放大是 6÷4=1.5 倍;在任意 2 片不可用且其余分片健康时,仍可恢复原数据。
下面的 Python 3 示例只计算理论存储占用,未包含元数据、分片填充、快照、修复预留和迁移期间的双份数据。
# 单位为 TiB;按数据冷热比例对不同布局计费
hot, cold = 20, 80
ec_factor = (4 + 2) / 4
layouts = {
    "全三副本": (3, 3),
    "全4+2纠删码": (ec_factor, ec_factor),
    "冷热组合": (3, ec_factor),
}
for name, (hot_factor, cold_factor) in layouts.items():
    total = hot * hot_factor + cold * cold_factor
    print(f"{name}: {total:.0f} TiB")
预期输出:
全三副本: 300 TiB
全4+2纠删码: 150 TiB
冷热组合: 180 TiB
冷热组合相比全三副本少占 120 TiB(40%),但比全纠删码多占 30 TiB;多出来的容量是在购买热区的覆盖写性能与较简单的读取路径。
容错比较必须指定故障域:三副本至少放在 3 个独立节点上,4+2 的 6 个分片至少分散到 6 个独立节点上,才能把“两节点失效仍可读”作为此示例的验收条件。若要承受两个机架同时故障,必须重新按机架布置分片,而不是将节点级的容错数字直接照搬。
在同一负载下检验时延与恢复
用同型号磁盘、6 个存储节点、相同客户端并发和 10 GbE 网络分别测试两种布局。每组先预热 10 分钟,再记录 30 分钟;覆盖写固定 300 次/秒,冷区顺序读固定 30 次/秒,并在独立轮次注入一个存储节点故障。
| 观测指标 | 三副本 | 4+2 纠删码 | 验收门槛 |
|---|---|---|---|
| 256 KiB 覆盖 PUT p99 | 18 ms | 52 ms | 热区 ≤30 ms |
| 64 MiB 完整 GET p99 | 115 ms | 155 ms | 冷区 ≤200 ms |
| 节点故障后冷区 GET p99 | 130 ms | 265 ms | 降级读 ≤300 ms |
表中数值是教学假设的实验记录,不代表任何特定产品的真实性能。按这份记录,热区不能使用当前 4+2 配置,而冷区在正常读与降级读条件下均通过。正式选型还需记录实际吞吐、CPU、跨节点网络流量、重建完成时间,并验证修复时的业务 p99;例如给单节点修复设定 6 小时上限,再确认限速后仍能达到。
让冷热切换成为有版本保护的迁移
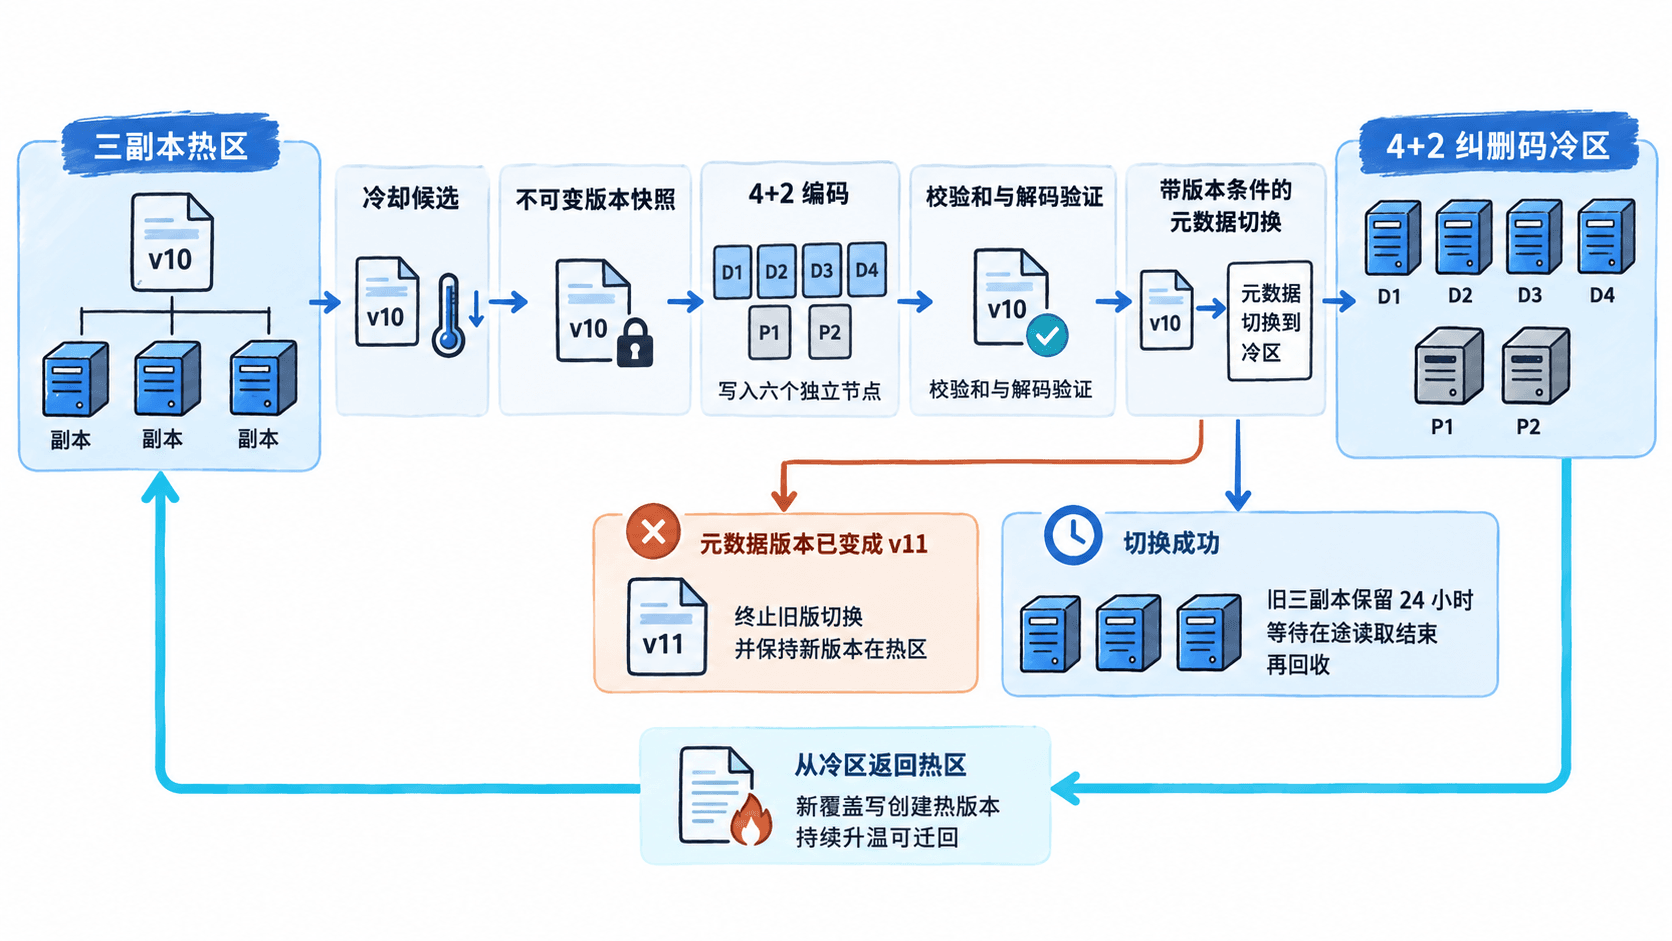
可以先把“连续 14 天无覆盖、最近 7 天读取不超过 7 次且对象至少 1 MiB”设为候选冷却规则,再依据实际对象大小分布和编码效率调整,不能把 1 MiB 当作普适的纠删码分界线。
- 记录对象的不可变版本,例如
v10,按该版本读取完整内容,避免编码过程中混入并发覆盖数据。 - 在 6 个独立节点生成并持久化 4 个数据片和 2 个校验片,核验分片校验和与可解码性。
- 通过带版本条件的元数据提交,把
v10的读取位置从三副本切到纠删码;若已有新版本v11,放弃这次旧版本位置切换。 - 切换成功后暂留旧副本,例如保留 24 小时并确认在途读取结束,再回收;失败则仍通过旧副本服务。
- 后续覆盖写生成新的热区版本;如果只是读取次数上升,优先评估缓存,持续变热后再迁回三副本,避免频繁往返。
用容量与服务指标一起定案
对这份样例,推荐热区使用三副本、冷区使用 4+2,并把切换规则作为可调整策略。上线验收至少同时满足:热区覆盖 PUT p99 ≤30 ms、冷区完整 GET p99 ≤200 ms、单节点故障后冷区 GET p99 ≤300 ms、修复时间 ≤6 小时,以及按节点故障域进行两节点失效演练。
容量预算不能直接按 180 TiB 采购:若规划长期利用率不超过 70%,仅按理论编码占用计算就需要至少 180÷0.7≈257.1 TiB 的物理容量,还要进一步核算小对象与条带尾部开销、迁移双份数据、元数据和修复安全余量。若实测读写 p99 或故障恢复不达标,应调整编码参数、冷却阈值或保留更多热副本,而不是仅按理论节省量决定布局。