
P2P 与分布式存储 / 系统课时
缺失分片时如何完成降级读取
缺失分片时如何完成降级读取
对象采用系统化的 3+1 XOR 编码后,单个数据片失联并不代表对象无法读取。本课以 D1 超时为例,重建一个 12 字节对象,并用可运行的 Python 模型比较完整读取和范围读取在正常与降级状态下的网络流量及响应延迟。
学习目标
- 识别 3+1 编码中哪些分片足以恢复缺失的数据片。
- 重放 D1 超时、补读校验片、解码和返回对象的完整过程。
- 分别计算完整读取与 4 字节范围读取的有效载荷、请求数和模型延迟。
确定分片布局和恢复边界
示例对象为 ABCDEFGHIJKL,按每片 4 字节切成三个原始数据片,再生成一个 XOR 校验片;总存储量为 16 字节,较原始数据增加 33.3%。这是便于观察原理的单校验片模型,不是可容忍多片丢失的 Reed–Solomon 方案。
| 分片 | 内容 | 大小 |
|---|---|---|
| D0 | ABCD |
4 B |
| D1 | EFGH |
4 B |
| D2 | IJKL |
4 B |
| P0 | D0 XOR D1 XOR D2 |
4 B |
正常完整读取直接获取 D0、D1、D2。若 D1 不可用,则从 D0、D2、P0 按字节异或还原:
这要求三个参与恢复的分片属于同一编码条带、长度及版本一致。若仅 P0 不可用而三个数据片仍在,当前读取无需解码;若同时缺失两个片,3+1 XOR 已无法保证恢复。
追踪超时、补读与解码时序
假设三个数据片并行读取,健康分片耗时 8 ms;不可用分片在 12 ms 判定超时;校验片补读耗时 8 ms;本地 XOR 解码耗时 2 ms。这些数值是演示用的确定性时延,不是实测网络性能。
- **0 ms:**客户端请求完整对象,协调器同时向 D0、D1、D2 发起读取。
- **8 ms:**D0 返回
ABCD,D2 返回IJKL;两片先暂存,D1 尚无结果。 - **12~20 ms:**D1 超时后,协调器向 P0 补发请求,20 ms 得到校验片;不必再次下载已有的 D0、D2。
- **20~22 ms:**按字节异或恢复 D1=
EFGH,按 D0、D1、D2 顺序拼回对象并返回ABCDEFGHIJKL。
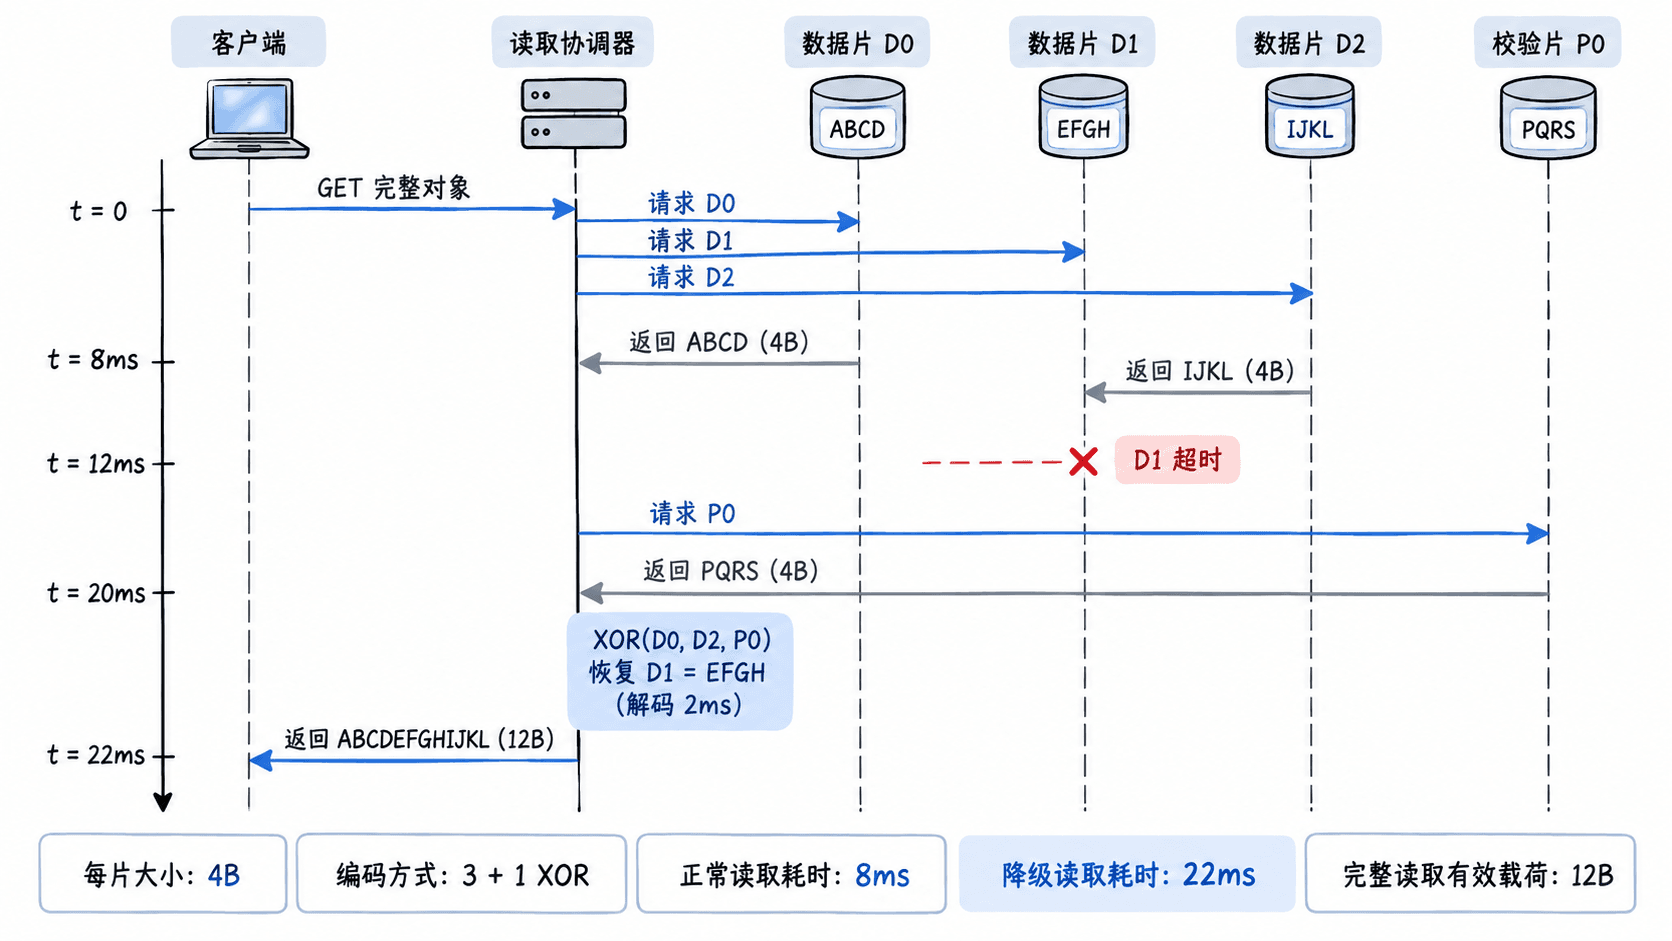
这里的“降级”指在读取路径上临时解码并返回结果,不等于已经将 D1 持久化修复;后台重建及重新放置应另行调度。
用 Python 重放完整读取和范围读取
将以下代码保存为 degraded_read.py,使用 Python 3.8 或更高版本运行。程序只用标准库和内存字节数组模拟并行读取的关键路径,不启动真实存储节点,也不以 sleep 伪装网络测量。
data = b"ABCDEFGHIJKL"
shards = [data[i:i + 4] for i in range(0, len(data), 4)]
store = {f"D{i}": shard for i, shard in enumerate(shards)}
# 系统码直接存原文,单个校验片逐字节异或生成。
store["P0"] = bytes(a ^ b ^ c for a, b, c in zip(*shards))

def read(partial=False, failed=None):
    targets = ["D1"] if partial else ["D0", "D1", "D2"]
    attempts = targets.copy()
    received = {name: store[name] for name in targets if name != failed}
    trace = ["读取 " + ",".join(received)] if received else []
    degraded = failed in targets
    if degraded:
        trace.append(f"{failed} 超时")
        # 仅补读缺少的恢复片,已读到的D0/D2不重复下载。
        extra = [name for name in ("D0", "D2", "P0") if name not in received]
        attempts.extend(extra)
        received.update({name: store[name] for name in extra})
        trace.append("补读 " + ",".join(extra))
        received["D1"] = bytes(a ^ b ^ c for a, b, c in
                               zip(received["D0"], received["D2"], received["P0"]))
        trace.append("XOR 恢复 D1")
    result = received["D1"] if partial else b"".join(received[f"D{i}"] for i in range(3))
    # 仅统计成功返回的分片载荷;失败请求仍计入请求数。
    transferred = sum(len(store[name]) for name in attempts if name != failed)
    latency = 12 + 8 + 2 if degraded else 8  # 并行请求的模型关键路径
    return result.decode(), transferred, len(attempts), latency, " → ".join(trace)

for partial in (False, True):
    for failed in (None, "D1"):
        value, nbytes, requests, ms, trace = read(partial, failed)
        label = ("范围" if partial else "完整") + "/" + ("降级" if failed else "正常")
        print(f"{label}: {value}, {nbytes} B, {requests} 次请求, {ms} ms")
        print(f"  {trace}")
预期输出:
完整/正常: ABCDEFGHIJKL, 12 B, 3 次请求, 8 ms
  读取 D0,D1,D2
完整/降级: ABCDEFGHIJKL, 12 B, 4 次请求, 22 ms
  读取 D0,D2 → D1 超时 → 补读 P0 → XOR 恢复 D1
范围/正常: EFGH, 4 B, 1 次请求, 8 ms
  读取 D1
范围/降级: EFGH, 12 B, 4 次请求, 22 ms
  D1 超时 → 补读 D0,D2,P0 → XOR 恢复 D1
计算流量放大并检查真实系统
这里的“范围”读取仅请求 D1 对应的对象偏移 4~7 字节。健康时读取 D1 的 4 B;D1 缺失时,必须读取 D0、D2、P0 共 12 B,有效载荷放大 3 倍。完整对象读取在本模型中无额外有效载荷:正常读取 D0+D1+D2 为 12 B,降级读取 D0+D2+P0 也为 12 B,但请求数从 3 次增至 4 次。
两种读取的降级延迟都是 12+8+2=22 ms,对比正常的 8 ms 增加到 2.75 倍。不要把这些数值当作生产环境的固定比例:HTTP/RPC 头部、超时重试、跨机架流量、并行调度、CPU 排队以及是否提前读取冗余片,都会改变实际流量和尾延迟。
验收时应在独立故障域中隔离 D1,核对正常与降级结果的 SHA-256 摘要一致,并分别采集成功传输的分片字节数、失败请求数、解码耗时及 p95 读取延迟。如果大量请求同时降级,还要检查校验片所在节点的出站带宽和解码线程是否成为新瓶颈。