
P2P 与分布式存储 / 系统课时
多数派日志如何保护元数据变更
多数派日志如何保护元数据变更
当分片路由、存储配额或副本位置发生变更时,只修改一台服务器的内存会让故障切换后的集群使用旧状态。这里用五节点 Raft 集群追踪一次元数据写入,明确何时允许返回成功,以及失去多数派时为什么必须暂停变更。
学习目标
- 解释领导者、日志索引、任期与多数派提交之间的关系。
- 判断五节点集群在节点故障和网络分区后的元数据写入能力。
- 区分日志已提交、状态机已应用和所有副本已同步。
把元数据变更记录为日志
假设元数据服务由 A、B、C、D、E 五个投票节点组成,A 是任期 8 的领导者。管理员把 bucket-a 的配额从 100 GiB 调整到 120 GiB。A 不应先修改本地配额再异步通知其他节点,而应先把这次操作记录为索引 42、任期 8 的日志项。
Raft 通过任期标识领导权,通过日志索引确定操作顺序。五节点集群的多数派为 5 // 2 + 1 = 3,按配置中的投票成员数计算,不能因为两个节点掉线就把门槛降为两票。被复制的是确定性的元数据变更命令;真正的对象数据不会因为元数据日志达成多数派就自动完成复制。
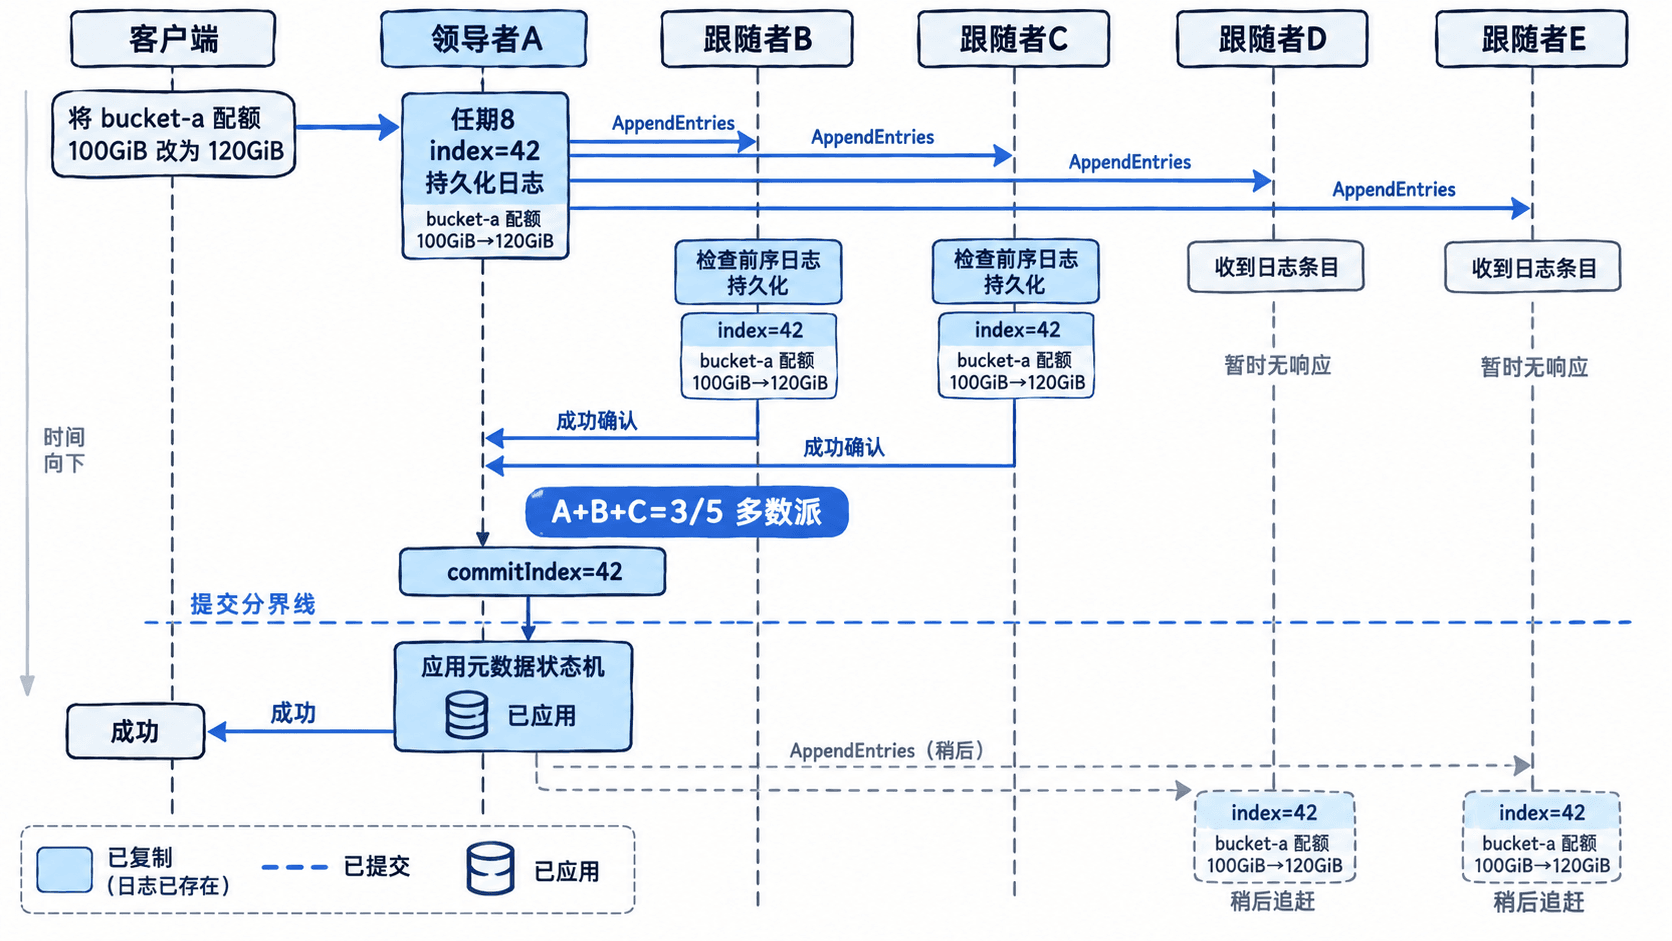
五节点提交一条日志的时序
- 客户端把配额变更发送给领导者 A。A 在本地追加并持久化任期 8、索引 42 的日志项。
- A 发送 Raft 的
AppendEntries请求。B、C 检查前序日志匹配后持久化该项并回复成功;D、E 暂时未响应。 - A、B、C 三份日志已覆盖五节点多数派。由于索引 42 属于 A 的当前任期,A 可将
commitIndex推进到 42。 - A 将已提交操作应用到本地元数据状态机,使配额变为 120 GiB,再向客户端确认成功;通过后续心跳通知其他节点提交进度,D、E 可以继续追赶。
故障和分区怎样改变写入能力
如果 A 在索引 42 提交后宕机,新领导者必须通过多数派选举;投票者会检查候选者的最后日志任期和索引,拒绝日志不够新的候选者。配合选举与日志匹配规则,已提交的配额变更不会被一个缺少它的新领导者覆盖。
假设随后网络分成 A、B 与 C、D、E 两组。旧领导者 A 即使仍接收请求,也只有两票,不得确认新的元数据写入;拥有三票的一侧在选出具备合格日志的新领导者后,才可继续提交。若索引 43 只存在于 A、B 且尚未提交,之后可能被新领导者的日志覆盖,客户端不能提前收到成功响应。
| 五节点可互通的投票节点数 | 能否形成多数派 | 对元数据写入的影响 |
|---|---|---|
| 5、4 或 3 | 能 | 有合格领导者时可以提交 |
| 2 或 1 | 不能 | 不能确认新变更 |
| 0 | 不能 | 不可提供服务 |
用最小程序检查提交门槛
下面的 Python 3 示例只验证票数门槛。假设确认节点都已持久化同一条当前任期日志项,且通过了 Raft 的日志匹配检查;它不是完整的 Raft 实现,也不模拟领导者选举。
members = {"A", "B", "C", "D", "E"}
quorum = len(members) // 2 + 1  # 固定由投票成员总数决定

for label, persisted in (
    ("A/B/C", {"A", "B", "C"}),
    ("A/B", {"A", "B"}),
):
    # 只统计该配置内、已持久化同一日志项的节点
    count = len(persisted & members)
    print(f"{label}: {count}/{len(members)}, "
          f"{'达到多数派' if count >= quorum else '不得提交'}")
预期输出:
A/B/C: 3/5, 达到多数派
A/B: 2/5, 不得提交
把成员集合改成三个节点,门槛会变成两票;改成七个节点,门槛会变成四票。生产实现还必须处理 currentTerm、matchIndex、日志持久化、成员变更和故障后的选举,不能只用计数代替 Raft 协议。
已提交不等于每个节点都读到新值
索引 42 被提交时,D、E 仍可能落后;即使某个节点已经保存日志,也不意味着它已把配额更新应用到状态机。元数据读取如果要求线性一致性,不能随意从落后的跟随者读取:可由领导者通过 ReadIndex 等机制确认当前领导权,并等待状态机应用到相应索引后再返回。
对于分片放置表、配额和版本号,建议记录 term、index、commitIndex、lastApplied 与各节点复制进度,以便排查“写入已确认但某节点仍显示旧值”。Raft 保证按规则提交的元数据日志不会因普通少数派故障而丢失,但不会替对象数据执行迁移、修复或跨节点复制。